先说一个让我对「任务成功」四个字彻底失去信任的现场。
我们的 QA Agent 接过一条 Slack 任务,跑完框架层大剌剌地标着 success。我翻 execution 记录:64 次工具调用,目标系统里一条用例都没写进去。细看更扎心——其中 20 次是参数一模一样的精确重复,占全部调用的 31.3%;重复返回往模型上下文里灌了约 1.62 MB,占全部工具结果体积的 64.1%。模型吭哧吭哧查了半小时资料,然后宣布收工。这就像同事把同一篇文档复印二十份铺满桌子,然后跟你说:活儿干完了。
另一次更阴。批量任务明明往用例系统里建了 10 条 case,逐项 fallback 的验证结果却没被认成整批完成——每一条单项验证都过了,但没有任何一个环节把「这批活整体交付了」登记下来。worker 重试时读了一眼 memory 里的「已生成」,直接跳过写入。同一件活儿,第一次干了没认账,第二次认账了没干。这两个故障互为镜像:一个是没有完成定义,一个是完成定义被一句没有主语的话顶替了。
这两件事让我确认了一件事:「模型最终回答了」「工具返回 success」「workflow completed」是三个完全不同的状态,谁都不能单独证明外部世界真的变了。框架层的 completed 是个心情指标,不是事实指标——它只保证流程走到了终点,不保证终点外面有什么。
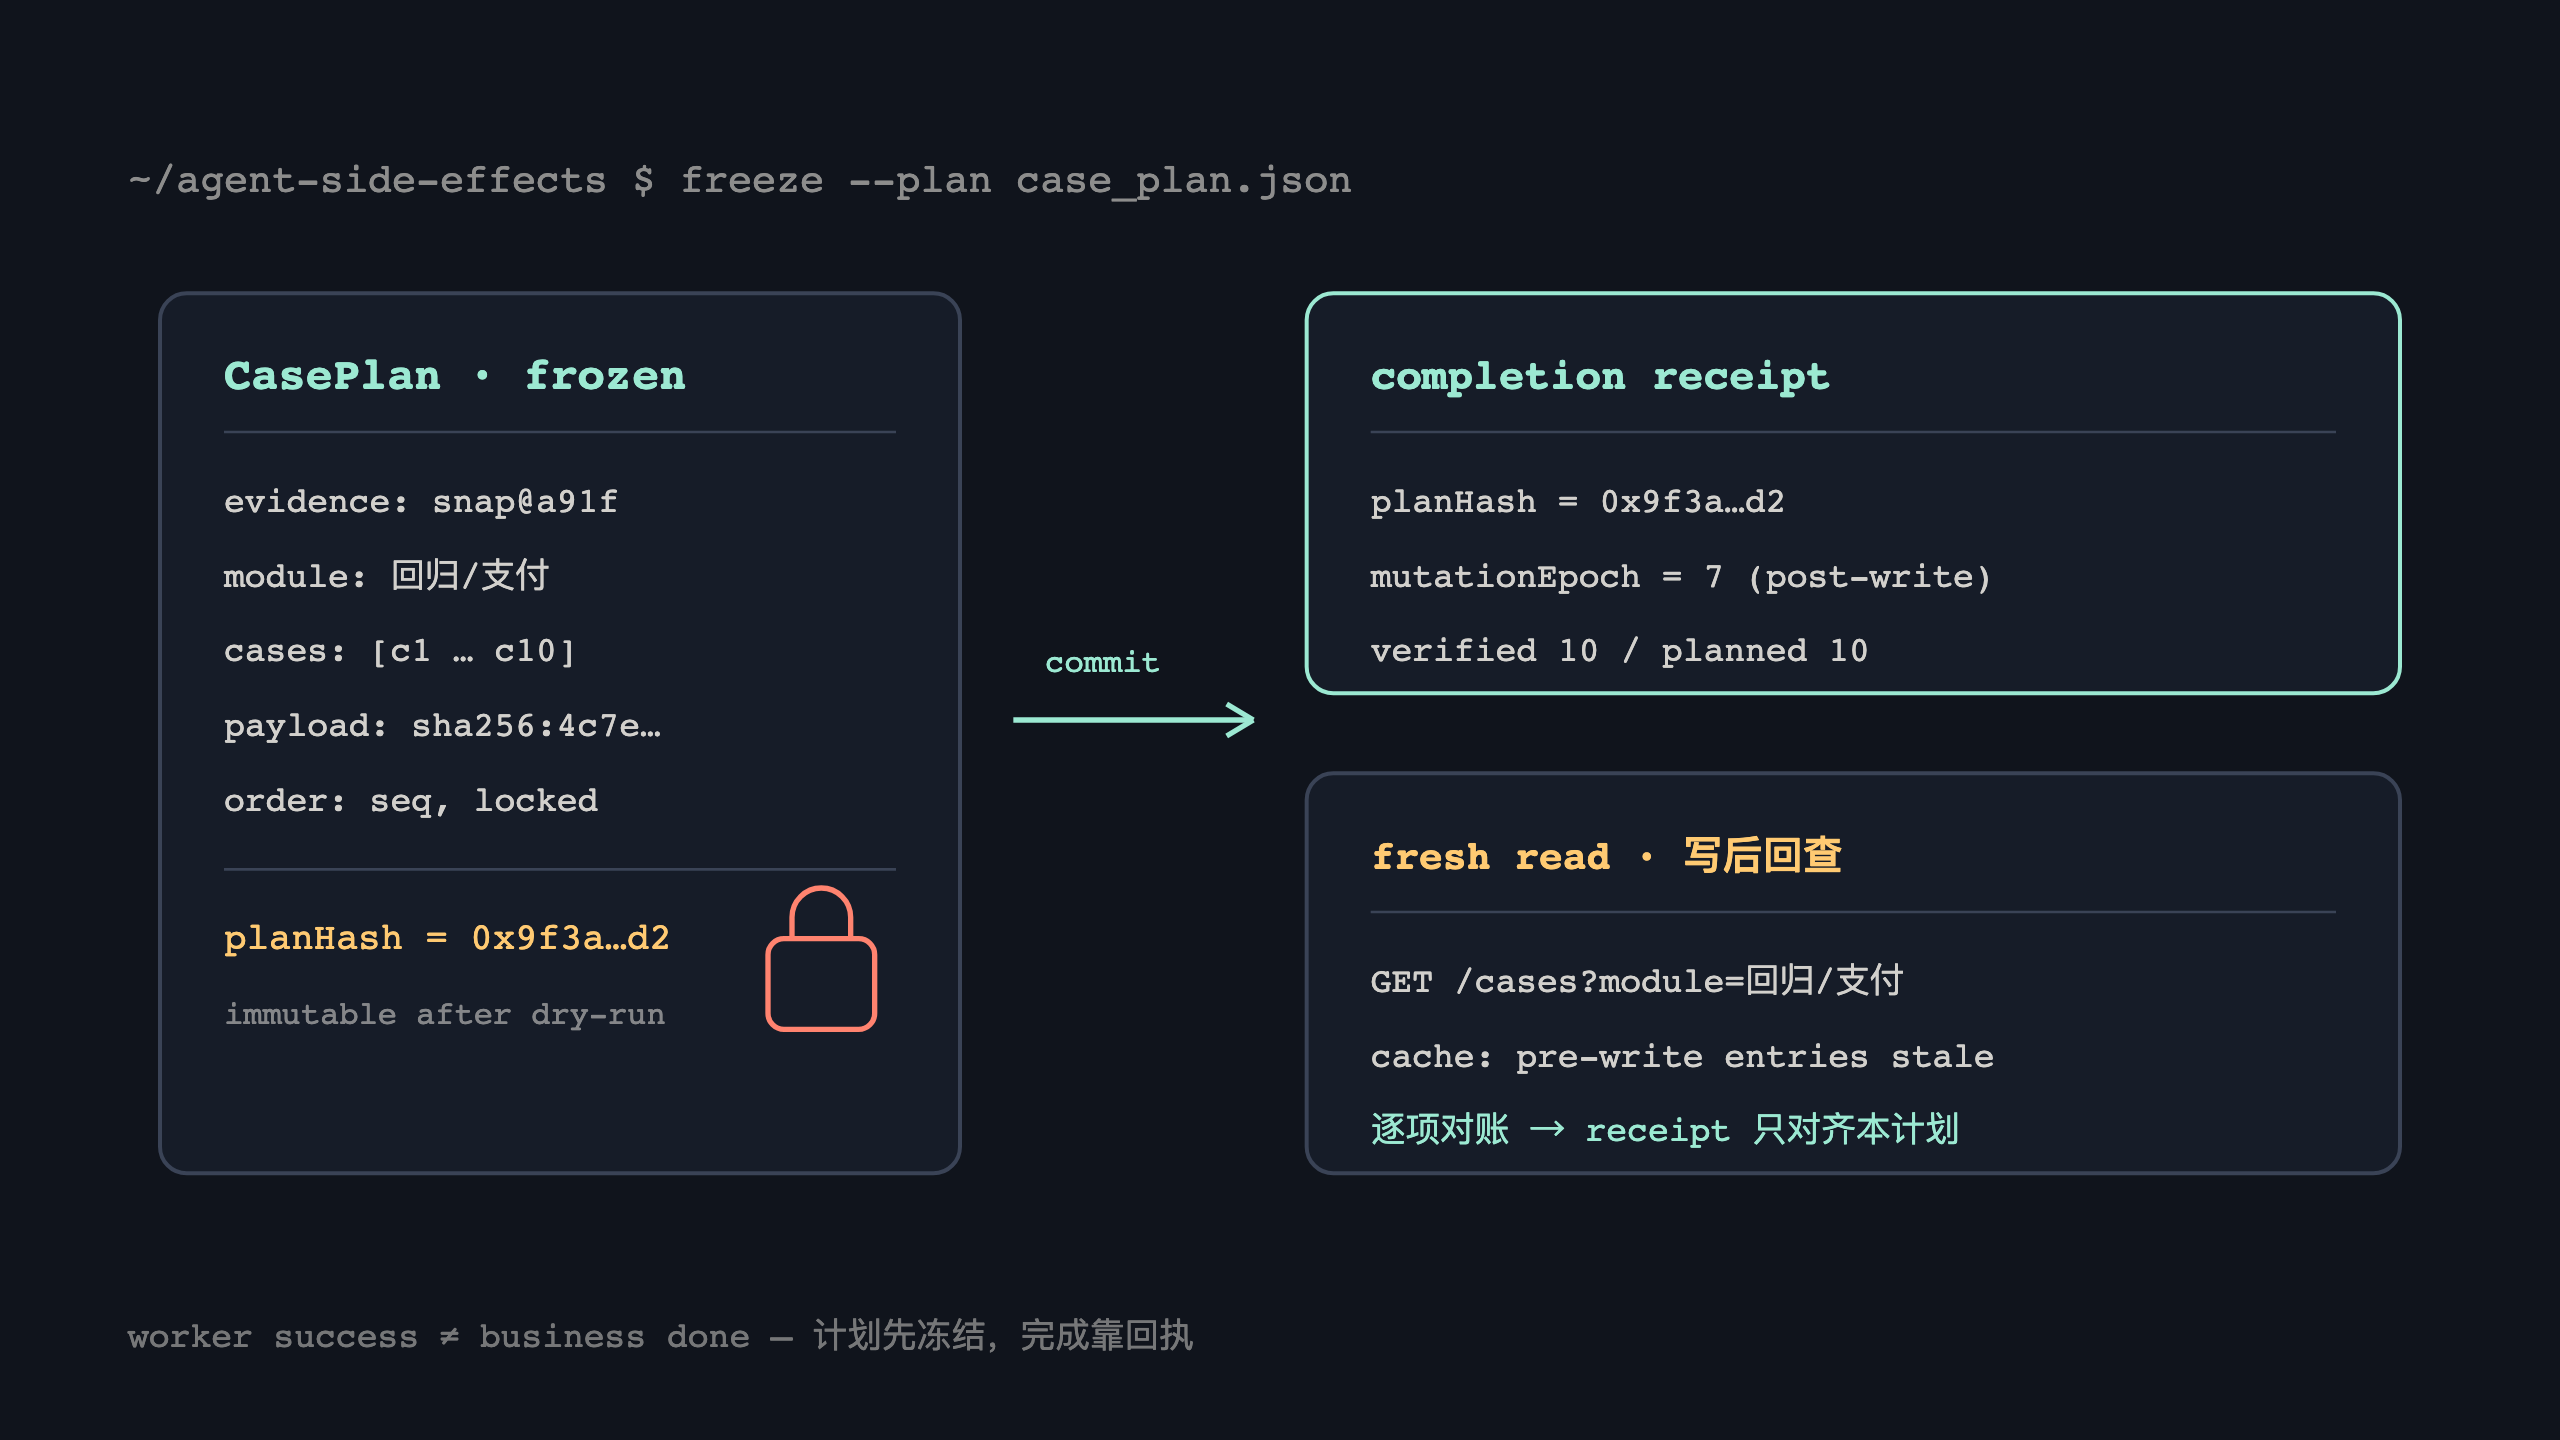
三种「成功」,互不担保
先把这三个状态掰开,因为后面所有设计都在给它们划界。
模型最终回答了:LLM 输出了一段「已完成」的文字。这是自我陈述,证据力约等于被告在法庭上说「我是无辜的」。
工具返回 success:某个 HTTP 调用拿到了 200。这是传输层收据,告诉你请求被受理了;它不回答「领域对象长对了没有」,更不回答「该做的事是否全做完了」。那 10 条 case 就是全员 success 的产物——每条写入都成功,整批完成却没人认账。
workflow completed:编排层走到了末端节点。这是流程状态,只说明没有节点崩到中断整个执行;中间关键工具死没死、写进去的东西对不对,它一概不管。
「写完没」这个问题,本质上是个对账题:计划要写的集合 vs 外部世界实际出现的集合。上面三个状态没有一个在回答这道题——而 Agent 系统默认拿第一个当答案。
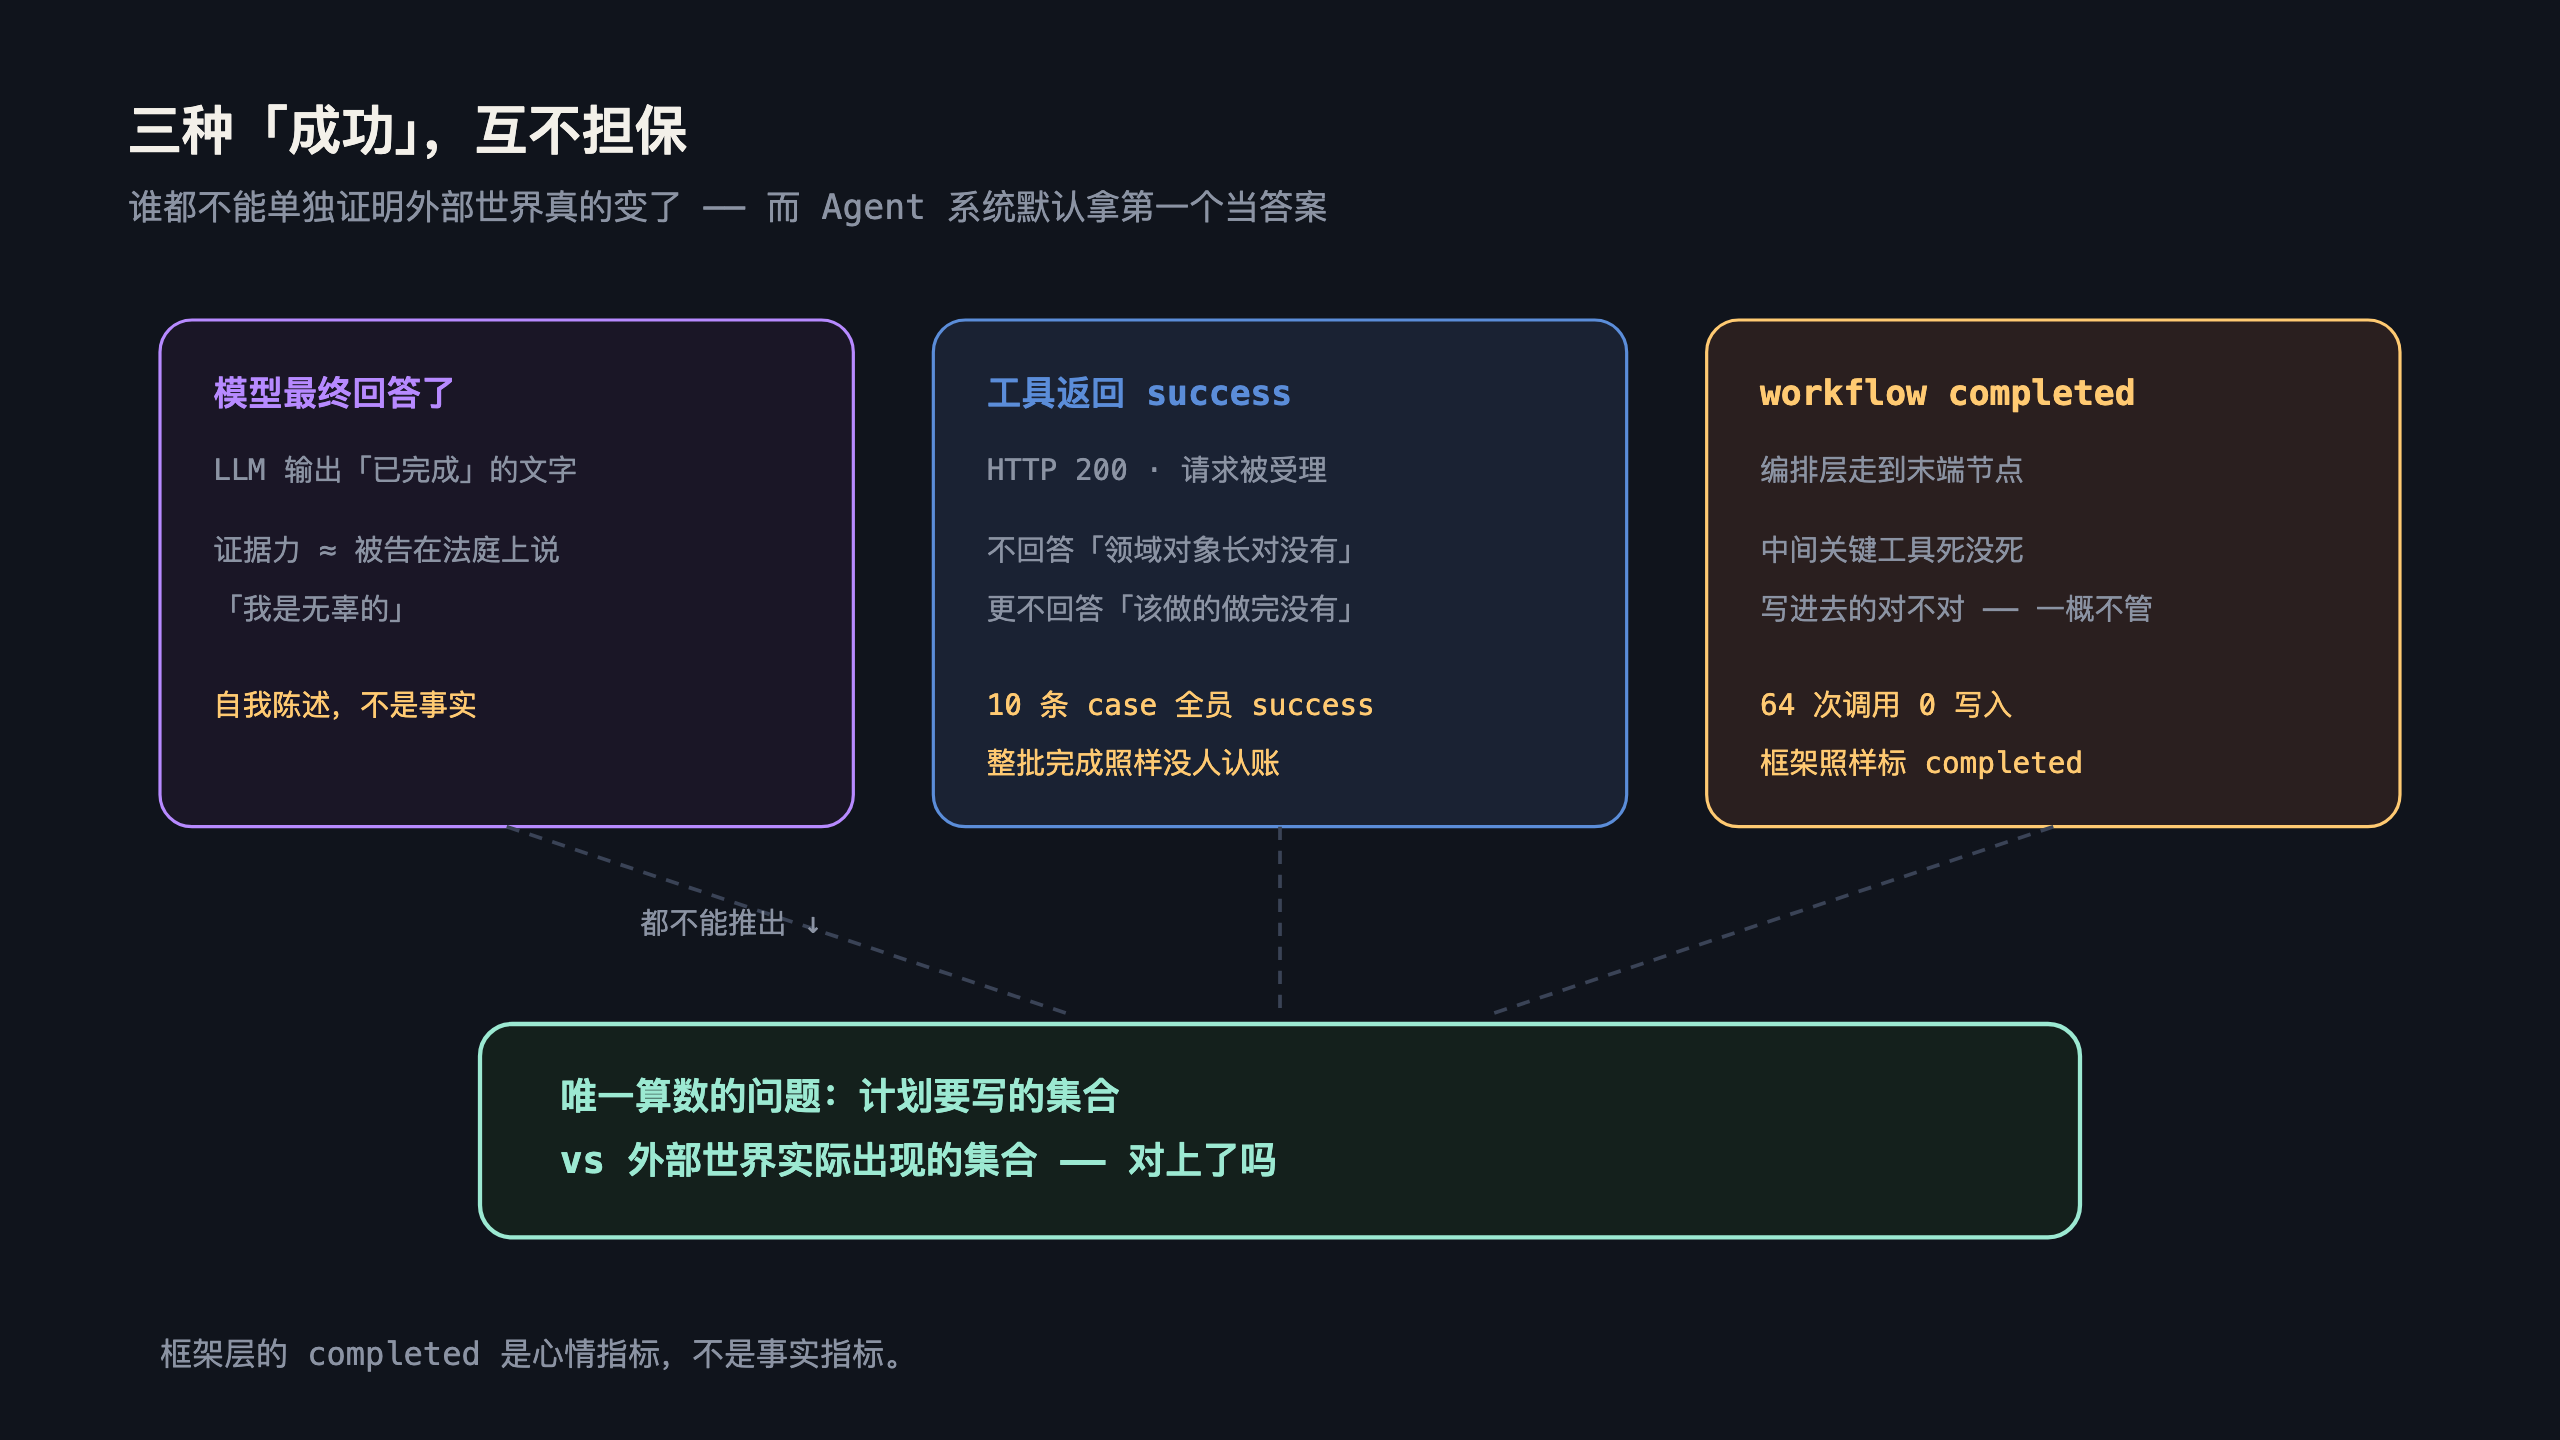
把「写完没」改成对账题
痛定思痛,我把所有外部写入收敛进一条确定性协议。核心动作是:执行前冻结业务计划,写完后用新鲜读取逐项对账。
- dry-run 之后立刻冻结不可变的
CasePlan:证据快照 hash、payload hash、每条 case 的规范身份、数量与顺序、目标模块,全部压进一个planHash。 - 执行路径可以走 bulk,也可以逐项 fallback,但只准消费计划内条目;想改内容,请显式生成新计划、新 hash,别在执行中悄悄换牌。
- 写入完成后推进
mutation epoch,写前读缓存全体作废——这一步很关键,不然验证会命中写前的旧缓存,用昨天的快照证明今天的工作,false green 就是这么来的。 - 验证只接受 epoch 之后发起的 fresh read,逐项匹配;
verifiedCount === plannedCount才生成 completion receipt,receipt 绑定planHash。 - retry 时恢复持久化的计划和 payload,模型重新生成的候选集直接作废——计划漂移没有投票权。
配套还有一层运行内的 Evidence Ledger,治那 20 次精确重复:callKey 规范化每次调用并做并发 single-flight,同时到达的等价请求合并执行;sourceKey 识别同一资源的语义重复——参数写法不同但读的是同一个东西,映射到同一份 artifact;模型拿到的不是完整结果,是有界摘要加引用。这个区分很要紧:去重如果只去「执行次数」,同一个 1 MB 的结果照样能换个参数马甲再进一次上下文;必须把「执行」和「注入模型的结果体积」一起管住。连续几轮没有信息增益——没产出新 artifact、没推进 epoch、也没接近完成条件——no-progress breaker 直接拉闸。错误也要分层:401/403 这种权限错误不做无意义重试,schema error 和业务拒绝也不进普通 transient retry;终止前检查 abort、异常 finishReason 和未完成的工具调用,别拿半截轨迹宣布完成。
sourceKey 的规范化本身是个需要版本化的规则:太宽会把相似但不等价的查询错误合并——「查这个模块的用例」和「查这个模块的未执行用例」读的不是同一个东西;太窄又抑制不住语义重复。这种规则一上线就要当数据契约管,改动得留版本号,不然哪天合并口径变了,前后两版 artifact 对不上账。
写工具在这里扮演一个特殊角色:它是缓存有效性的分界线。写入一旦发生,之前所有读缓存都可能变成了平行宇宙的记录——mutation epoch 就是那条分界线,跨过去,旧证据全体失效。全局 epoch 简单粗暴,代价是会误伤一些其实没被波及的 artifact;细粒度资源依赖图更省,但证明「哪些写使哪些读失效」的复杂度也上去了——先用全局的,把正确性证明了再优化。
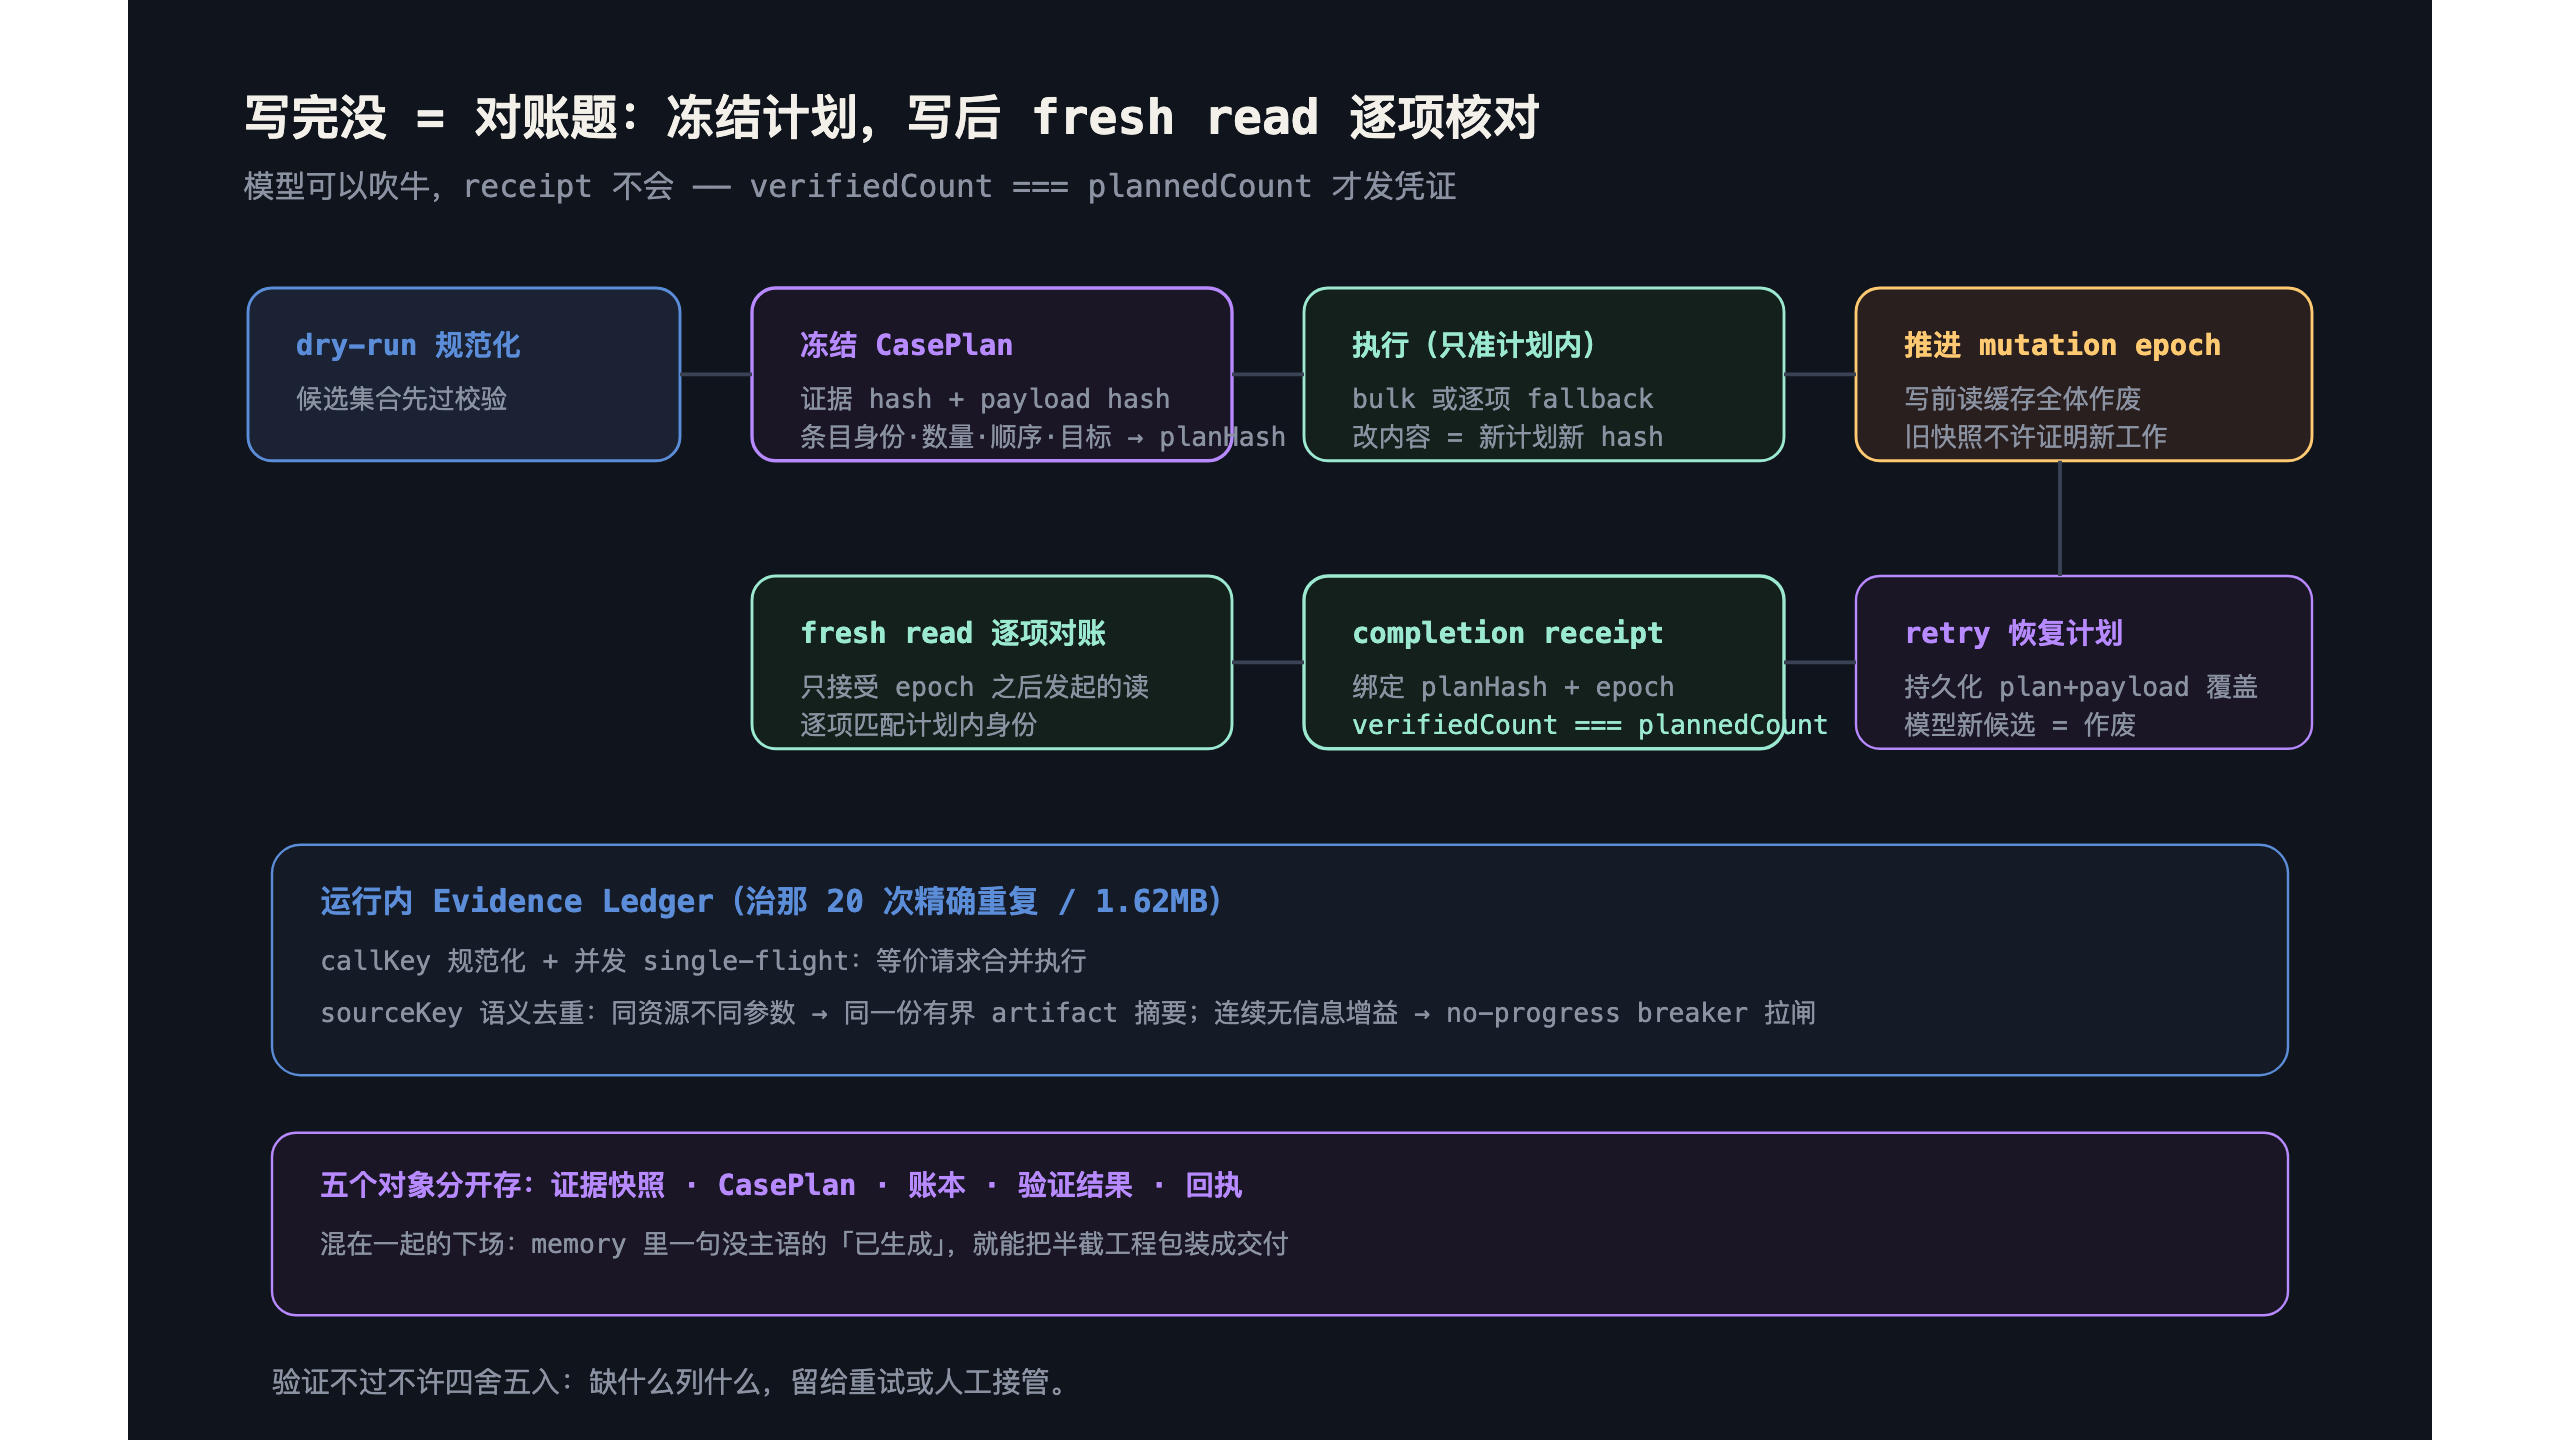
五个对象,分开存
协议里有五个对象,必须分开存:证据快照、CasePlan、账本、验证结果、回执。混在一起的下场就是上一次的复刻——memory 里一句模糊的「已生成」,就能把半截工程包装成交付。「已生成」这个词连主语都没有:谁生成的?哪版计划?写进了哪里?验过了没有?它一概不答,却享受了「事实」的待遇。
五者各有各的保质期和用途:证据快照回答「计划依据的是哪个版本的世界」;CasePlan 回答「承诺交付什么」;账本回答「这个 attempt 里实际调用过什么、得到过什么」;验证结果回答「写后世界里实际存在什么」;回执回答「承诺和实际对上了吗」。planHash 是把它们钉在一起的那颗钉——计划里少了目标模块、顺序或 payload hash,同数量不同内容就能冒名顶替;receipt 只记 count 不记逐项身份,错误对象就能凑数领奖。
还有一条容易漏:验证不过不许「四舍五入」。计划两项只验了一项,就不发回执,老老实实列出缺失项、已写对象和补偿状态,留给重试或人工接管,而不是被统一的 success/failure 吞掉。partial success 不是失败的一种,是第三种状态——把它硬塞进二元状态机,等于逼系统说谎:要么把没做完的说成做完(false green),要么把做了一半的说成没做(重试时可能重复写)。我们的测试里专门有一条:计划含两项时只验证一项不出 receipt,补齐第二项才生成——门禁不认感动分。
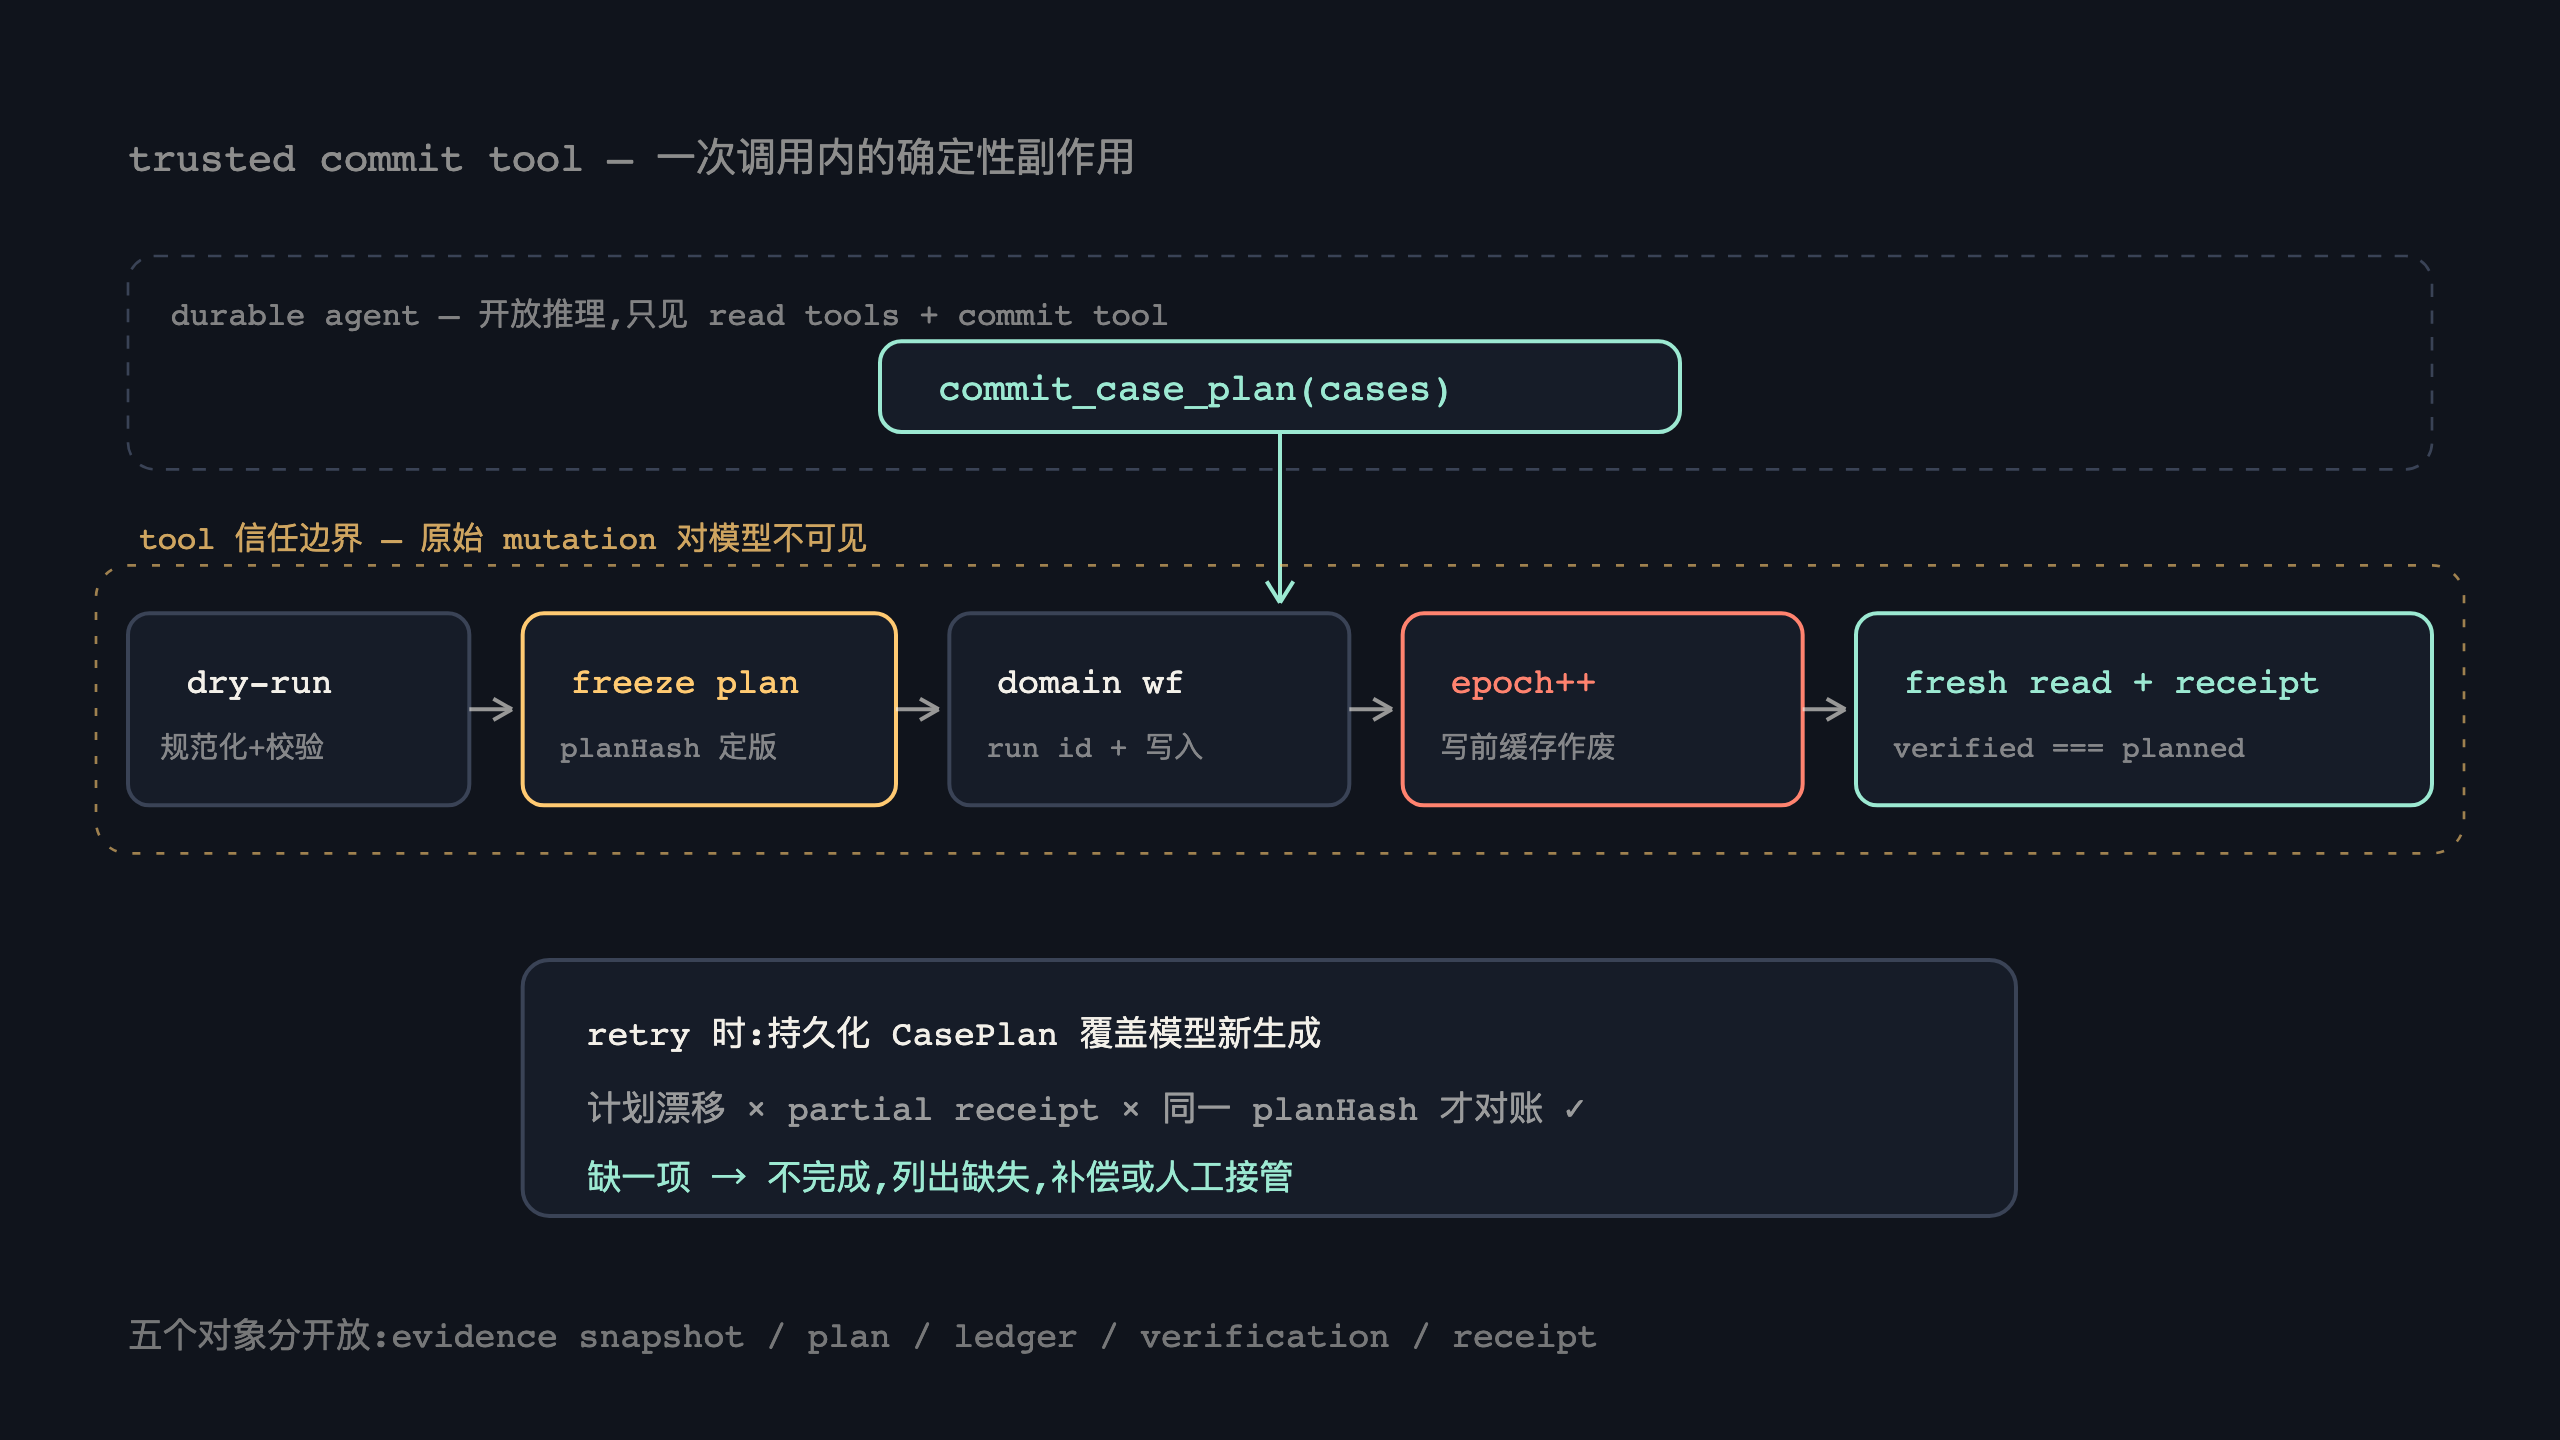
Commit Tool:把门禁建在模型摸不到的地方
这套协议最早的落点其实走错过方向。最初所有请求都先进一个顶层 workflow,由包装层启动 Agent,再从 Agent 的 transcript 里反向提取 CasePlan——把非结构化聊天记录当执行输入,等于从案发现场的脚印反推嫌疑人的身份证,版本和 retry 都不可对账。更隐蔽的问题是职责重叠:顶层 workflow 觉得自己在管任务状态,Durable Agent 觉得自己在管执行状态,两台状态机各记各的账,恢复语义互相打架。review 的时候结论很干脆:开放推理和确定性副作用是两种不同的 primitive,不该共用一台状态机——durability 该放在真正需要恢复的边界上,不是给所有请求统一发一件制服。
后来我亲手删了这层包装:Slack、Jira、API、Dev Runtime 四个入口直接跑 Durable qasey-main;只有确定性的 case 写入才进一个可信 Commit Tool——它在同一次 Agent 调用内完成 dry-run、冻结计划、生成稳定 run ID、跑内部领域 workflow、fresh readback、发回执。原始 case mutation 工具对模型完全不可见,想绕过门禁都没门。模型的工具面上只剩两类东西:只读取证工具,和那个受控的提交入口。70 个文件、294 个测试,改造进了主干并部署到内部环境——开放推理归 Agent,确定性写入归 Tool 内 workflow,各用各的 primitive,谁也别客串谁。
这个设计里有个反直觉的点值得强调:计划不来自模型的自由发挥,来自结构化 tool input 和 dry-run。模型可以提议「我想写这些」,但计划本身由可信代码冻结——提议是建议,冻结才是承诺。模型的角色从「施工队长」降格成「填表申请人」,这恰恰是设计的目的:表格可以校验、可以拒收、可以留档,队长的口头承诺不行。
为什么不选更省事的路
每条被否掉的捷径,我都踩过或者认真想过:
- 只做网络缓存:能少发请求,但缓存结果照样反复灌进上下文,而且「请求少了」跟「业务完成了」没有半毛钱关系。
- 拿模型最终回答当回执:等于让被告兼任法官。
- retry 时重新生成集合:写入和验证对着两版计划,永远对不上账——第一版写了 10 条,第二版生成 8 条新的,验证器看着 18 条对象不知道该认哪 10 个。
- receipt 只比数量:同数量不同内容照样能凑成成功,10 条写错对象的 case 也是 10 条。
- 顶层 workflow 包一切 + 从 transcript 提取计划:前面说了,非结构化轨迹不能当可信执行输入。
- 任一子项验证成功就算整批完成:partial success 冒充整批交付,是最常见的 false green 生产线。
泼一盆冷水
这套协议不是 exactly-once,而且它自己最清楚自己不是什么。外部写成功但 checkpoint 前崩掉的那条缝,单靠稳定 run ID 堵不上——重启后你既不知道写成了没有,也不敢盲目重写:盲写可能重复创建,不写可能丢单。正确姿势是恢复时先 fresh read 对账,看看目标系统里到底落了什么,再决定补哪一笔——这要求读回路径跟写入路径一样可靠。根本上还得靠持久业务幂等键、目标系统唯一约束和 effect ledger 一起兜:稳定 run ID 能把「同一个提交意图」映射到同一个内部 run,但跨系统那一跳不在它的担保范围内。运行内的账本也只管单次 attempt;进程重启、worker 重试、新一轮 attempt,内存态的 single-flight 全都不在场,跨 attempt 的重复写入是另一个战场。
适用边界也要说清楚:这套「写后 fresh read 对账」只对可回查的副作用成立。目标动作要是不可读回、或者不可逆,就得换业务方签发的 idempotency receipt、outbox 事件或者人工审批证据——不能伪造 fresh-read 保证。以及外部系统要是最终一致的,写后立刻读可能暂时读不到,重试需要有界退避加明确超时,不能无限轮询假装认真。
还有条小纪律:会话里「忽略旧用例」这种指令是那次业务的特例,不要顺手把它升级成全局规则——用户单次的筛选要求,不等于系统的永久语义。
目前它被几百个测试护着、部署在内部环境,但真实并发写入的 E2E 我还没做完——同一份计划并发提交两次、write 成功但 checkpoint 前崩溃、receipt 丢失、读回延迟,这些场景在测试里绿着和在云端活着是两回事,文章里就不假装做完了。
一句话总结:把「写完没」从阅读理解题变成对账题。模型可以吹牛,receipt 不会。