在分布式系统与自主 Agent 的实践中,最昂贵的损耗往往不是明面上的报错崩溃,而是缺乏终结机制的死循环与无界等待。这种“挂而不死、占而不用”的系统僵死状态,不仅默默侵蚀着算力预算,更在监控面板上构建出极具欺骗性的假象。本文将结合一次具体的线上事故排查过程,深入剖析 Agent 系统中无界等待的生成机制、监控伪证的识别路径、双层超时机制的构建策略,以及 Agent loop 对异常损耗的放大效应,并最终给出分层预算管控的落地实践指南。
案发现场先撒了个谎
事故的起因是一个负责 QA 自动化取证的 Agent 节点突然在执行队列中无故挂起。在长达两个小时的时间里,该节点既未返回任何阶段性结果,也未抛出任何异常抛错,直至被人工干预强制终止。
在排查初期,监控面板给出的诊断数据展现出了强烈的误导性。以 n8n 工作流的执行日志为例,耗时统计明细直指几个高疑点节点:
- 错位的工具调用日志:日志显示一个名为
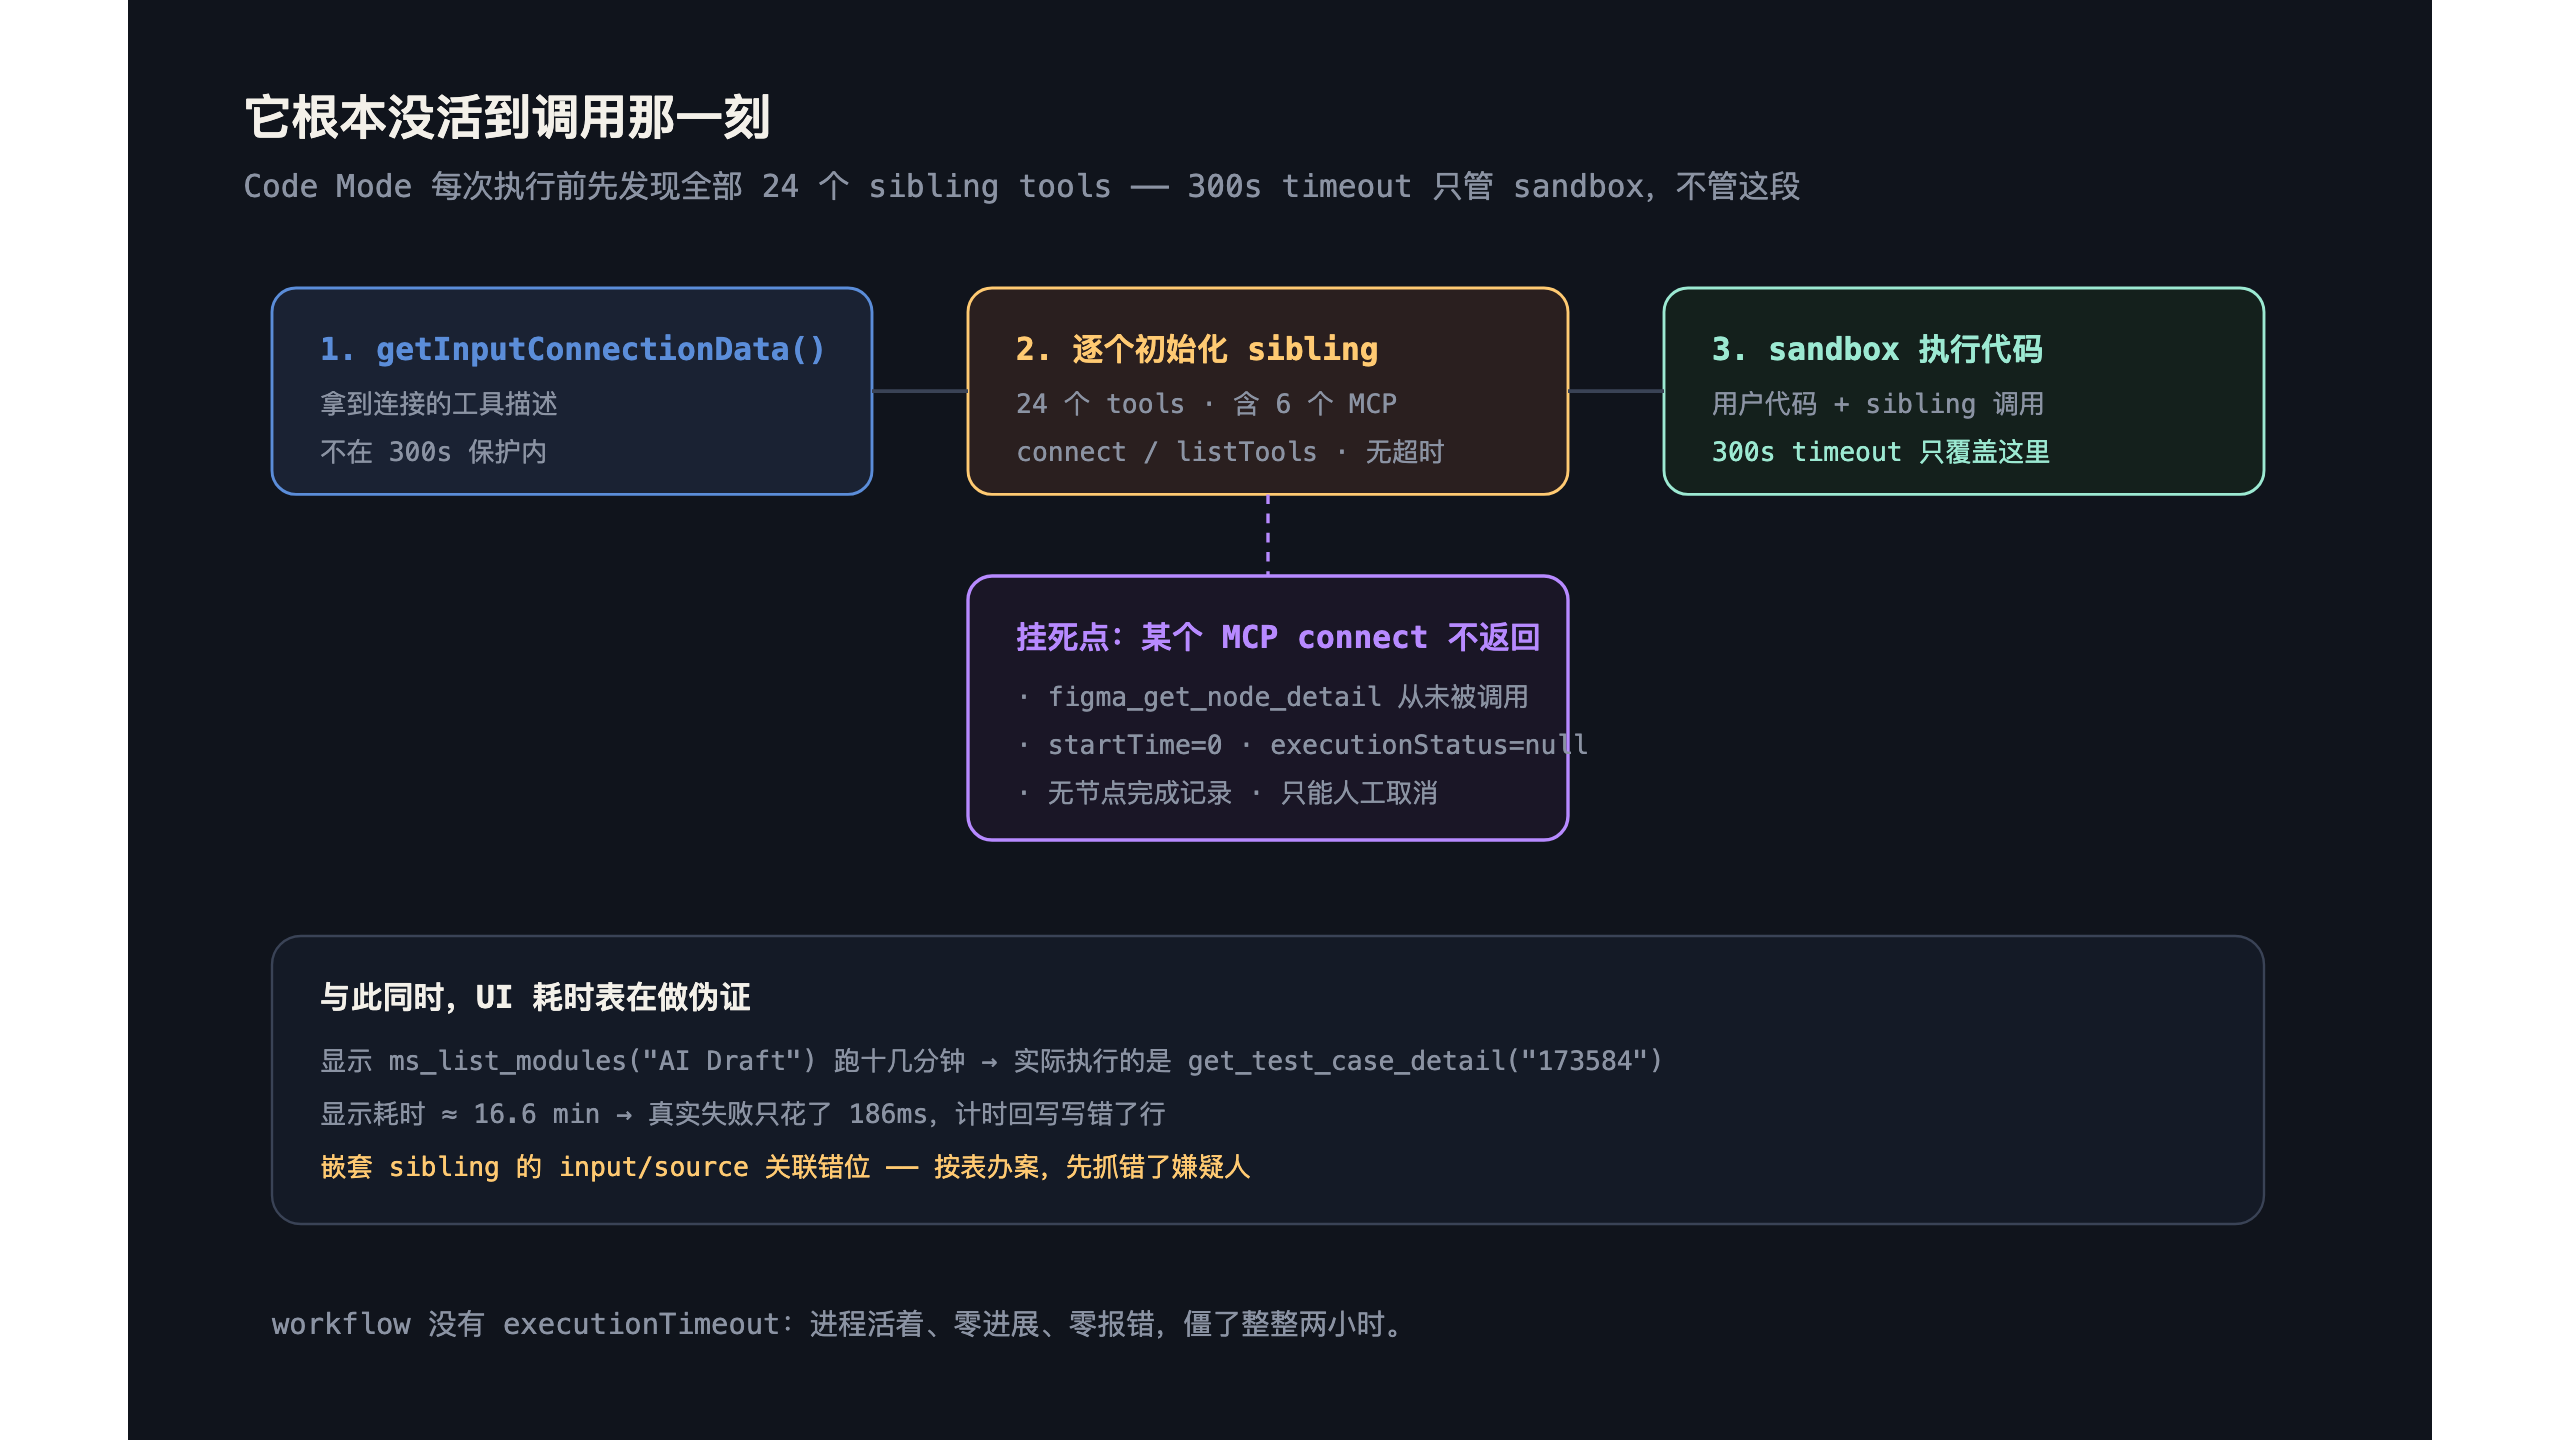
ms_list_modules(query="AI Draft")的工具调用持续执行了十几分钟,且伴随状态为 null 的 Pending 状态。然而,顺着底层调用链source.previousNodeRun追溯至 Code Mode 组件源码时发现,实际执行的底层逻辑为get_test_case_detail("173584")。这是由于嵌套 sibling tool 的执行输入(execution input)发生了关联错位,导致前端 UI 将批量上报(bulk upsert)的参数错误地映射到了list_modules节点上。进一步分析链路日志可知,该真实失败调用的耗时仅为 186 毫秒,但由于计时回写逻辑存在 Bug,错误码被写回到了索引为 0 的起始行,进而被前端渲染为约 16.6 分钟的挂起状态。 - 被排除的外部依赖:日志中另一个高频嫌疑节点——针对 Figma 的大批量读取任务(
depth: 2,包含 17 个 node),其startTime始终停留在 0。通过抽取同时间段的其他执行记录进行对照组校验,6 次 Figma 接口调用的响应耗时分布在 1.17 秒至 8.20 秒之间,表现完全正常。这表明所谓的 Figma 卡顿实际上并未真正触发figma_get_node_detail逻辑,请求在进入该阶段前就已经处于阻塞状态。 - 版本差异带来的逻辑偏差:在组件源码层面,MCP(Model Context Protocol)工具外层被 n8n 的
logWrapper进行包装,理论上每次_call动作均应生成独立的运行记录。但在生产环境的日志集中,多次连续调用被合并缩减为了单行日志。鉴于第三方工作流引擎(如 n8n)版本迭代频繁,调试此类问题时必须先明确生产环境的具体 Tag 版本(如 2.33.4 或 2.34.1),确认线上运行镜像与源码分支严格一致,避免因版本漂移导致错误的工程断言。
最终的排查结果表明,真正的死锁点位于整个执行序列的入口处:Code Mode 在执行用户自定义代码前,触发了 getInputConnectionData() 方法,用于动态发现并初始化全部 24 个 sibling tools(包含 6 个 MCP 实例)。
在此过程中:
- Code Mode 自身配置的 300 秒 Timeout 仅覆盖后续 Sandbox 内的脚本执行阶段,对于前置的工具发现与连接建立(
connect/listTools)过程完全缺失控制。 - 当任意一个 sibling MCP 节点因网络抖动或对端无响应而无法返回时,由于缺少底层的超时断开机制,进程将无限期停留在
runNode()的内部等待循环中。 - 因为节点从未完成,系统无法产生节点结束事件,工作流层面亦未配置全局
executionTimeout,最终导致节点在 UI 层面仅保留startTime=0的初始状态,造成算力与连接池的无底线占用。
先别急着上全局大砍刀
针对此类故障,最直接的架构直觉通常是引入全局超时(Global Timeout)进行一刀切式的拦截。然而,基于真实业务负载的数据分析表明,单一的全局截断策略存在显著的工程隐患:
- 误杀合法长任务:在复杂的 Agent 应用场景下(如跨 Jira、PR、Slack 多数据源的深度 QA 取证),合理的串行链式调用耗时可达 20 分钟以上。若全局超时阈值设定过低,会导致高价值的长尾任务被频繁误杀。
- 故障响应滞后:若为了兼容长任务而将全局超时设定得过宽(例如 30 分钟),对于前述发生在“工具发现阶段”的无界死锁,系统依然需要白白消耗 30 分钟的无效等待时间,熔断机制的敏捷度严重不足。
- 防御覆盖度盲区:仅修复特定的子模块(如仅针对 Figma sibling 增加连接超时)只能消除已知的故障点,一旦后续接入新的 MCP 端点或自定义组件,无界等待的隐患依然会顺着未受保护的通道再次暴露。
经过对多种治理方案(单一子流超时、单一全局上限、单一局部超时、局部与全局双层防护)的拦截效果与熔断成本评估,最终确定了双层超时治理架构:
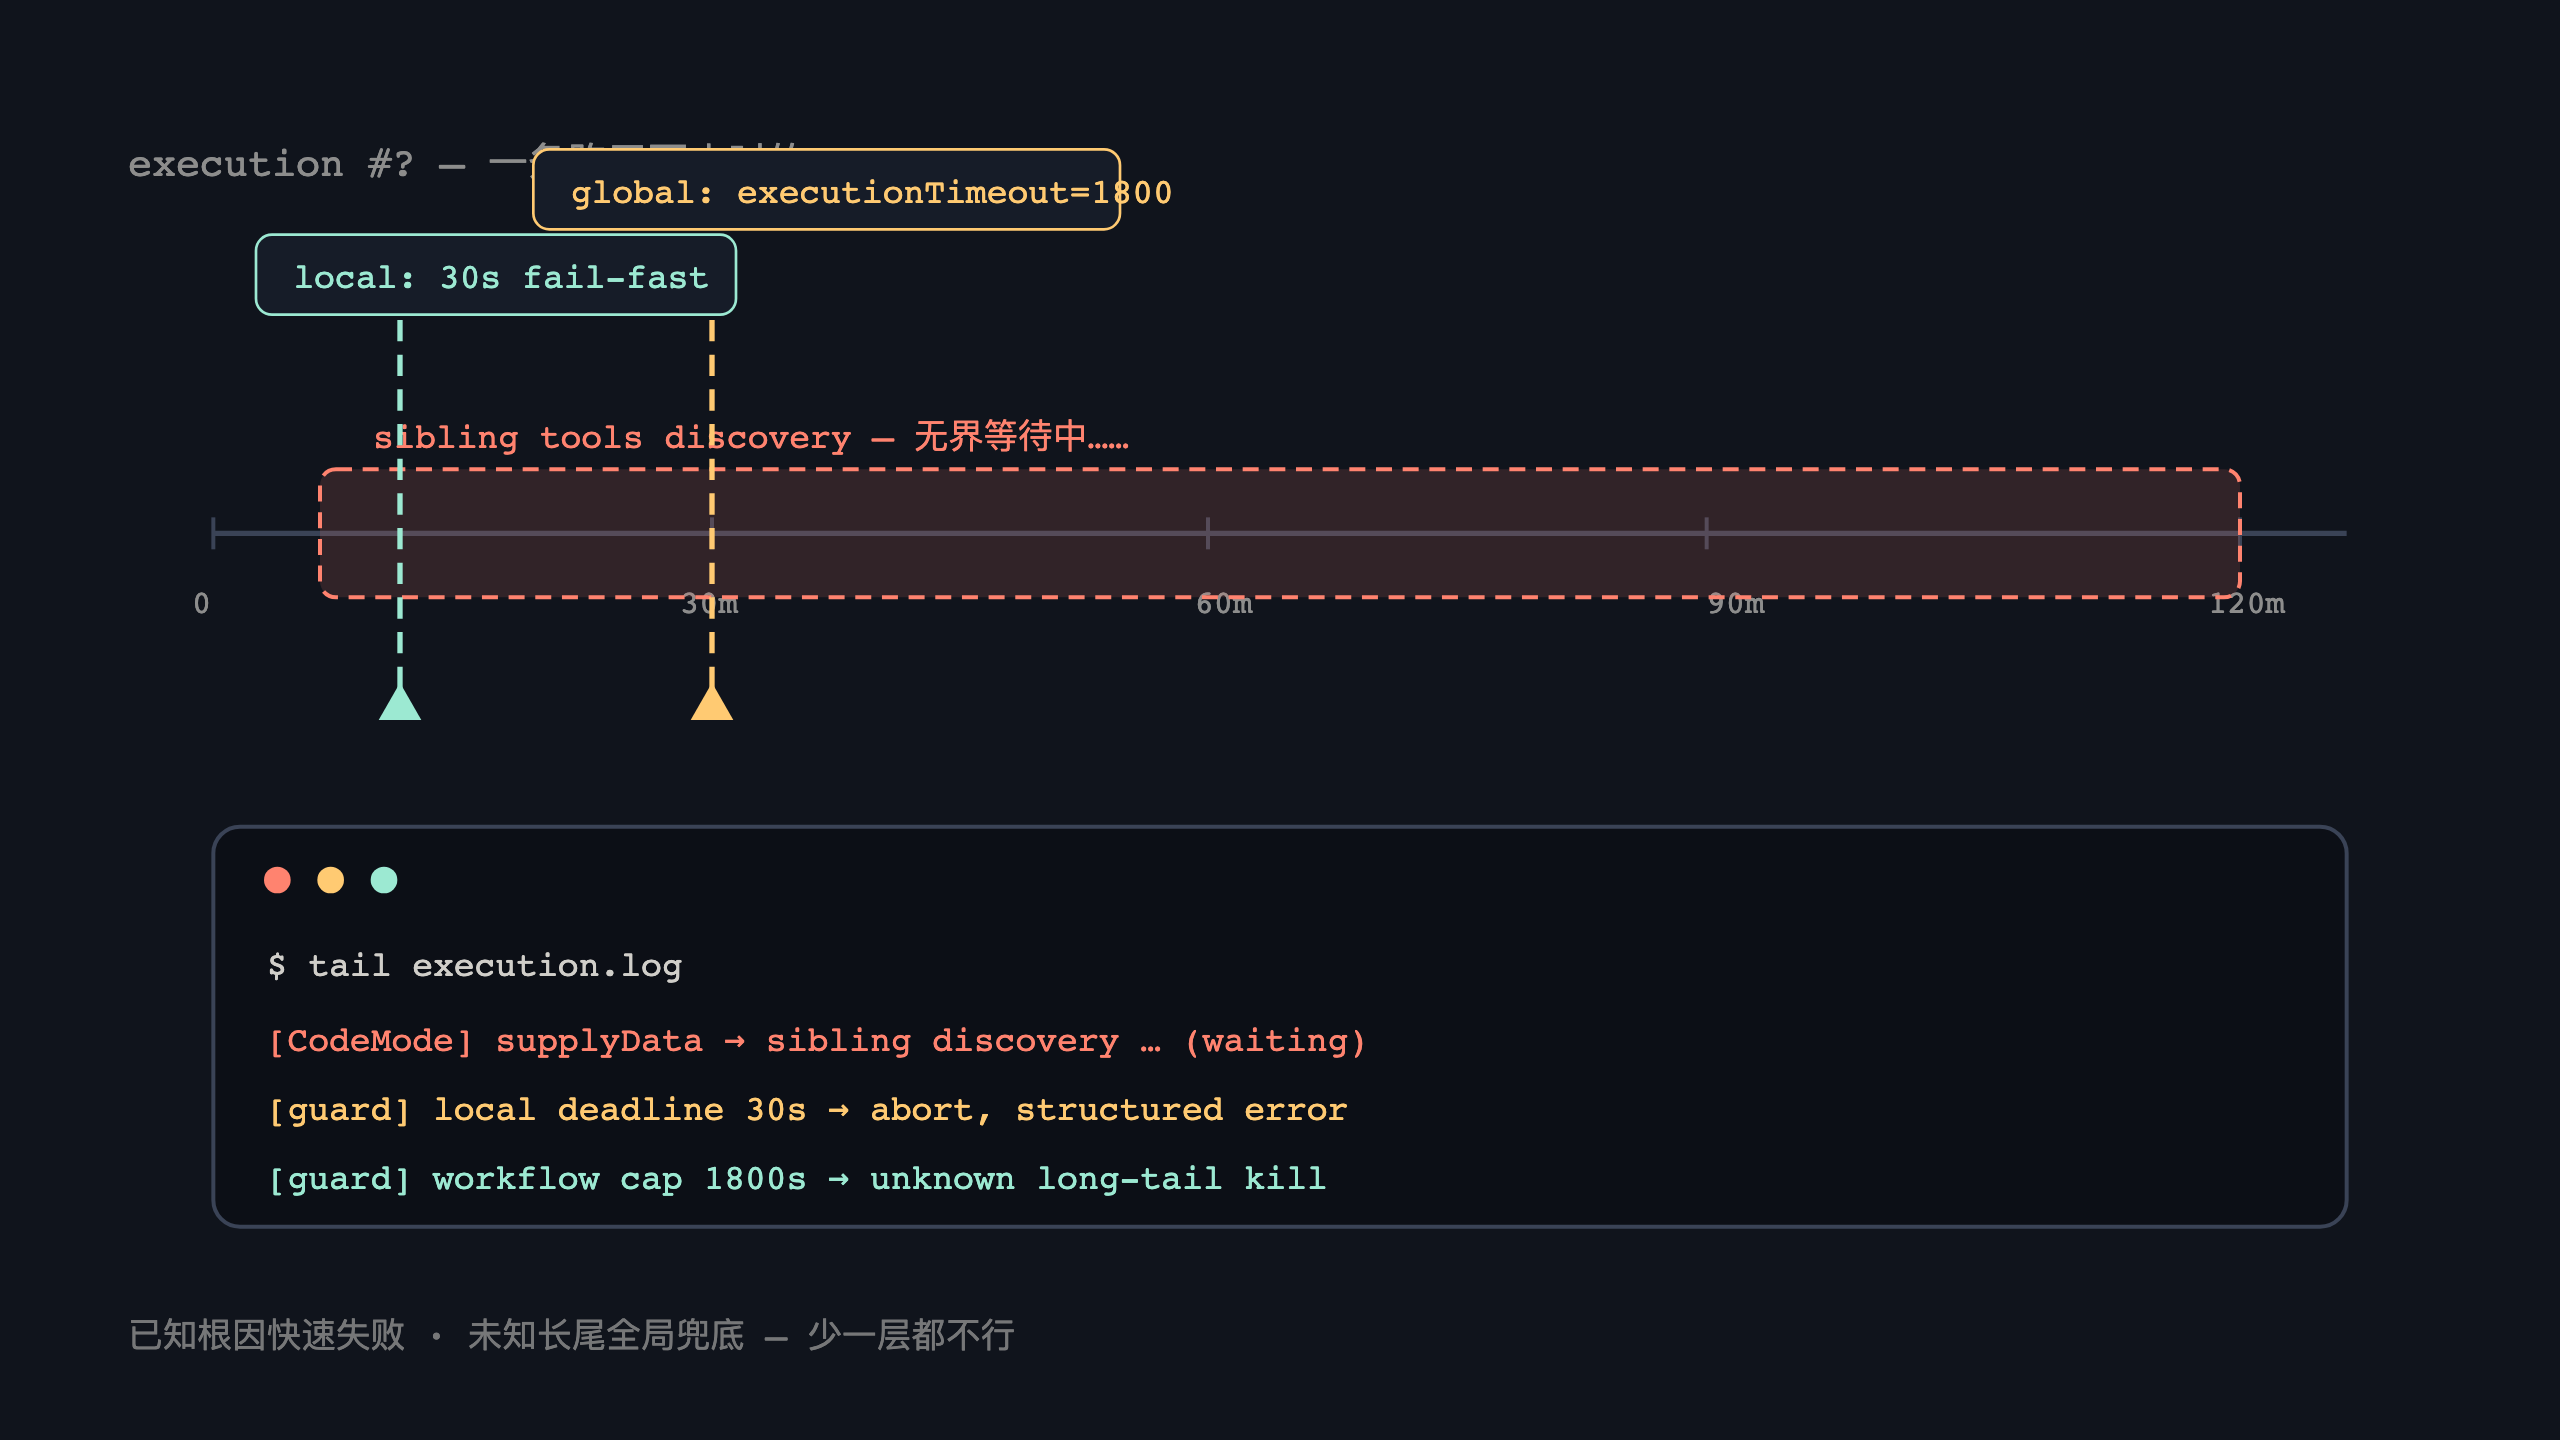
- 组件层(局部超时):针对工具发现、连接建立及单次模型请求等微观操作,显式注入 30 秒 的局部超时限制。一旦触发,立即中断阻塞链路,抛出包含明确错误上下文(如特定 sibling 名称、执行阶段)的结构化异常,实现 Fail-Fast。
- 工作流层(全局 Guard):在工作流配置层面设置
executionTimeout=1800(30 分钟)作为底线防御。该策略不依赖于具体组件的实现逻辑,确保任何未预期的长尾阻塞均能在上限到达时被强制回收。
+-----------------------------------------------------------------------+
|                      Workflow Level (Global Guard)                    |
|                      executionTimeout = 1800s                         |
|                                                                       |
|   +---------------------------------------------------------------+   |
|   |                 Code Mode Node Execution                      |   |
|   |                                                               |   |
|   |   +-------------------------------------------------------+   |   |
|   |   |  Sibling Tools Discovery (getInputConnectionData)     |   |   |
|   |   |  * Strict Timeout: 30s Fail-Fast                      |   |   |
|   |   +-------------------------------------------------------+   |   |
|   |                                                               |   |
|   |   +-------------------------------------------------------+   |   |
|   |   |  Sandbox Execution                                    |   |   |
|   |   |  * Internal Timeout: 300s                             |   |   |
|   |   +-------------------------------------------------------+   |   |
|   +---------------------------------------------------------------+   |
+-----------------------------------------------------------------------+
在实施局部 Fail-Fast 策略时,必须避免将超时处理退化为“隐性降级”(即忽略失败工具,继续带着缺失的工具链执行脚本)。必须保证发现阶段的失败具备严格的抛错传导性,直接使当前节点挂掉,并将确切的错误结构返回给 Agent 的决策 Loop。
在工程交付与回归测试环节,断言的目标应当从“验证正常情况下的流程通畅”转向“验证异常卡死状态下的死亡姿势”——即确保在下游网络无响应或连接挂起时,组件能够精确地在 30 秒内抛出结构化异常并终止进程。
长尾的另一半叫「放大」
在 Agent 系统的演进过程中,除了底层基础设施的无界等待外,Agent 自主的决策循环(Agent Loop)对异常耗时的乘法放大效应,是导致资源耗尽的另一个核心因素。
1. 无效重试与参数降级
分析一次耗时 62 分钟的异常执行记录,其耗时分布与调用链表现出极高的不合理性:
[Total Execution: 62 min]
  │
  ├─── Atlassian API Call (43 min 27 sec)
  │      └── Result: Failed ("Failed to fetch cloud ID for: . Error: Invalid URL")
  │
  └─── Agent Loop Failure Propagation (乘法放大阶段)
         ├── Sub-Agent Executions: 13 次
         ├── Model Inferences: 96 次
         ├── Code Mode Executions: 101 次
         └── GitHub Tool Retries: 67 次
                ├── File-related APIs: 48 次 (全灭)
                └── PR-related APIs: 19 次 (全灭)
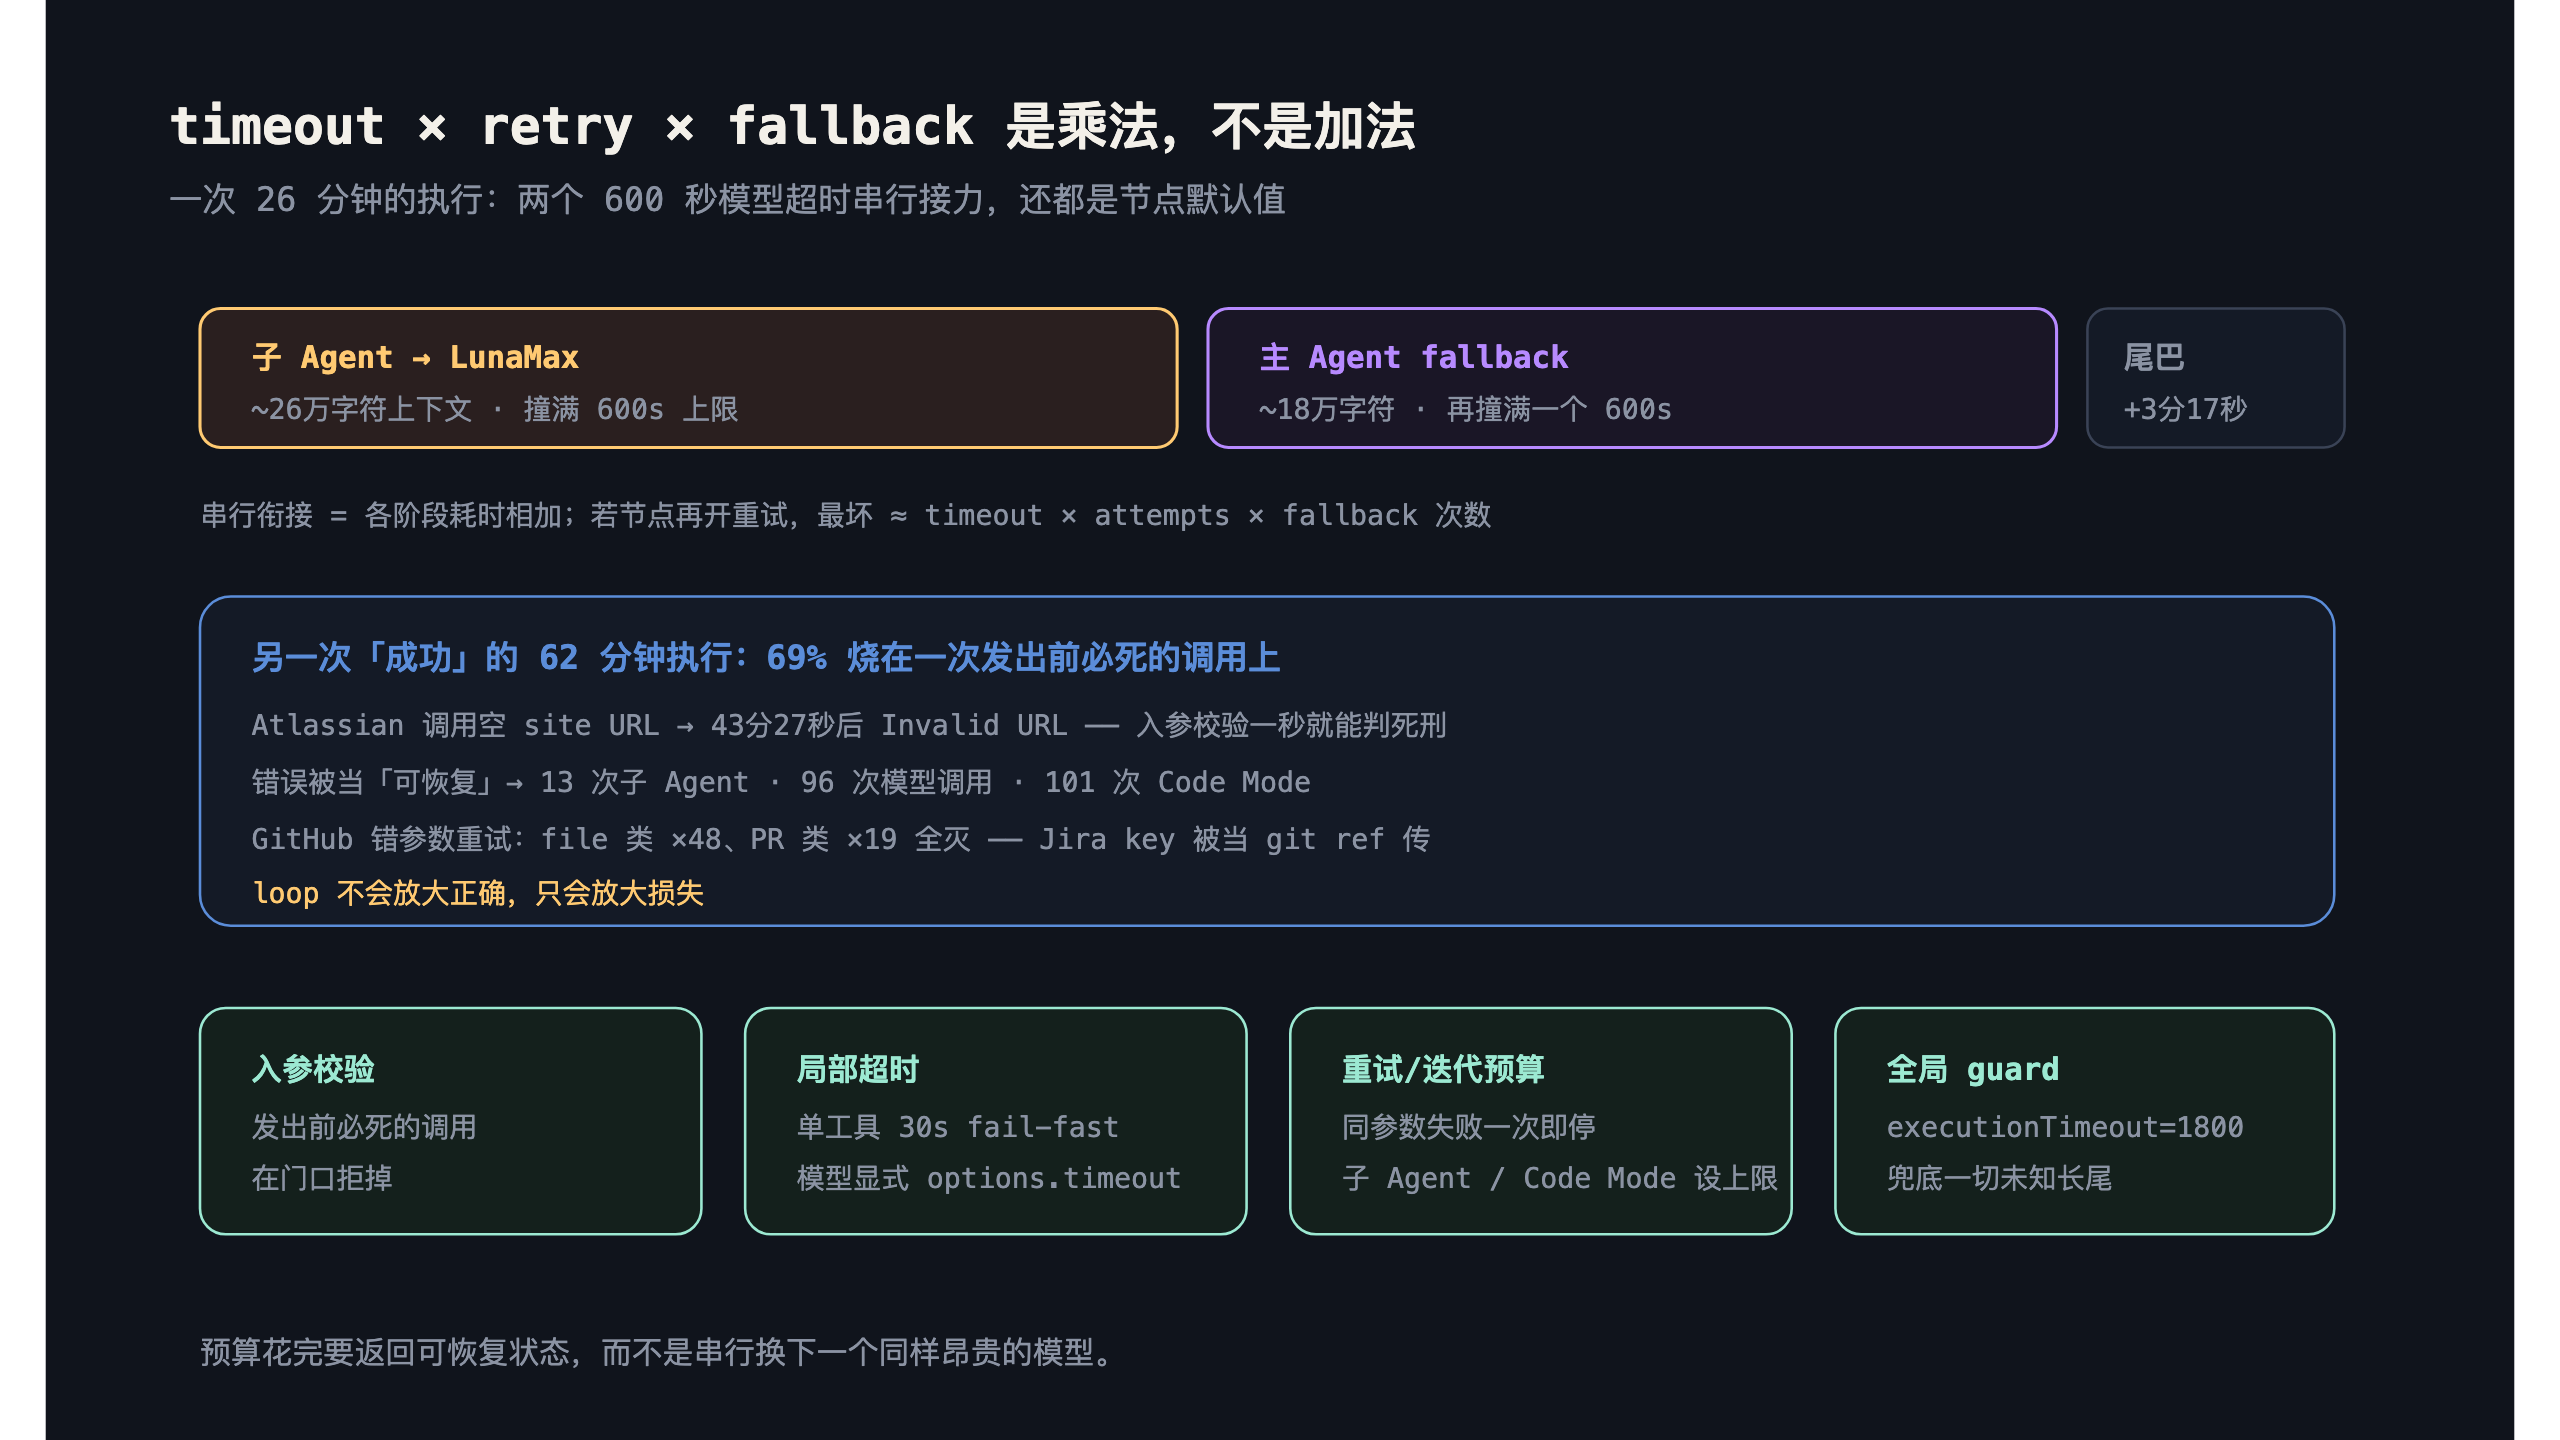
在此案例中,最上游的 Atlassian 调用由于入参 site URL 缺失,导致底层的 Http 请求直接失效。这种属于可以在 Schema 校验阶段静态拦截的错误,由于缺乏前置的入参契约断言,强行透传至服务端,并引发了长达 43 分钟的底层等待。
更严重的损耗发生在报错抛出之后:Agent Loop 将该静态错误误判为“可恢复的临时波动”,随后启动了剧烈的重试机制。在接下来的时间内,Agent 频繁将 Jira Key 作为参数错误地填入 GitHub 的 ref 字段中。由于缺乏契约层的硬性约束,Loop 针对已确定失败的参数组合连续重试了 67 次(包含 48 次 File 类操作与 19 次 PR 类操作)。这种将参数级错误交给 LLM 自愈的尝试,不仅无法提昇任务成功率,反而将单点错误放大为了百次级别的无效 API 消耗。
2. 级联 Timeout 与 Fallback 机制碰撞
另一次耗时 26 分钟的典型案例展示了默认超时参数与 Fallback 逻辑重叠时的放大效应:
+------------------------------------------------------------------------+
|                         Agent Task Failure Cascade                     |
+------------------------------------------------------------------------+
                                     │
                                     ▼
+------------------------------------------------------------------------+
| Sub-Agent Context (~260k tokens)                                       |
| Executing Chat Model Node (Default Timeout: 600s)                      |
| ──> [TIMEOUT EXPIRED: 600s]                                            |
+------------------------------------------------------------------------+
                                     │
                                     ▼ (Fallback Triggered)
+------------------------------------------------------------------------+
| Main Agent Context (~180k tokens)                                      |
| Executing Fallback Chat Model Node (Default Timeout: 600s)             |
| ──> [TIMEOUT EXPIRED: 600s]                                            |
+------------------------------------------------------------------------+
                                     │
                                     ▼
+------------------------------------------------------------------------+
| Trailing Model Inferences & Cleanup Operations                         |
| ──> [TIME SPENT: ~197s]                                                |
+------------------------------------------------------------------------+
                                     │
                                     ▼
                  Total Cumulative Time: ~1597s (26.6 min)
在该链路中,由于未显式配置 Chat Model 节点的 options.timeout,系统直接继承了引擎默认的 600 秒上限。当子 Agent 携带着约 26 万 Token 的超大上下文触发模型响应超时(600 秒)后,主 Agent 的 Fallback 机制被激活;主 Agent 随后携带着约 18 万 Token 的上下文再次击穿了 Fallback 模型的 600 秒超时上限。
最终,Timeout × Retry × Fallback 的乘法效应使得单个任务在完全失效前累计消耗了超过 26 分钟。这种长时间等待本质上是由未受控的默认参数与不合理的上下文膨胀共同塑造的。
为了遏制此类放大效应,必须对模型节点的超时上限进行针对性的显式收紧,并搭配严格的上下文剪裁策略:
| 模型节点类型 | 推荐显式 Timeout 上限 | 匹配策略 |
|---|---|---|
| LunaMax / 轻量级推理节点 | 180 秒 | 强制上下文截断,禁止携带超长历史 |
| OpenAI / 通用主模型节点 | 240 秒 | 限制 Tool Call 递归深度,前置 Schema 校验 |
| LiteLLM / 路由网关节点 | 120 秒 | 快速熔断,禁止跨大版本模型无缝 Fallback |
预算要分层发,不能只发一张总卡
针对 Agent 系统中出现的各种耗时放大现象,靠单一维度的控制很难取得理想效果。必须建立一套分层预算控制体系(Layered Budget Allocation)。
其核心逻辑在于:将一次用户请求的总时间/算力预算,自顶向下拆解并分配给具体的子阶段;任何底层组件仅能在分配给自己的子预算范围内执行,超出即止,严禁无限度占用上层资源。
+-----------------------------------------------------------------------+
|                    End-to-End Execution Budget                        |
|                    (e.g., Global Max Time: 1800s)                     |
+-----------------------------------------------------------------------+
                                   │
      ┌────────────────────────────┼────────────────────────────┐
      ▼                            ▼                            ▼
+-------------------+    +-------------------+    +--------------------+
| 1. Input Guard    |    | 2. Local Timeout  |    | 3. Loop Iteration  |
|    Schema & Field |    |    Tool / Discovery|    |    Max Sub-Agents & |
|    Validation     |    |    Fail-Fast      |    |    Max Iterations  |
+-------------------+    +-------------------+    +--------------------+
1. 入参契约前置(Input Guard)
在 API 或工具调用的最前端设置防御性校验。针对 site URL、cloud ID、git ref 等关键参数进行非空断言与格式正则匹配。对于确信抛错的请求,在工具入口处直接拒绝并返回带有遗漏字段提示的结构化错误(如 Missing field: site_url),阻止 Agent Loop 将无效请求透传至底层接口。
2. 局部硬超时(Local Timeout)
针对单次工具发现、单次 HTTP 请求及 LLM API 调用设置独立的硬超时。对于 MCP 工具发现过程赋予 30 秒 Fail-Fast 限制;对于模型请求配置显式的 options.timeout。当局部超时触发时,中止当前分支并中断调用链,禁止将其隐式降级为无工具模式。
3. 迭代与重试预算(Loop Budget)
收紧 Agent 自主循环的自由度上限。
- 限制重试粒度:针对完全相同的参数组合,工具调用失败 1 次即标记为不可用,阻止重复尝试。
- 收紧迭代次数:将主 Agent 的
maxIterations参数由宽松的 80 次压缩至 2030 次;子 Agent 压缩至 1015 次。 - 限制衍生规模:对单个任务下允许拉起的子 Agent 总数设定硬性上限,同时限制 Code Mode 连续发生语法/参数错误的上限(如连续 2 次错误即终止重试)。
4. 全局兜底防护(Global Guard)
在工作流引擎层配置 executionTimeout(如 30 分钟),作为兜底的防线。即使底层遇到未预期的死锁或未捕捉的逻辑死循环,全局 Guard 也能确保系统在可接受的时间窗口内释放算力与连接资源。
运维与配置更新的工程注意事项
在实施上述预算控制策略时,通过 API 动态修改已上线的工作流配置(Workflows Settings)需要特别注意引擎的 Schema 校验机制。以 n8n(如 2.31.7 版本)为例,通过 Public API 修改 Workflow 时,直接将 GET 接口返回的数据体原样 PUT 回去,极易因包含只读或内部控制字段(如 availableInMCP、callerPolicy 等)而导致请求被拒,甚至导致工作流状态异常。
标准的配置更新规范流程应包含以下步骤:
1. Fetch Remote Config  ──> GET /workflows/{id}
                                   │
2. Clean Schema Data    ──> 过滤只读/内部字段,保留可写 Settings Schema
                                   │
3. Inject Timeouts      ──> 更新 executionTimeout 及节点级 options.timeout
                                   │
4. Apply & Reload       ──> PUT /workflows/{id} 并触发 Active 重新加载
                                   │
5. Re-read Verification ──> 回读验证: Active 状态 / Published Version / executionTimeout
通过建立严密的监控时间线与分层预算管控,Agent 系统能够从无序的“无界等待”转变为具备高度确定性的“优雅失败”。超时机制的本意并非限制 Agent 的能力上限,而是赋予系统在面对异常与不确定性时,能够有秩序、有礼貌地认输并释放资源的底层工程教养。