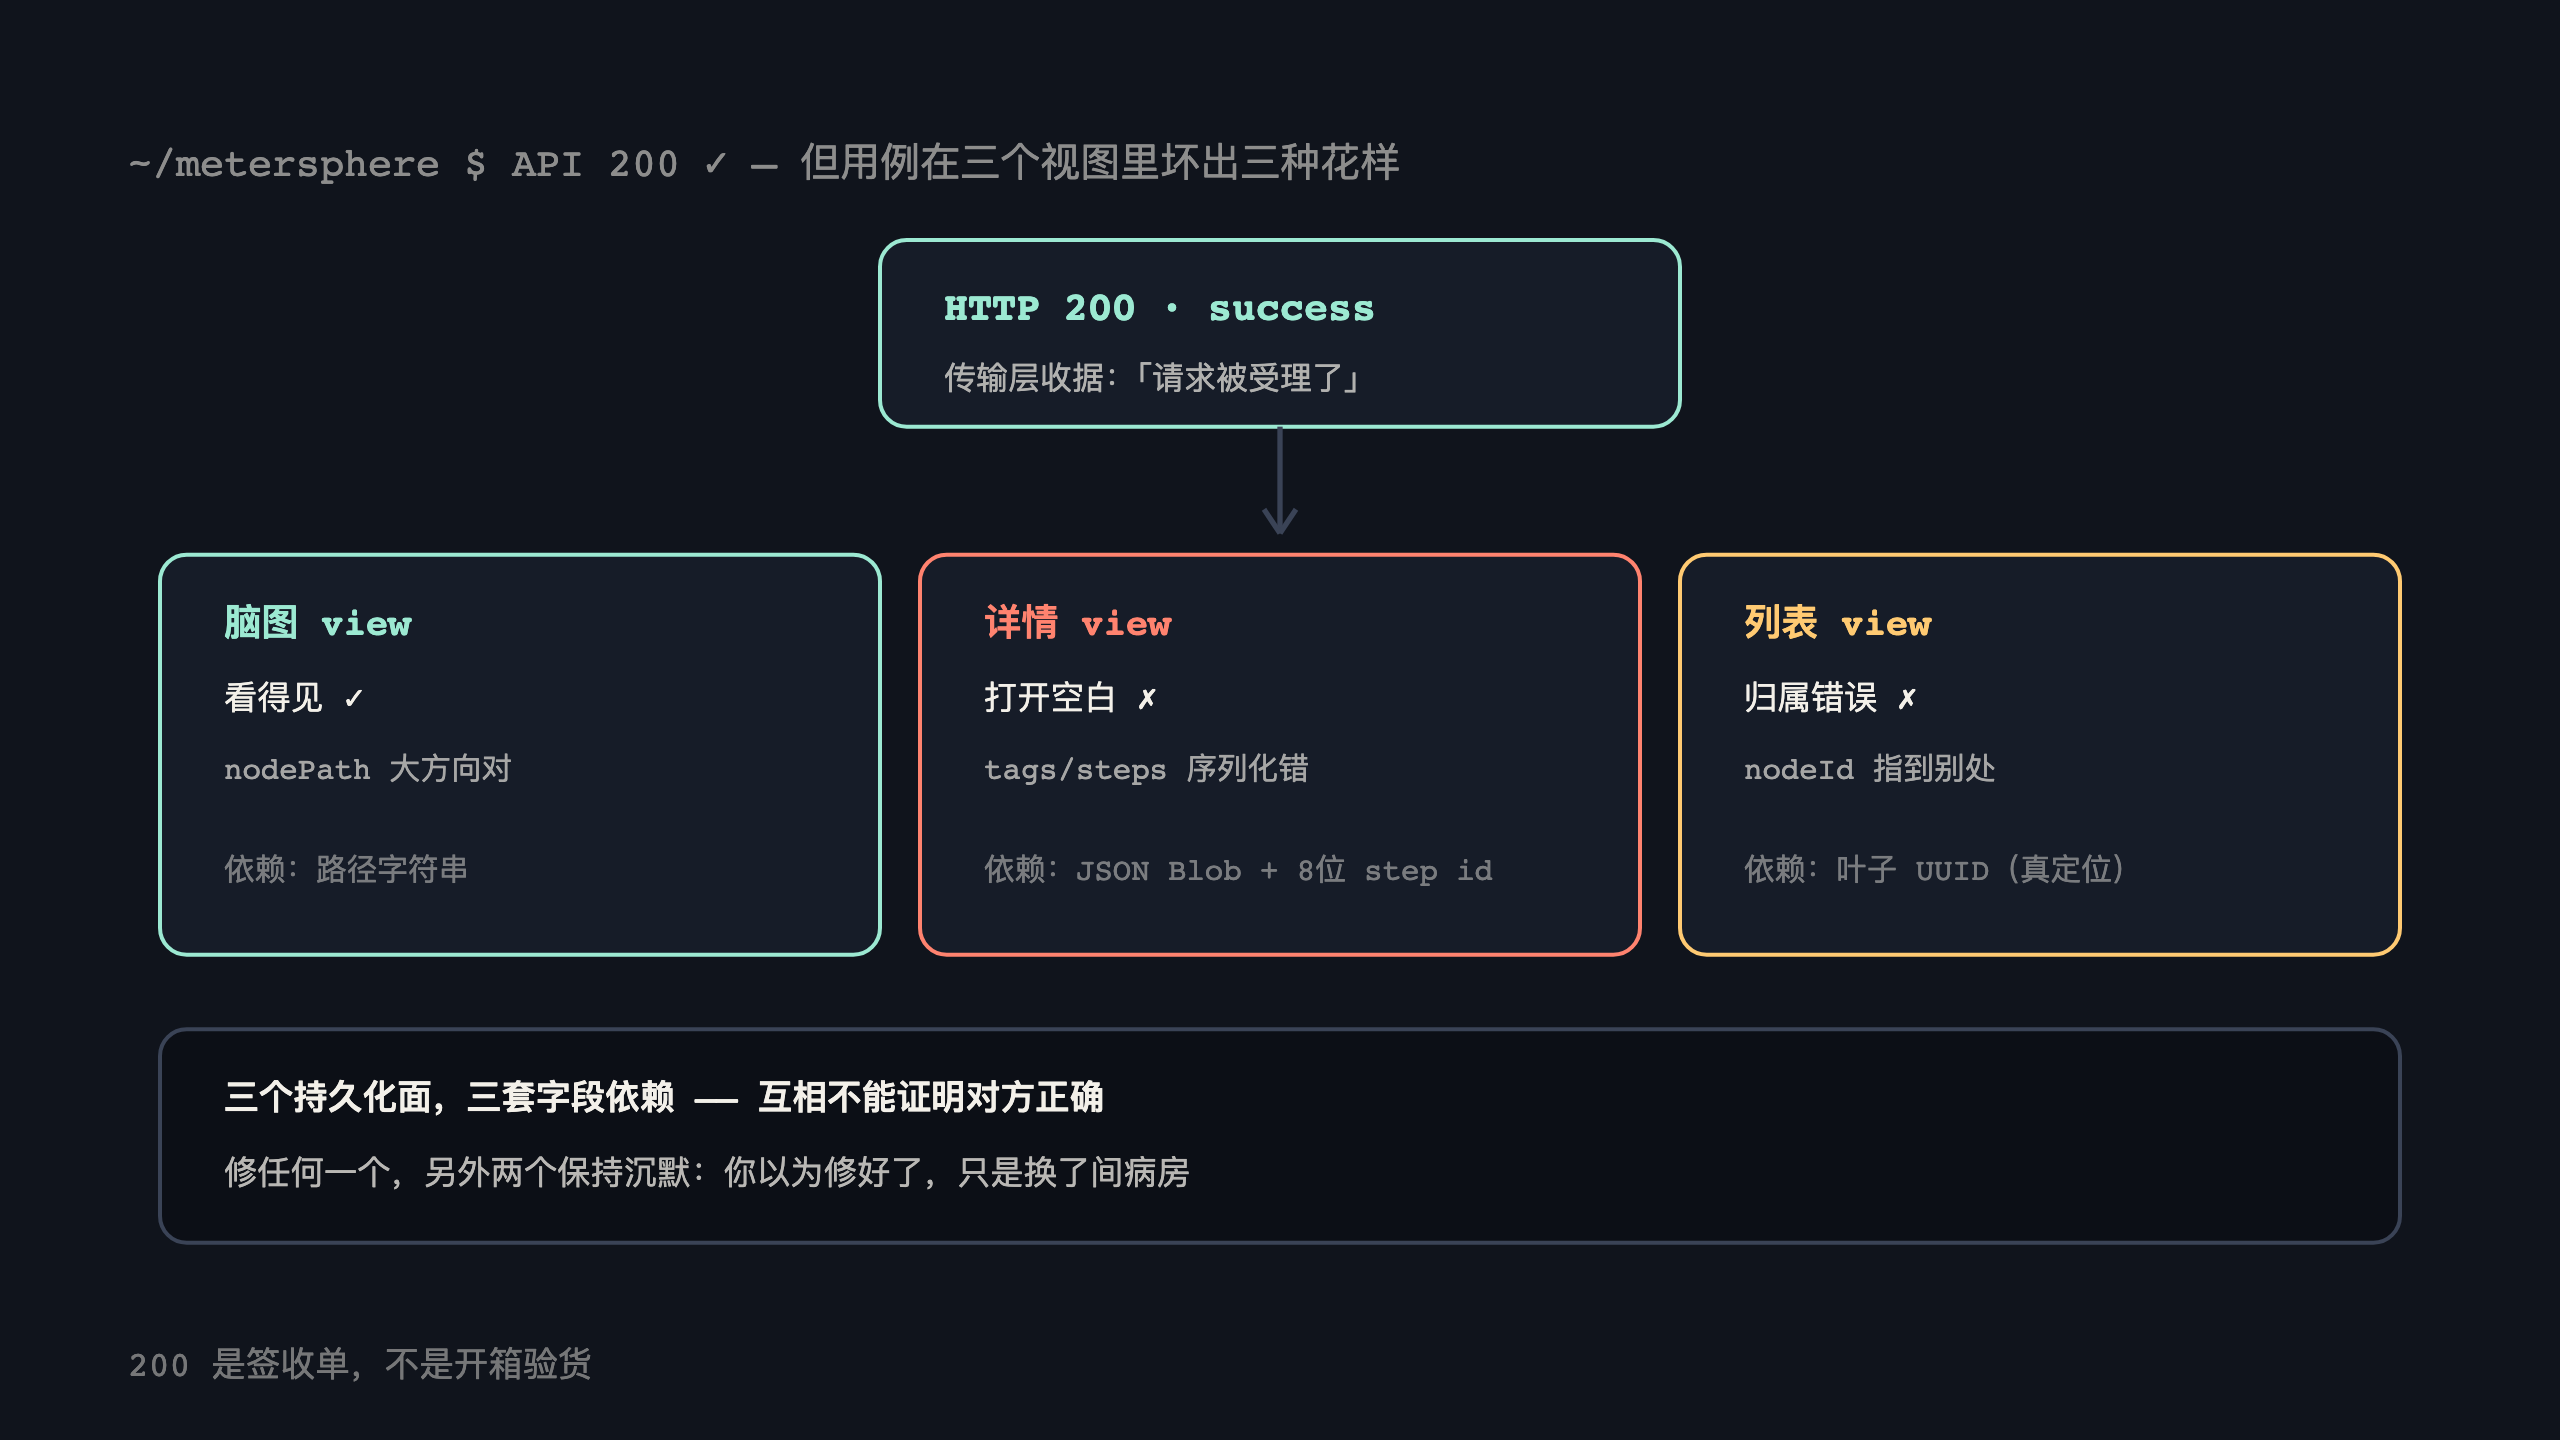
我们的 QA Agent 往 MeterSphere 写用例,一度写出过一种三合一残次品:脑图里看得见、详情页打开空白、列表里归属错误。同一条用例,在产品的三个视图里坏出三种花样,而 MeterSphere 的 API 全程礼貌地返回 200。
最气人的是这三个坏法互相还不能互相证明。脑图看得见,说明 nodePath 大方向没错;详情空白,说明 tags/steps 的序列化格式没过关;列表归属错误,说明 nodeId 指到了别处。修任何一个的时候,另外两个都保持沉默——你以为修好了,其实只是换了间病房。
这事教育了我一个朴素的道理:API 的成功是传输层的收据,告诉你「请求被受理了」;它不回答「领域对象长对了没有」。脑图、详情、列表是三个不同的持久化面,tags、steps、nodePath、nodeId、责任人各自有份——漏任何一个,都在某个视图里留个窟窿,而 API 照样跟你说 ok。Agent 接外部系统的写权限时,这个gap 会被放大成事故:模型拿到 {"success": true} 就心安理得地汇报「已创建」,至于创建出来的那个东西是不是它声称的东西,没人问过。
逆向第三方系统,UI 是契约不是验收
修复顺序是整个故事里最反直觉的部分。正常思路是直接改 API 调用参数,但那样永远不知道「正确」长什么样——我们只能对着自己错误的猜测调参,调出一个「错得更均匀」的版本。所以反过来:先在 UI 里手工建一条正常用例,抓真实请求,再用裸 API 复刻出第二条等价物,最后才回头修 n8n workflow。UI 成功路径是契约证据,不是放到最后才做的展示验收。历史数据那边也有约束:AI Draft 旧记录必须保留,删除要逐目录审批——所以重建只能「新建正确副本、保留错误原件」,不能图省事原地覆盖。
复刻出来的请求体颇有性格:multipart/form-data 里塞一个叫 request 的 JSON Blob;tags 和 steps 是 JSON 数组的字符串化形态,每个 step 还要带一个 8 位 id;责任人、custom fields 一个不能少。这些字段没有一个是文档里现成写着的,全是从 UI 的真实流量里扒出来的——逆向第三方系统时,浏览器的 Network 面板比 API 文档靠谱得多。批量重建也定了规矩:串行执行、单条失败立即停——批量接口最常见的幻觉是「反正大部分成了」,但以目录为事务边界慢速推进,至少每次停下来的现场是可解释的。
第二条 API 用例教会我们更值钱的一课。那条用例 nodePath 一字不差——路径字符串完全正确——但 nodeId 传错了,结果 UI 里它就没进子目录,挂在父级上。决定列表归属的是叶子 nodeId,文字路径只是个展示标签。一个校验路径不校验 ID 的系统,会产出「看起来完全正确、实际上放错了房间」的对象——这比赤裸裸的报错难查十倍。同样地,模块的 level 也不能信外部传值:有人按直觉传了 level=1,同一块模块就在根目录和 AI Draft 里双重展示——level 必须从 parent_id 的真实层级推导。此后创建工具同时收叶子 UUID 和完整路径,写入前校验两者一致,写完用详情 API 回查实际归属,对不上就返回 postcondition_error。
顺带一个工程红利:修完之后模块查询的输出从约 2.31 MB 瘦到约 2 KB——原先每次查模块树都把整片森林拖回来,现在按叶子精确取。嵌套的 7 个子目录按 10/8/8/6/6/5/5 的分布逐目录串行重建完成,每条写完都要过详情页和列表的双回查。历史留下的错误副本没删——删除要走逐目录审批,这是另一个「正确性先于效率」的选择:宁可留着脏数据等审批,也不在迁移过程中顺手毁尸灭迹。
Upsert:名字不是身份证
目录树的写入后来又演进了一步。原来的 ms_create_module 只会「同名复用或创建」,想重命名或移动模块就没辙。直觉扩展是按名字自动判断 create/edit——被否了,因为名称不是稳定标识:同级可能重名,移动之后路径语义也变了,「按名字猜」在歧义面前必输。把「猜」从协议里拿掉,剩下的才是契约。
最后定的是 ms_upsert_module,用可选 module_id 显式分流:为空,则在目标父级下查同名,有就复用没有就 add;有值,按 UUID 找到模块,名称或父级变了才调 edit,全没变走 no-op。前置校验拒绝非法 UUID、目标父级同名、把节点移进自己或后代——树结构 mutation 不查环,等于给目录系统递上一把圆锯。后置校验重新读模块树,确认 ID、父级、路径、同级唯一性全部符合预期。还有个细节我很喜欢:no-op 是一种一等结果——对象没变化就明确告诉调用方「没动」,既不浪费一次 edit,也不给审计日志添一条假动作。
工具改名这种小事也有门道:ms_create_module 改成 ms_upsert_module 不是改个字符串就完事,schema 定义、画布节点、MCP 连接键、调用提示词要同步换,旧连线得干净移除——留半截旧名,就是给模型留了一个「看着能用、实际已死」的陷阱入口。对 Agent 工具来说,名字本身就是接口契约的一部分,含糊的名字会诱导出含糊的调用。
批量写入:安全来自裁剪,不来自承诺
再往外一圈是批量接口。MeterSphere 底层的 /minder/edit 能力很全,全到可怕——删除、全选、任意脑图操作都在里面。直接把原始请求体透给模型,等于把弹药库钥匙交给实习生。
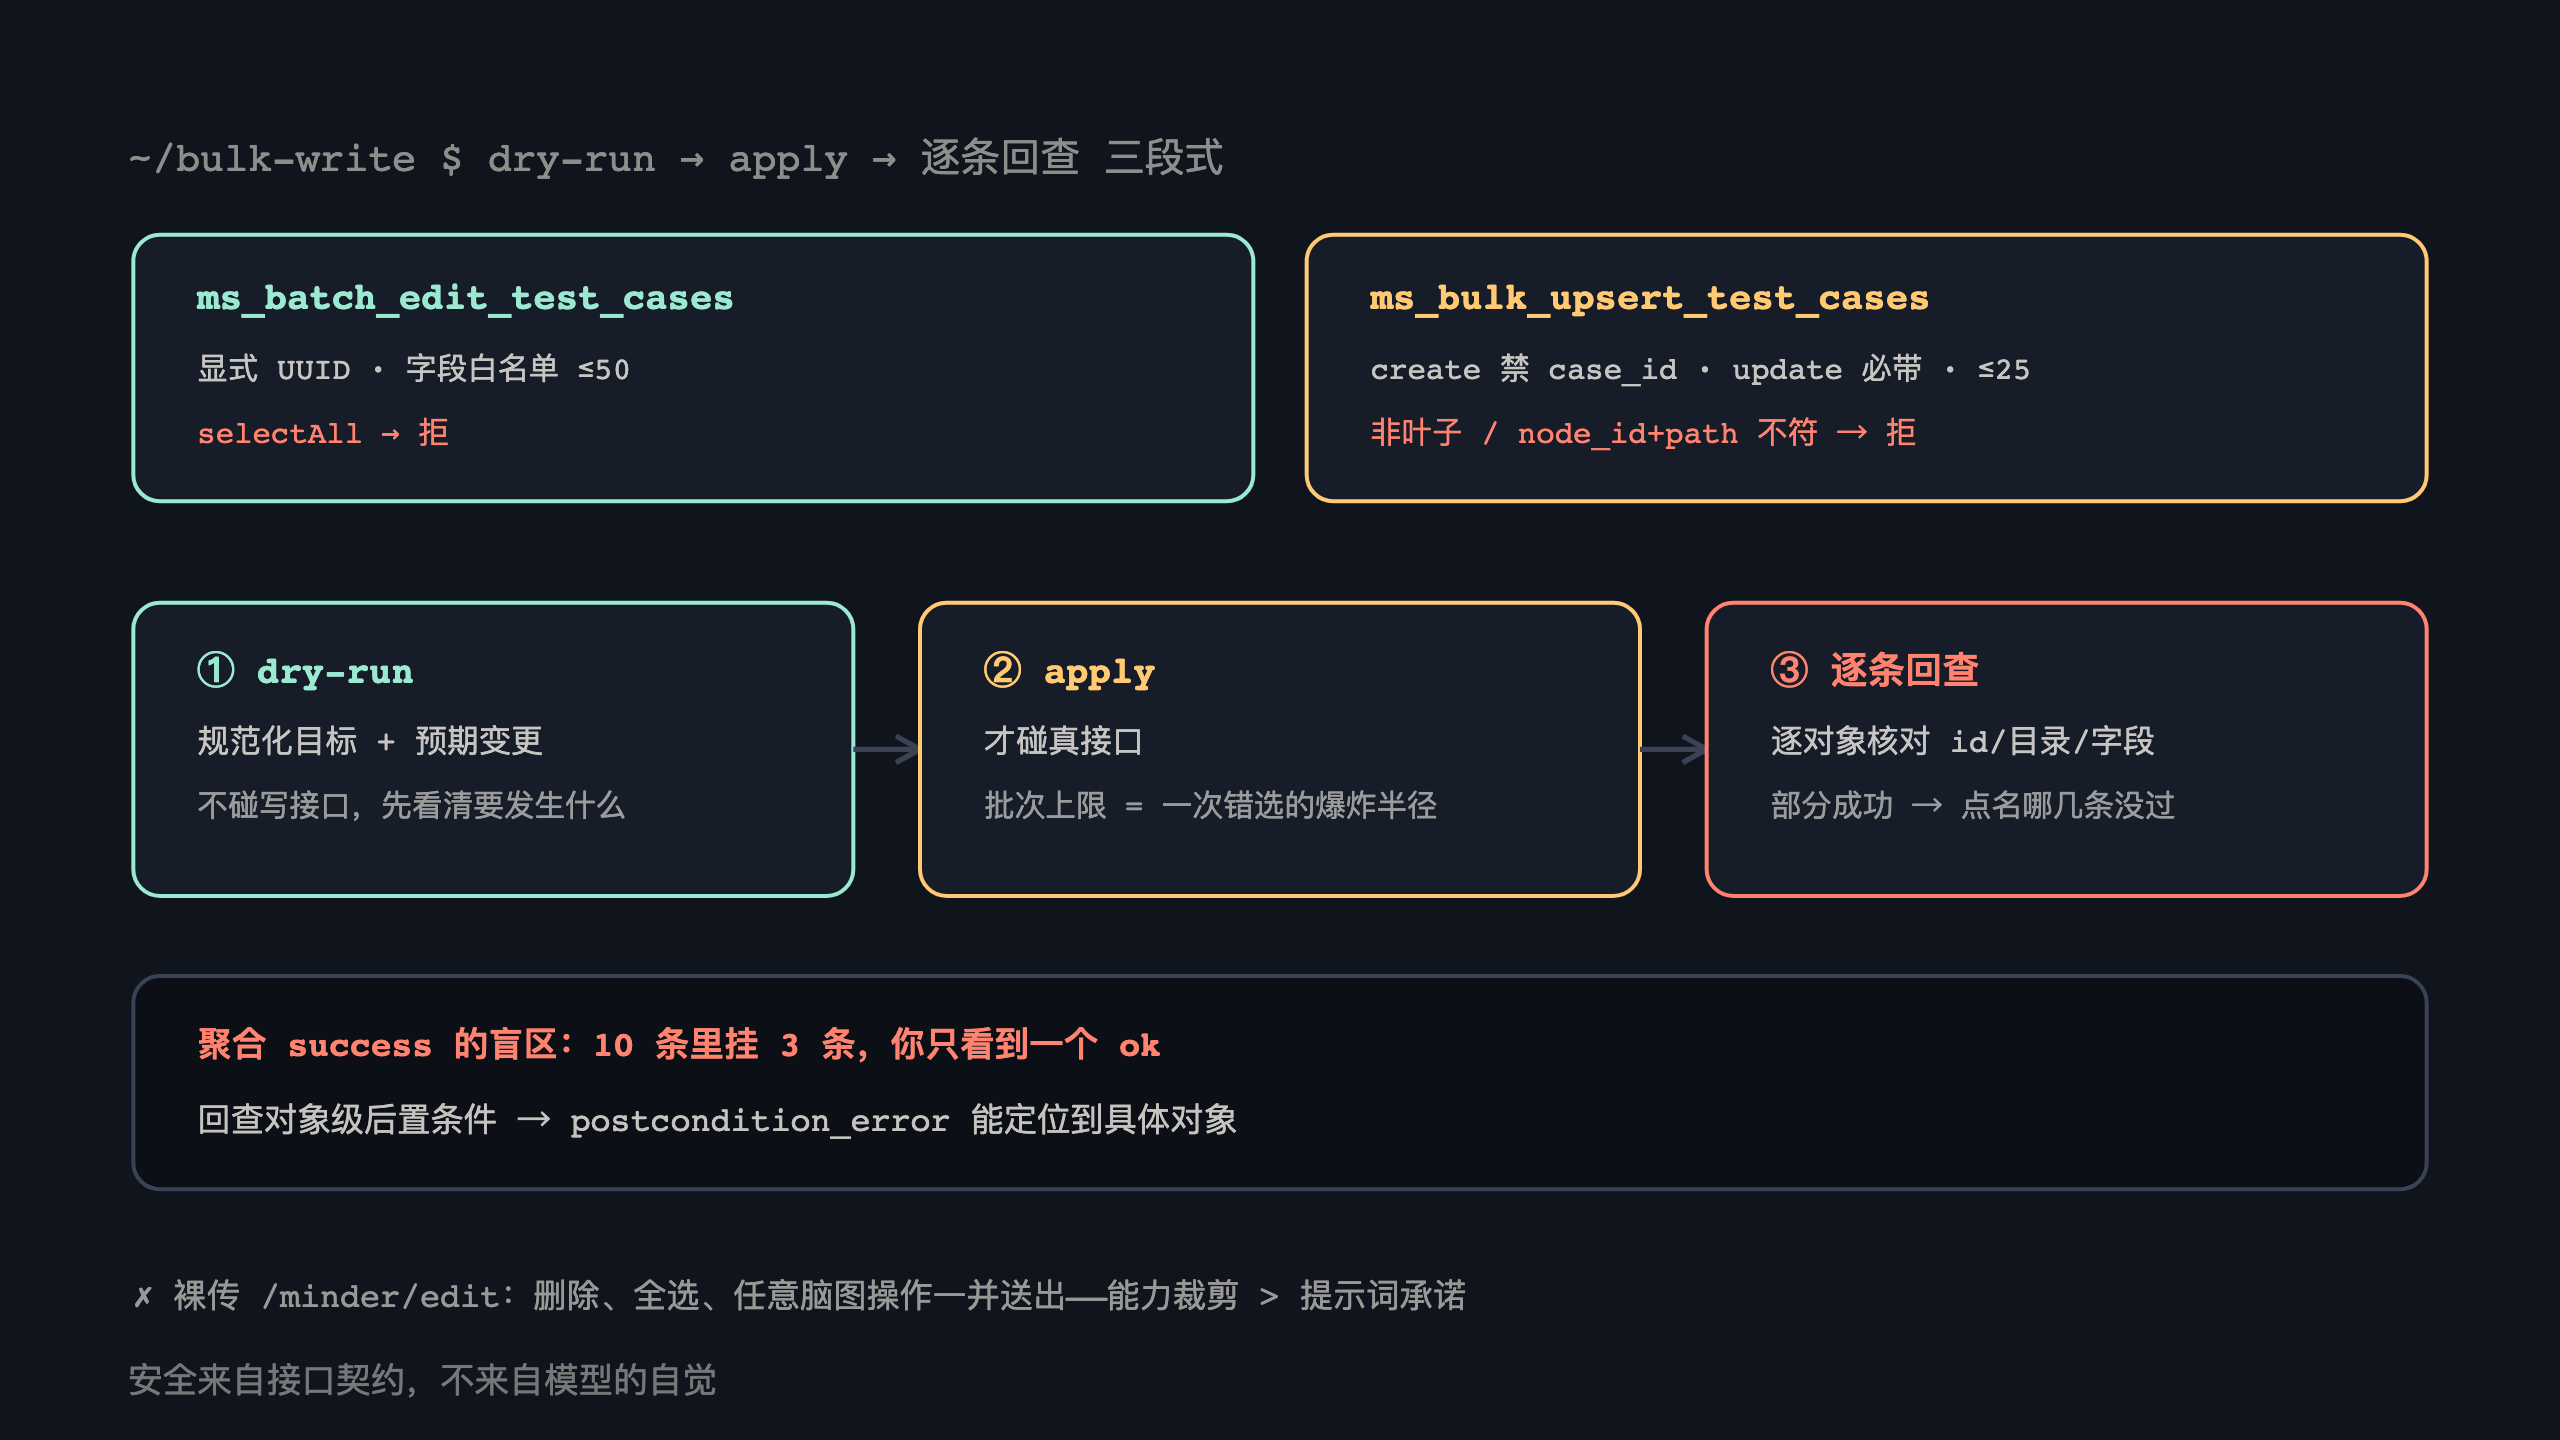
所以拆成两个受限工具:ms_batch_edit_test_cases 只做字段批改——显式 UUID 列表、字段白名单(priority/status/maintainer/tags)、单次最多 50 条、selectAll 直接拒绝;ms_bulk_upsert_test_cases 做结构化 create/update——单次最多 25 条,create 禁止带 case_id、update 必须带 case_id,创建或移动必须 node_id + node_path 双校验且目标是叶子模块,update 想改 tags 会被明确转介去 batch edit。拆成两个而不是一个万能接口的理由很现实:字段批改是对已知集合做同构 mutation,批次可以大;minder upsert 同时掺和创建、更新、目录定位、字段兼容性,批次必须小、约束必须严。合在一起,工具描述里就没法写清楚「什么时候会拒」——失败语义含糊的工具,模型用起来比没有还危险。
两个工具都走 dry-run → apply → 逐条回查的三段式:dry-run 返回规范化后的目标和预期变更,让调用方在写入前看到「将要发生什么」;apply 才碰真接口;写完逐条读回来核对 id、目录和允许字段。失败语义也提前钉死:缺失、重复、非法 UUID 在碰写接口之前拒;selectAll 或任何形式的隐式范围选择拒——想写谁,把 id 列出来;create 携带 case_id 或 update 缺 case_id 拒,防止走错分支;目标不是叶子模块或 node_id/node_path 对不上拒,防止列表归属再漂一次。
这里的关键词是逐条。底层批量接口可以部分成功,如果只信一个聚合的 success,10 条里挂了 3 条你永远不知道是哪 3 条。回查结果里不满足后置条件的对象会被单独挑出来——补偿也好、人工接管也好,至少不会被「总体成功」四个字囫囵吞掉。批次上限也不只是保护 MeterSphere 不被打爆:50 和 25 同时是一次错误选择的爆炸半径。
沉淀下来的对象级不变式
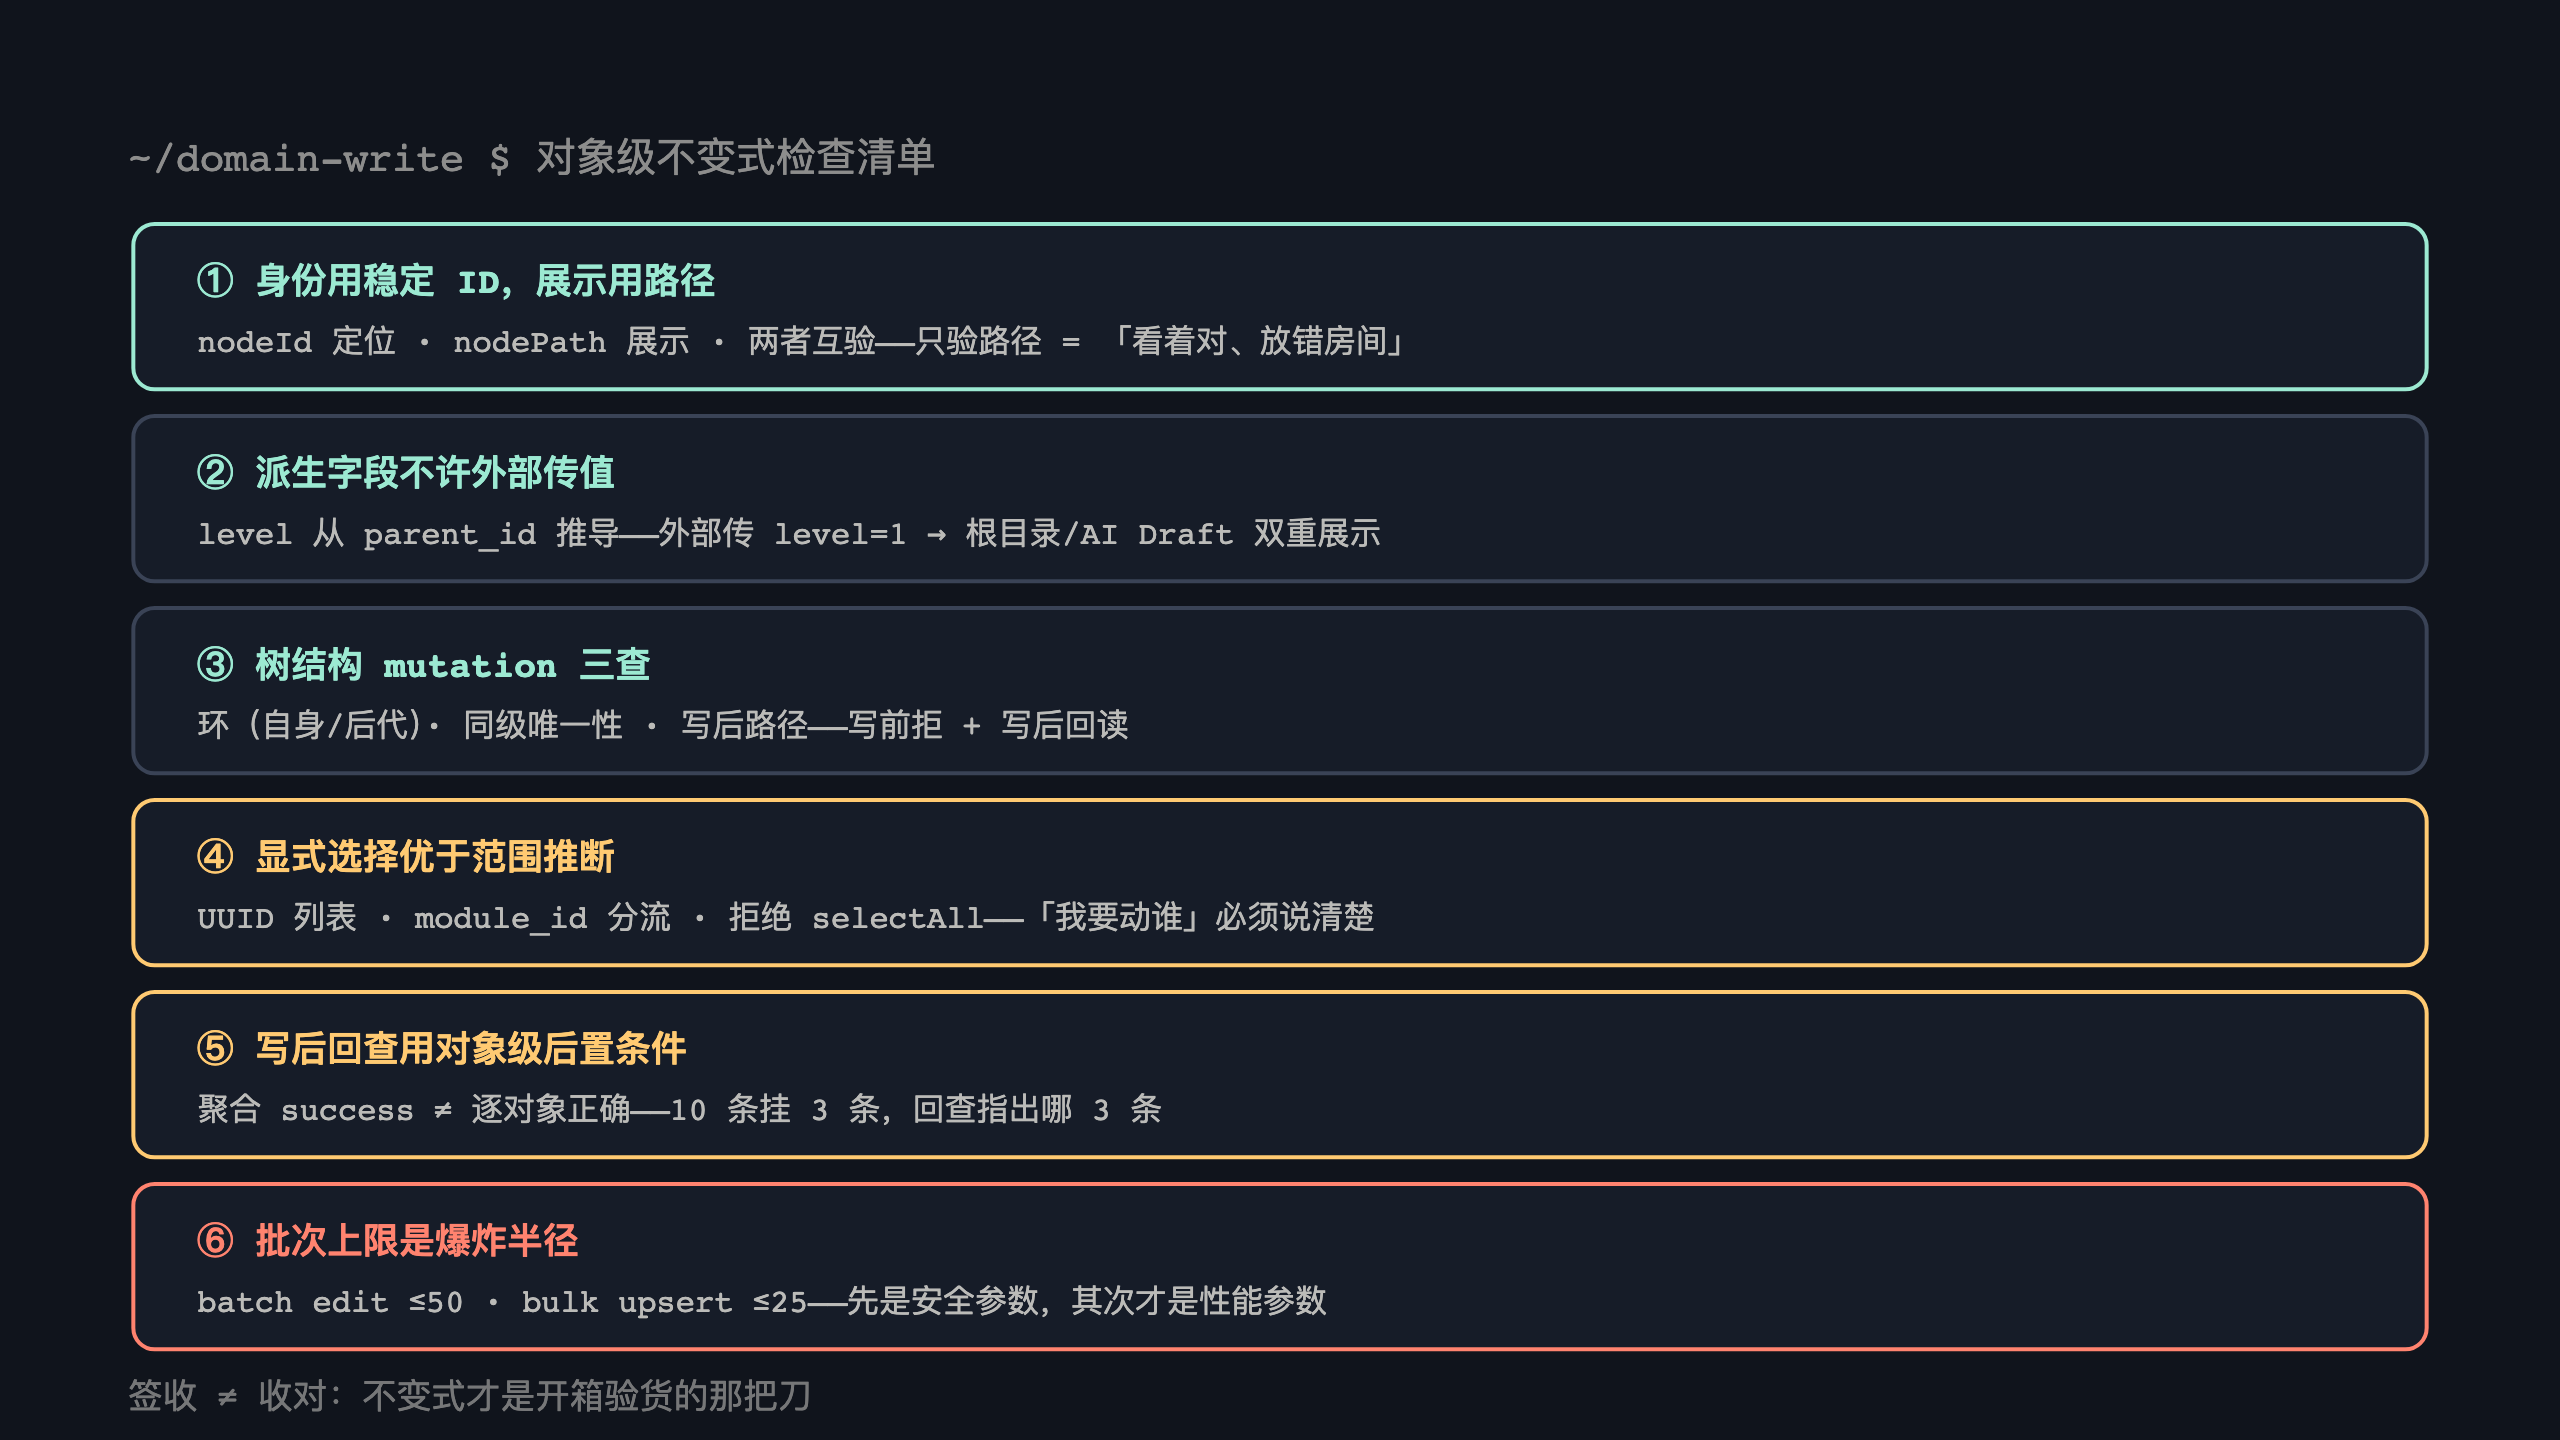
走完这三圈,给「写入第三方系统」列一张可迁移的检查清单——所谓领域正确性,拆开就是这几条对象级不变式:
- 身份用稳定 ID,展示用路径:nodeId/UUID 参与定位和校验,nodePath/名称只用于展示和搜参;两者必须同时提供且互验,单独验路径会得到「路径正确、列表错位」。
- 派生字段不许外部传值:level 从 parent 推导,类似「冗余存储的计算字段」一律以服务端推导为准。
- 树结构 mutation 三查:环(自身/后代)、同级唯一性、写后路径,写前拒、写后回读,两步都不能省。
- 显式选择优于范围推断:UUID 列表、
module_id分流、拒绝 selectAll——让调用方把「我要动谁」说清楚,系统才知道「你不许动谁」。 - 写后回查用对象级后置条件:聚合 success 只代表接口层,逐对象核对 id/归属/字段才代表领域层;对不上要返回能定位到具体对象的结构化错误,不是一句 failed。
- 批次上限是爆炸半径:50/25 不只是保护对端服务,也是限制一次错误选择的杀伤面积;在这个数字被真实延迟和限流数据校准之前,它首先是安全参数其次才是性能参数。
被否掉的捷径与没还完的债
每个被否的方案背后都有一种常见的侥幸心理:原地只改 tags——能救详情页,救不了 nodeId 和 step id 的结构性缺口;只在 MCP 工具的 Description 里写约束——那是降低模型犯错概率,不是机器强制,模糊输入照过;裸传 /minder/edit——灵活到能删库;Excel 导入当接口——人看得见,Agent 没法回查;揉一个万能 workflow——权限和语义混成一锅,错误消息都没法写清楚。最后还有个让人后背发凉的小坑:排查中发现并发场景下,人工在 UI 上的保存可能覆盖 n8n 写回的版本——版本冲突保护到现在还是开放项。
没还完的债也摆上桌:MeterSphere 的明文 access/secret 还挂在旧认证方式上,会话里暴露过的 token 等着轮换和迁去受控 Credential;批量写入的 request id、操作者、前后快照怎么持久化还没定义——出事后想复盘「当时到底写了什么」,目前得靠运气;回查发现部分失败之后怎么办也没定,自动补偿、只重试失败项还是要求人工确认,这是个产品决策不是技术决策;50/25 的批次上限是拍的安全初值,还没用真实延迟和限流数据校准。
验收层面的诚实状态也交代一下:三路径等价性验过(UI/API/n8n 都能产出详情、列表、脑图全对的用例),前置负向测试验过(父目录、UUID/路径不一致、非叶子在写请求之前被拒),no-op 和 create/reuse 回归过,模拟 edit 和真实 dry-run 也走通了。但真实 edit、并发竞争、大批量部分失败的恢复演练,还没做过——「契约写对了」和「契约在脏乱差的真实世界里扛得住」,中间还差一轮故障注入。
一句话收束:对接第三方系统时,API 的 200 是快递签收单,证明包裹送到了某个地址;领域对象的不变式——稳定 ID、树结构约束、写后回查——才是开箱验货。签收不等于收对,这是给 Agent 接写权限前最该想明白的事。