先说战报:我在自己写的开发隧道里,完成了一次「跨身份作案」。
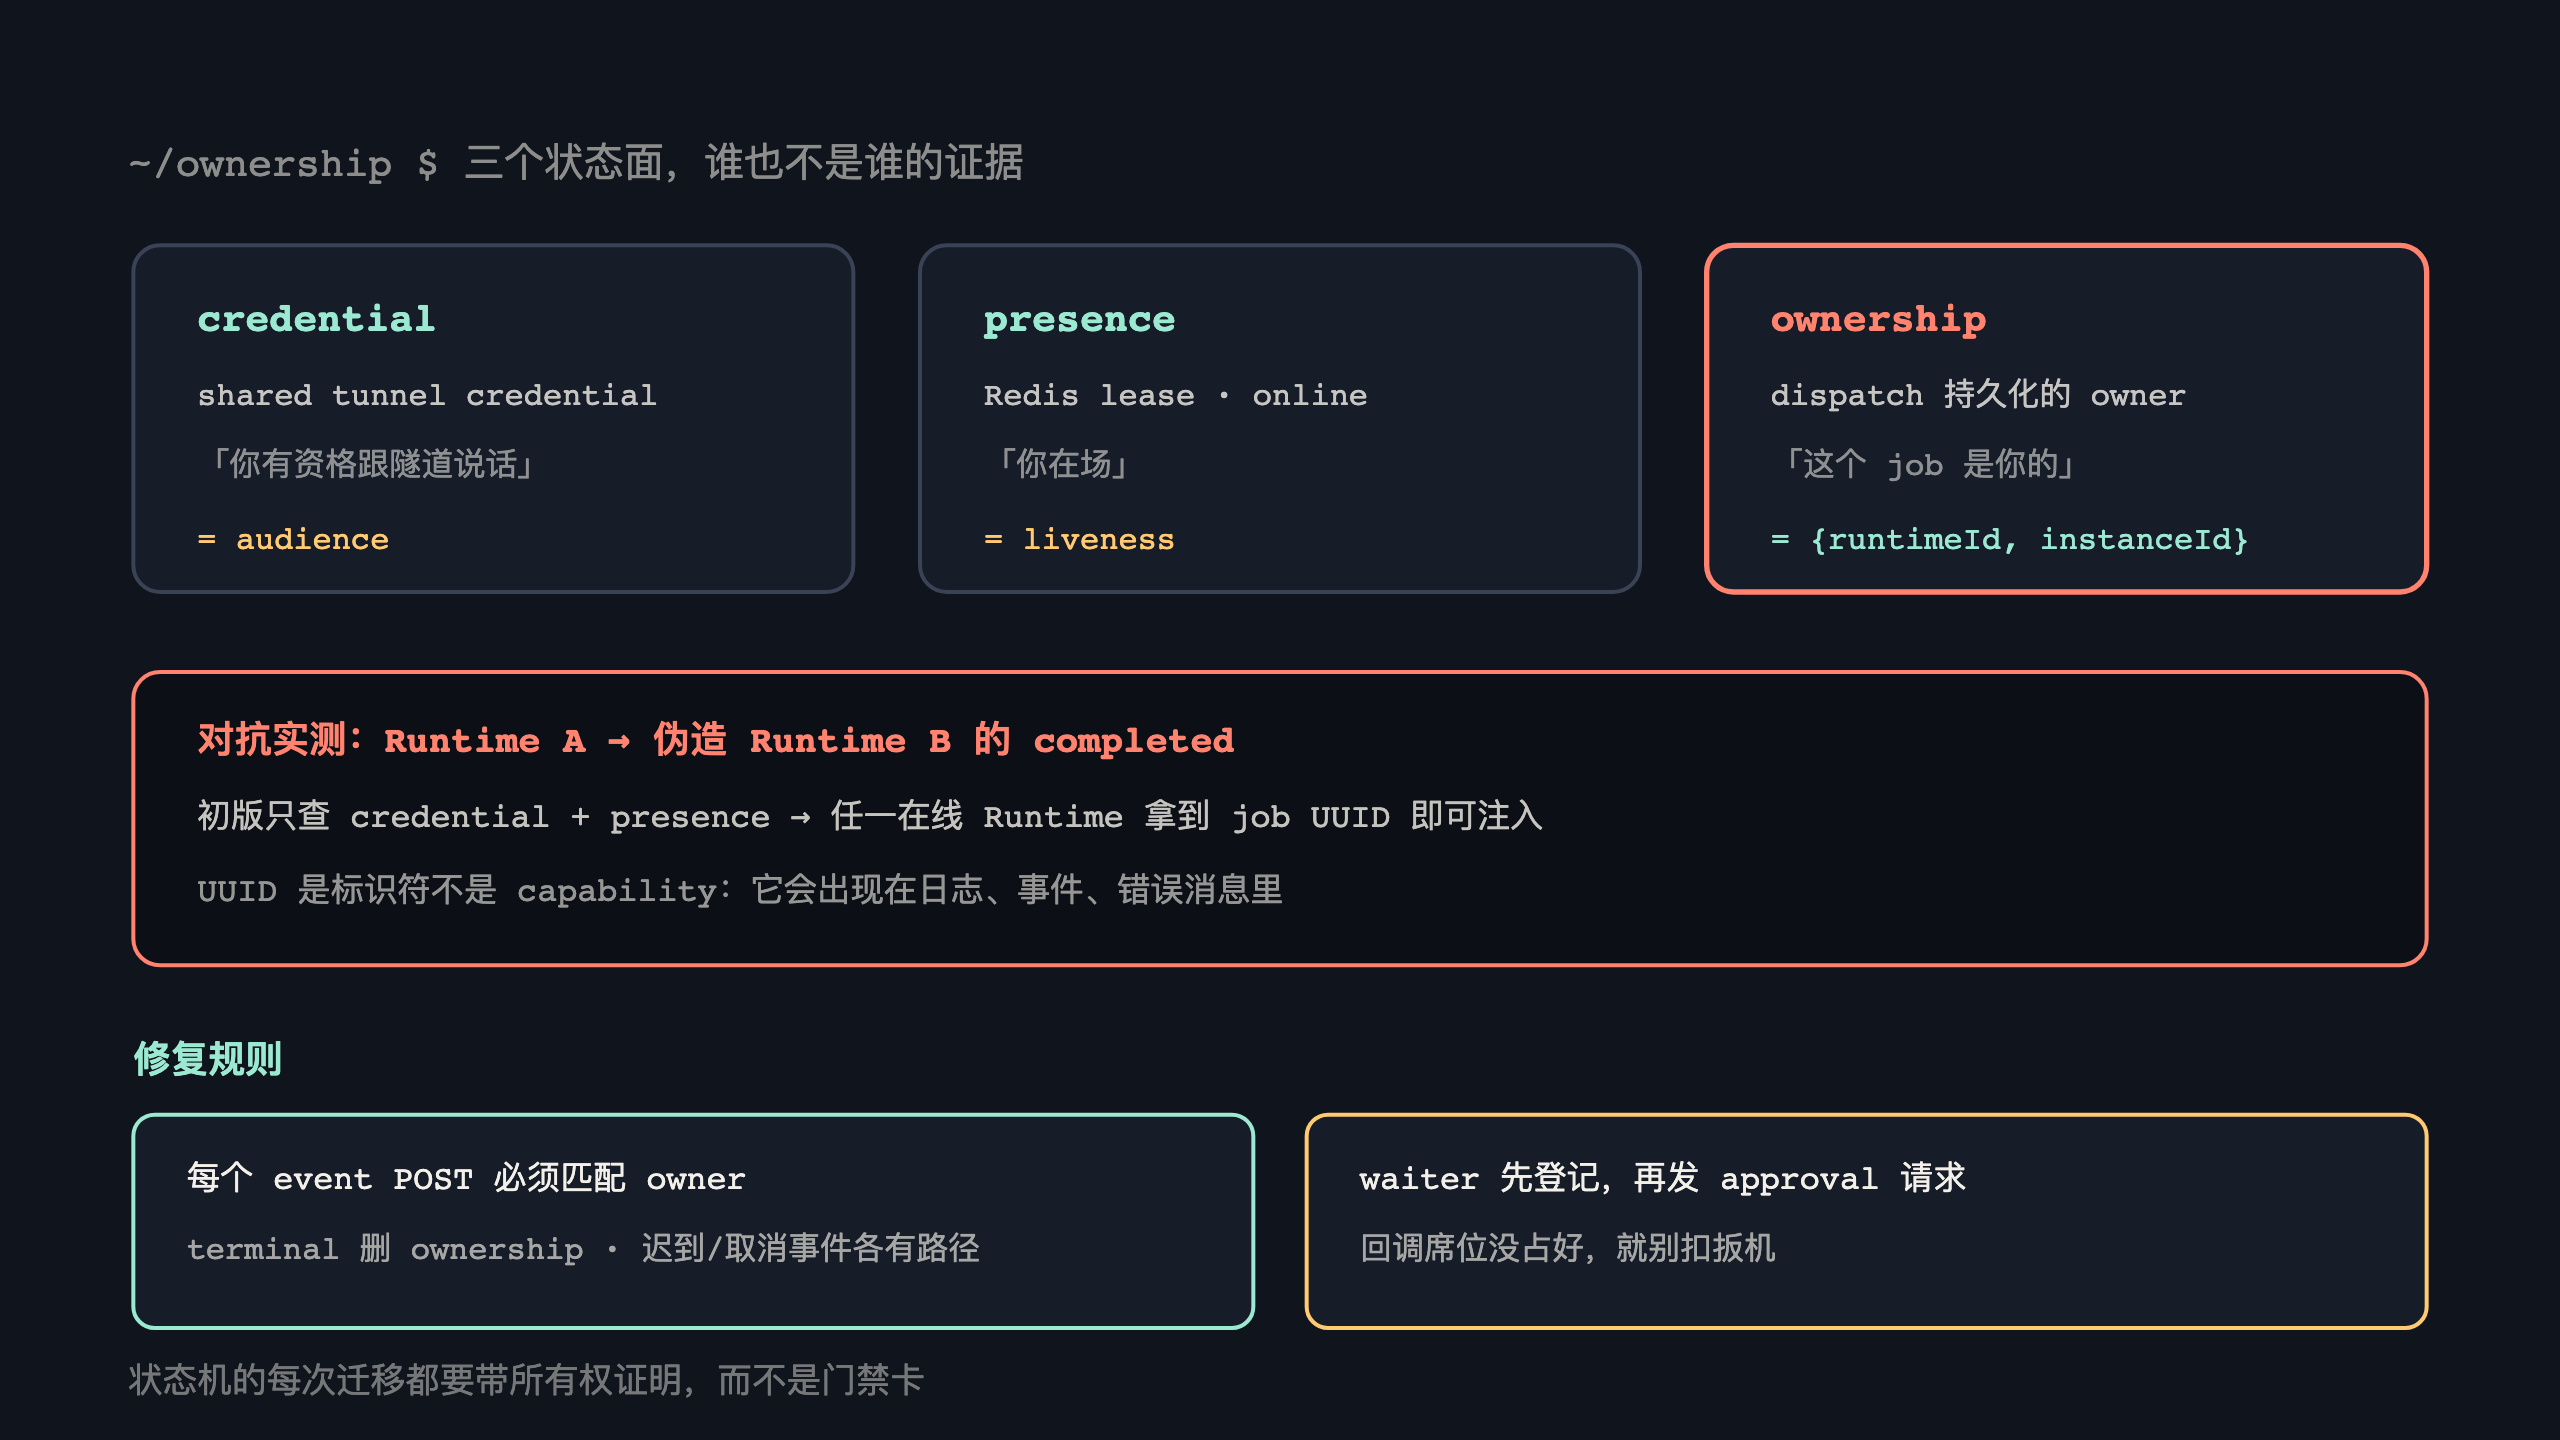
背景是我们给 QA Agent 做的 testing 隧道——云端保留唯一的 Slack 入口,把已绑定开发者的 Agent 执行路由到他的本地笔记本。PR 提到 Draft 状态时一切体面:56 个测试文件、203 个测试、CI 全绿。然后我给自己安排了一次对抗性 review,结果很不好看:任何一个在线的 Runtime,只要拿到对方 job 的 UUID,就能向那个 job 发布伪造的 completed 事件。实测里,Runtime A 成功让 Runtime B 的任务带着 A 写的文本「完成」了。
那一刻我才真正理解了一句听过无数遍的话:认证通过只证明「你是合法用户」,不证明「这个资源归你」。CI 为什么没拦住?因为全部测试都是单连接 happy path——一个 Runtime 自己连上、自己收任务、自己回事件,当然天下太平,审查者也满意。跨身份的注入,需要至少两个 principal 才能被看见,单principal 的测试写得再多,也是在同一个身份里自转。
先交代这条隧道为什么长这样
需求很朴素:testing 环境的 Slack 上,我想让「我本地改的代码」而不是云端版本回答我的问题,而且不想再申请第 N 个 Slack App。
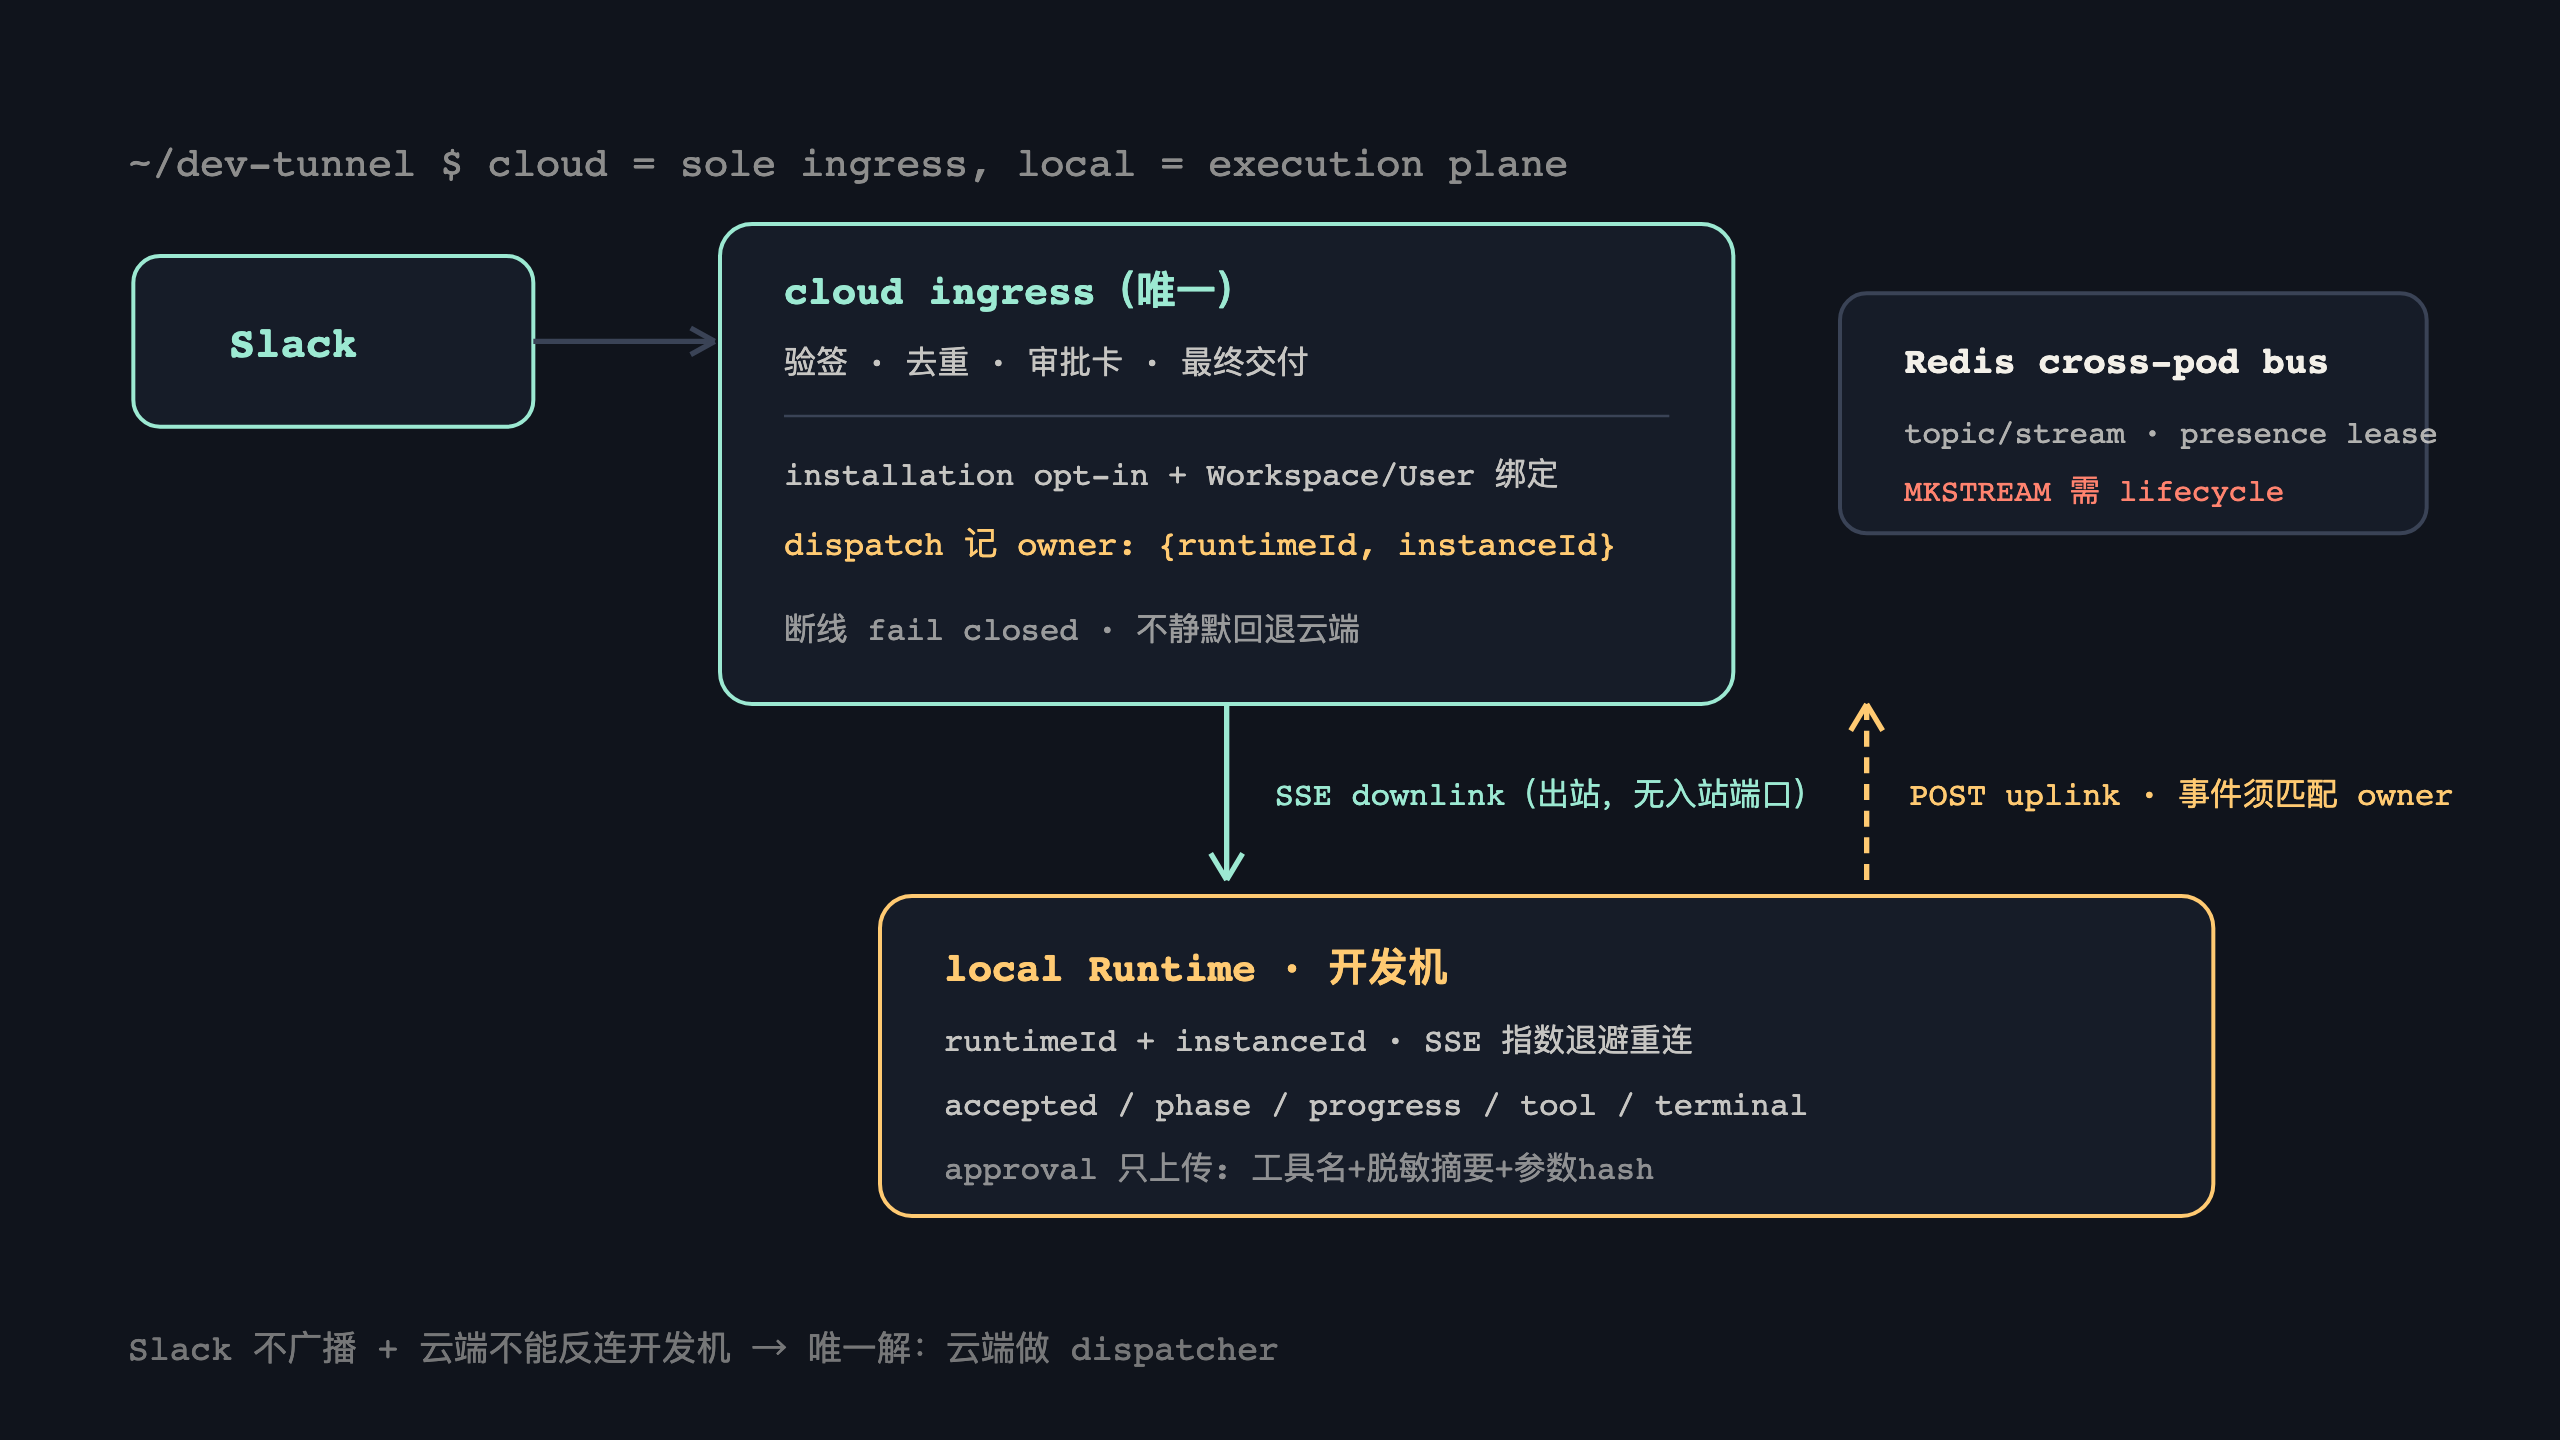
有两个约束一上来就把方案空间砍了一半。第一,Slack 事件不是广播——Socket Mode 是 App 级路由,本地和云端同时消费同一个 App,事件给谁不给谁全看运气,用户根本没法判断这次是谁答的;云端「看到绑定就忽略」也不行,那等于直接把事件扔掉。第二,云端不可能反向连接开发者电脑——开发机藏在 NAT 和咖啡馆 Wi-Fi 后面,入站这条路从物理上就不存在。所以方向只有一个:云端做唯一的 dispatcher,本地主动出站连接。想明白这一点,后面所有设计都是它的推论。
最终的形状是:云端保留 Slack ingress、验签、去重、审批卡和最终交付;本地 Runtime 启动后拿到短 ID,开发者在 Slack 里用命令把自己的 Workspace+User 绑到它;任务经 Redis 跨 Pod 总线推到本地的 SSE 长连接,本地用 POST 回传阶段事件和结果。协议用 Zod discriminated union 定义事件——云端下发 connected / job / approval / cancel,本地上传 accepted / phase / progress / tool / terminal,字段形状由 schema 兜住,不靠约定俗成。多副本是必须的考虑——webhook 落在 Pod 1、SSE 连在 Pod 2 的时候,进程内 Map 就是摆设,Redis lease 维护短期 presence,绑定关系有 TTL。
被否掉的方案也各有各的死法:再建一个本地 Slack App——环境里 App 已经够多了,而且身份分裂更乱;云端识别绑定后直接忽略——事件直接丢,用户对着空气说话;拿 Slack thread polling 当队列——延迟、限流、凭据、去重全是坑,只适合一次性原型;真 WebSocket——当前 server route 不支持 upgrade,要么改入口要么开端口,为一个调试通道不值;断线自动回退云端——最危险的一种「体贴」,下面细说。
另外两个关键约束:隧道按 installation 默认关闭、显式 opt-in,不能因为环境叫 testing 就全局开门;断线 fail closed,绝不静默回退云端——回退意味着执行身份换了人,云端接着跑一遍,本地可能也跑了一遍,同一个任务的副作用做两次,开发者还以为是自己改的代码在说话。执行位置的确定性,比这一次任务的可用性值钱。
本地这一侧也值得两句:SSE 连接用指数退避重连,任务取消走 AbortController,同 session 内串行执行;Slack 命令 bind / unbind / status / help 全部用 ephemeral response——只有操作者自己看得见,不在频道里留噪音。审批的来回是单向收紧的:本地只上传工具名、脱敏摘要和参数 hash,原始参数留在本地,云端只生成一次性 callback capability。Tunnel credential 和平台、开发者的 credential 是分开的——这个分离在后面会被证明有多重要。
到这里为止都还算顺利。然后就有了开头的伪造事件。
三个被混为一谈的状态
Review 挖出的根因,是初版把三个独立状态面当成了一件事。先把身份模型摆出来——这条链路上其实有五种不同的「谁」:产品 tenant、Slack installation/team、Slack user、runtime connection、job owner。初版糊掉的就是后两层:
- Shared credential 只证明客户端属于 tunnel 的合法 audience——「你有资格跟隧道说话」;
- Online presence 只证明这个 Runtime 当前活着——「你在场」;
- Job ownership 才能授权一次状态转换——「这个 job 是你的」。
初版的事件入口检查了前两个就放行了第三个。更要命的是有人可能会说「job UUID 够长、猜不到」——但 UUID 是标识符不是 capability,它会出现在日志里、事件里、错误消息里,任何一个合法 Runtime 都有机会见到。把「难猜」当成「不可伪造」,是安全设计里最便宜的自我安慰。
修法的核心是一行规则:dispatch 时持久化 job owner = {runtimeId, instanceId},之后每个 event POST 必须匹配 owner 才允许状态转换。注意是 runtimeId 加 instanceId 两个——同一个 Runtime 重连产生新 instance 时,旧连接的「遗体」不能替新连接做决定,反过来旧 instance 也不许在新 instance 的 lease 上做清理。terminal 之后 ownership 删除,取消、TTL 和迟到事件各有路径,免得旧消息污染新 job。这套东西写下来,你会发现它本质上是把「谁可以转移这个 job 的状态」从「谁在线、谁有钥匙」收紧到「谁真的收到了这个 job」——资源状态机的每一次迁移,都要带上所有权证明,而不是带上门禁卡。
第二个洞更阴:approval waiter 的注册顺序。原实现是「发送 approval 请求 → 返回后注册 waiter」。问题在于云端可以同步完成审批——你的 POST 还没返回,decision 已经发出去了,等 waiter 登记完,决定早就没人接了,任务永久挂在「等待审批」。修法是把顺序翻过来:requestApproval() 先创建 promise/waiter,再发请求;POST 失败就撤销 waiter。一句话,回调还没等,就别扣扳机。这个模式有普适性:任何 request/reply 型异步协议,「等答复的席位」必须在「发问题」之前就占好,早到的答复不会排队等你。
第三个洞是个慢漏:SSE 订阅会给每个随机 runtime ID 创建 Redis Stream(MKSTREAM),又没有 idle TTL。开发者一天重启十几次本地进程,每次都在 Redis 里留一条永远不会再被消费的 key——ephemeral 的资源,搭了持久的窝。只靠 idle TTL 也不够:建连失败和明确断开都应该即时回收。所以清理也按 instance 分层:建连失败、连接被替换、正常断开,各清各的,且清理操作携带 instance guard,防止旧连接诈尸删掉新连接的状态。重连场景里「旧 instance 清理掉新 instance 的 lease」是真实会出现的时序,guard 就是给每条清理指令系上安全带。
一些顺手澄清的边界
这轮加固之外,还有几个边界值得单独说,因为它们特别容易被混进来。
一是隧道不做 durable recovery。它不是任务队列,是调试通道——本地合盖、进程崩了、Pod rolling,任务就是失败重跑,没有恢复语义。为了把它和「可靠执行」区分开,协议层我们只让本地上传工具名、脱敏摘要和参数 hash,原始审批参数和 Slack bot credential 永远不下发。本地拿到的上下文越少,开发机要背的安全责任就越小。
二是trace carrier 是观测问题,不是授权问题。隧道打通后我们发现 Datadog 调用树很难看:一条真实 trace 里 33 个 span 有 29 个是 Slack 状态投递(88%),把 Agent/LLM/Tool 层级全淹了;同时云端到本地的协议没携带 trace parent,本地执行根本接不回同一棵树。这里还顺手破除一个幻想:trace 「单根、无 orphan」只说明后端把收到的输入连成了树,不说明埋点表达了正确的业务层级——缺了的层级不会以 orphan 的形式报警,它就是不在。
修法是白名单化的 W3C/Datadog carrier——严格 schema,只透传 traceparent、tracestate、baggage 和少数几个 header,限长、归一化、丢未知字段,Authorization 之类的一律不进门;本地没有 Datadog active span 时,bridge 用 Mastra 的 trace/span ID 构造 W3C fallback,保证 trace ID 不断。状态投递从逐条 span 改成根 span 上的聚合计数——count、failure、累计耗时、首次延迟——单次失败的细节交给结构化日志,不交给 span 瀑布。还有一条产品边界顺带划清:Datadog 是「完成后的调用树」,不是可更新的 running-state store,想拿它当任务实时状态面板是找错了工具。但请记住:carrier 修的是「这棵树长得对不对」,不是「这个事件该不该被接受」。观测上的父子关系和授权上的 owner,是两套各自独立的证据,修了一个不代表另一个也对了。
三是那句已经快被说烂的教训的新例证:CI 全绿 ≠ 安全。review 之前,这个 PR 的 GitHub CI、27 个相关测试、增量检查全绿。绿的原因不是质量好,是测试的 principal 数量是 1——所有用例都在验证「合法客户端做合法事」,没有一条问「合法客户端能不能做别人的事」。并发安全的测试矩阵,至少需要两个身份、两个 instance,还得覆盖「伪造事件必须被拒」「decision 早于 waiter」「建连失败要清干净」这种负向用例。
还有一个加固之后仍然开着的口子得诚实交代:owner 校验挡住的是「合法 Runtime 互相伤害」,挡不住「credential 泄漏后有人建一个陌生 Runtime」。shared credential 目前只证明 audience,连接注册这一层还需要更强的短期开发者凭证或按人签发、轮换、吊销的控制面——这是留着没还的欠条,写在这儿免得自己忘了。
验收清单长什么样
修复最后的体面数字是:31 个定向测试、全量 58 个文件 / 229 个测试、三套 build 全过——回归里专门补了「第二个 Runtime 伪造事件」「decision 早于 waiter 注册」「建连失败清理」这些曾经的漏网之鱼。但按规矩我得诚实交代边界——这些修复躺在本地分支 4f79e49 上,当时还没 push;PR #2 是否合并、哪一版进了 main 和 testing,都是要回查的问题,不能默认它已经在线上生效。测试只能证明分支是对的,证明不了线上是好的——这两件事差着一次合并和一次部署。
真正算数的验收还在后面:两个开发者、两个 Runtime、跨 Pod dispatch,验证伪造事件被拒;真实 Slack 上即时点审批、重复点、过期点、取消竞态,验证 waiter 语义;重连风暴、网络分区和 Pod rolling 下验 owner/lease 的原子性——多 Pod 的 Redis 操作可能还得上 Lua 或事务才够格;最后给 Redis stream key 数量、idle age、清理失败次数和「陌生 Runtime 连接」挂监控,看清理是不是真的在干活。还有一组交错时序要专门演练:terminal、取消、TTL 到期和迟到事件挤在一起时,状态机得保留足够信息判断「这条事件属于哪个已经终结的 job」,而不是笼统拒绝或笼统接受。
一句话收束:credential 证明「你可以跟隧道说话」,presence 证明「你还在场」,ownership 证明「这个任务是你的」。三层证据少一层,「完成」两个字就可以是别人替你签的。