事故发生在 moego-k8s-apps 的 PR #328。冲突本身小而清晰:main 的自动部署流程持续刷新元数据,分支这边要给 qasey 的 overlay 加一行 name: moego-qasey-api——这行 target 是保险丝,防止 replica removal patch 误伤到新加的 worker Deployment。语义一句话能说清,合并按理十分钟收工。
解冲突、跑 kubectl kustomize 验证——worker 保持 4 副本、sandbox 保持 2 副本,patch 精确落在 API Deployment 上;本地搜一遍冲突标记,干干净净;提交、推送、收工。
然后用户截图来了:PR 的文件列表里躺着 6 个不该出现的文件——一个 moego-bff 的 YAML 被重新格式化,五个文件的 timestamp 被刷新。我手工编辑的那 1 个冲突文件毫无问题,问题出在我从没打算碰的 6 个文件上。
冲突解对了,PR 还是脏了。 这个事故教我的东西,值得写进每个有自动更新 base 的仓库的合并清单第一行,且最好加粗。
三个 diff,三个不同的问题
复盘时我才想明白,「这次合并改了什么」从来不是一个问题,是三个:
工作树 diff 回答「我刚改了什么」——我的手工编辑,1 个文件,语义正确。merge result 回答「合并后的树是什么」——main 的自动更新全量进入暂存区,这些是合并的合法内容。PR diff(相对最新 base) 回答「评审者最终会看到什么」——这才是验收面,而我此前根本没看过它。
三个视角一个都不能省,也不能互相替代。工作树干净只证明你的手工编辑对;merge 结果合法只证明合并语义对;而提交钩子作用的单位是「整个暂存区」——merge 从 main 带进来的每一个文件,在钩子眼里都是待处理的输入。我那 6 个噪音文件就是这么来的:YAML 格式化器不认识「这个文件是 merge 顺带带进来的,不是我要改的」,timestamp 生成器也不认识——它们对整个暂存区一视同仁地「好心帮忙」。
把钩子这个「作案机制」再放大看一层:钩子的设计意图是「让提交更规范」,默认假设是暂存区里的内容≈「这个开发者想改的东西」。merge 恰恰打破这个假设——暂存区里坐着两类乘客,「我要交付的改动」和「合并顺带捎来的 base 更新」,钩子在物理上分不出两者的区别,于是把对前者的善意原样施加给后者。这不是某个钩子写坏了,是**「按暂存区处理」的钩子和「merge 会扩大暂存区」的语义天然相斥**——只要这两个事实共存,同类事故就会周期性复发。
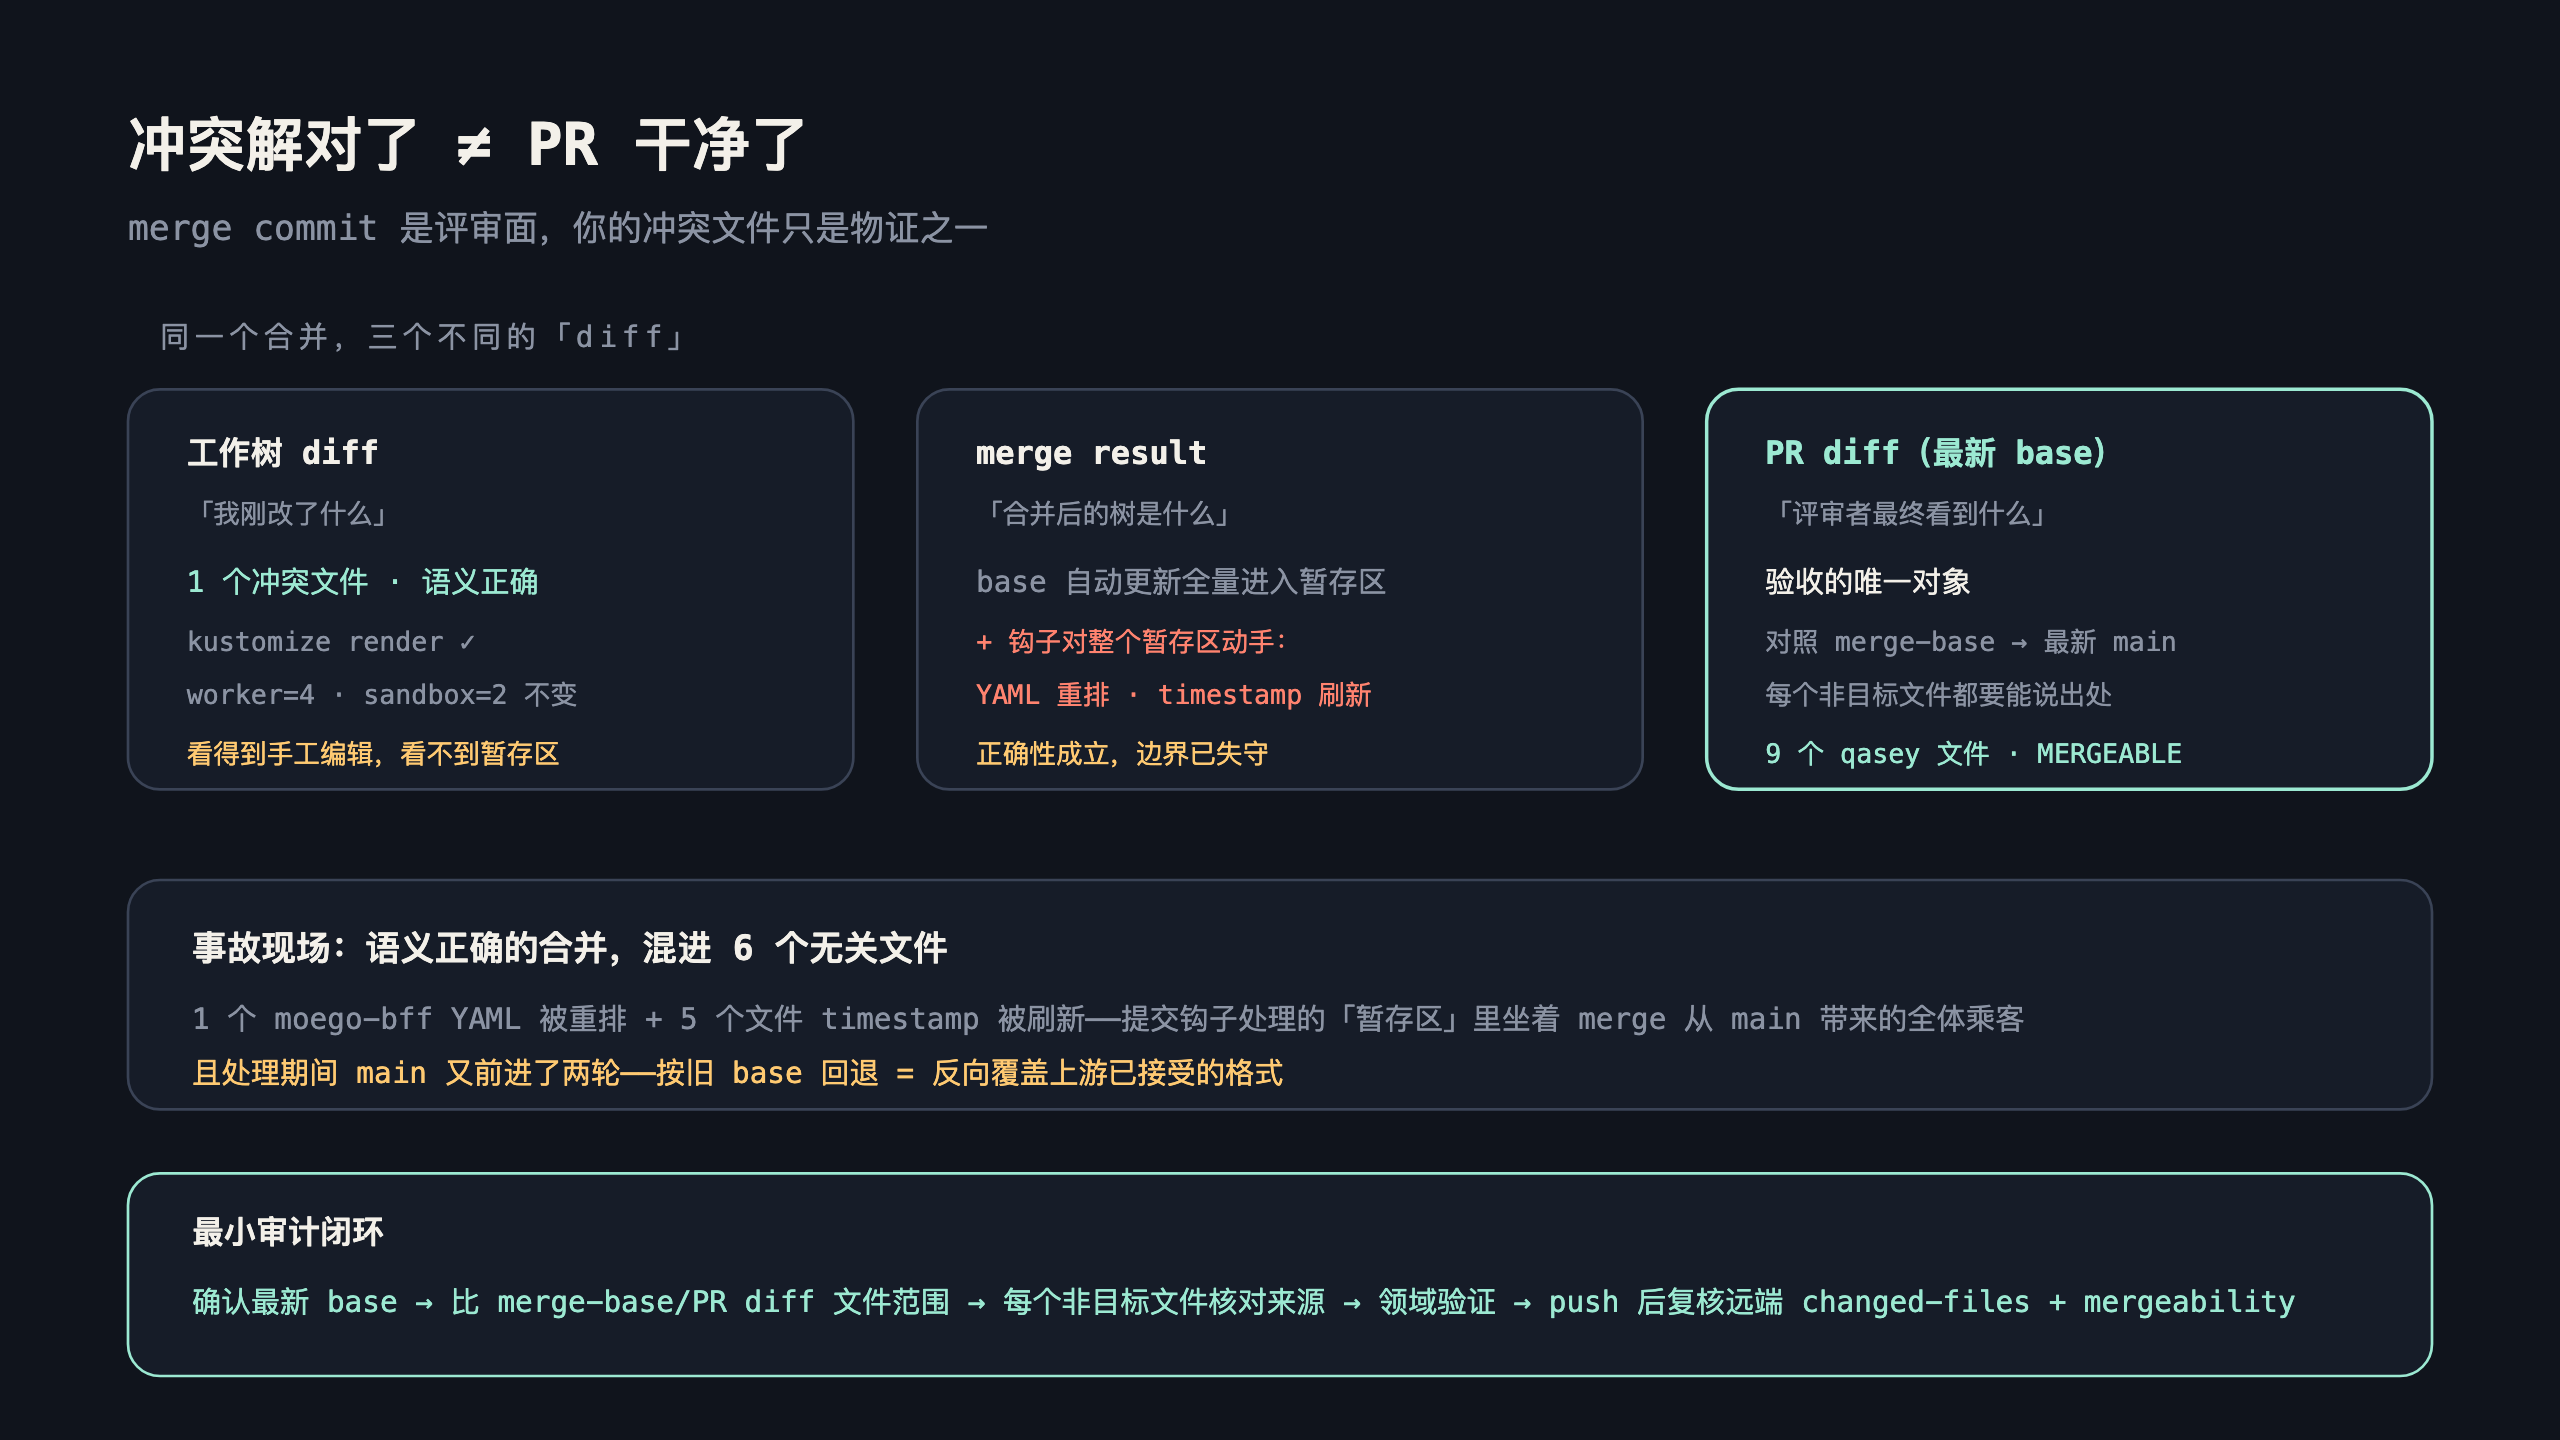
这也是为什么「搜冲突标记」和「跑领域验证」都不够:前者只证明语法层面的冲突消失,后者只证明渲染结果可执行——两者都看不到「范围」这个维度。PR diff 是唯一能回答「这次改动有没有越界」的视角,它是评审者看到的那个东西,也就是质量门禁真正该看的东西。
基线是会动的
清理过程暴露了这个仓库的第二层麻烦:main 有高频自动更新,我处理的这段时间里它又前进了两轮。
这意味着「以哪个 base 为准」不是一次性决策。按动手时的 base 回退?等你 push 的时候那个 base 已经老了,你的「恢复」会把上游新接受的格式反向覆盖掉——按旧截图修文件,等于拿过期的地图进攻已经搬家的城市。每次 main 前进都重新追平?自动更新的频率能让维护窗口永不收敛,你在和一台不睡觉的机器赛跑。
收敛出来的规则是:以「是否触达本次范围」决定是否再同步。main 的新提交如果碰的是与本次 PR 无关的路径,不追;只有新 base 踩进我这次的目标范围时,才值得再拉一次。审计基线用「远端最新 main」而不是「我本地记得的那个 main」——git fetch 之后重新算 diff,别拿缓存当事实。
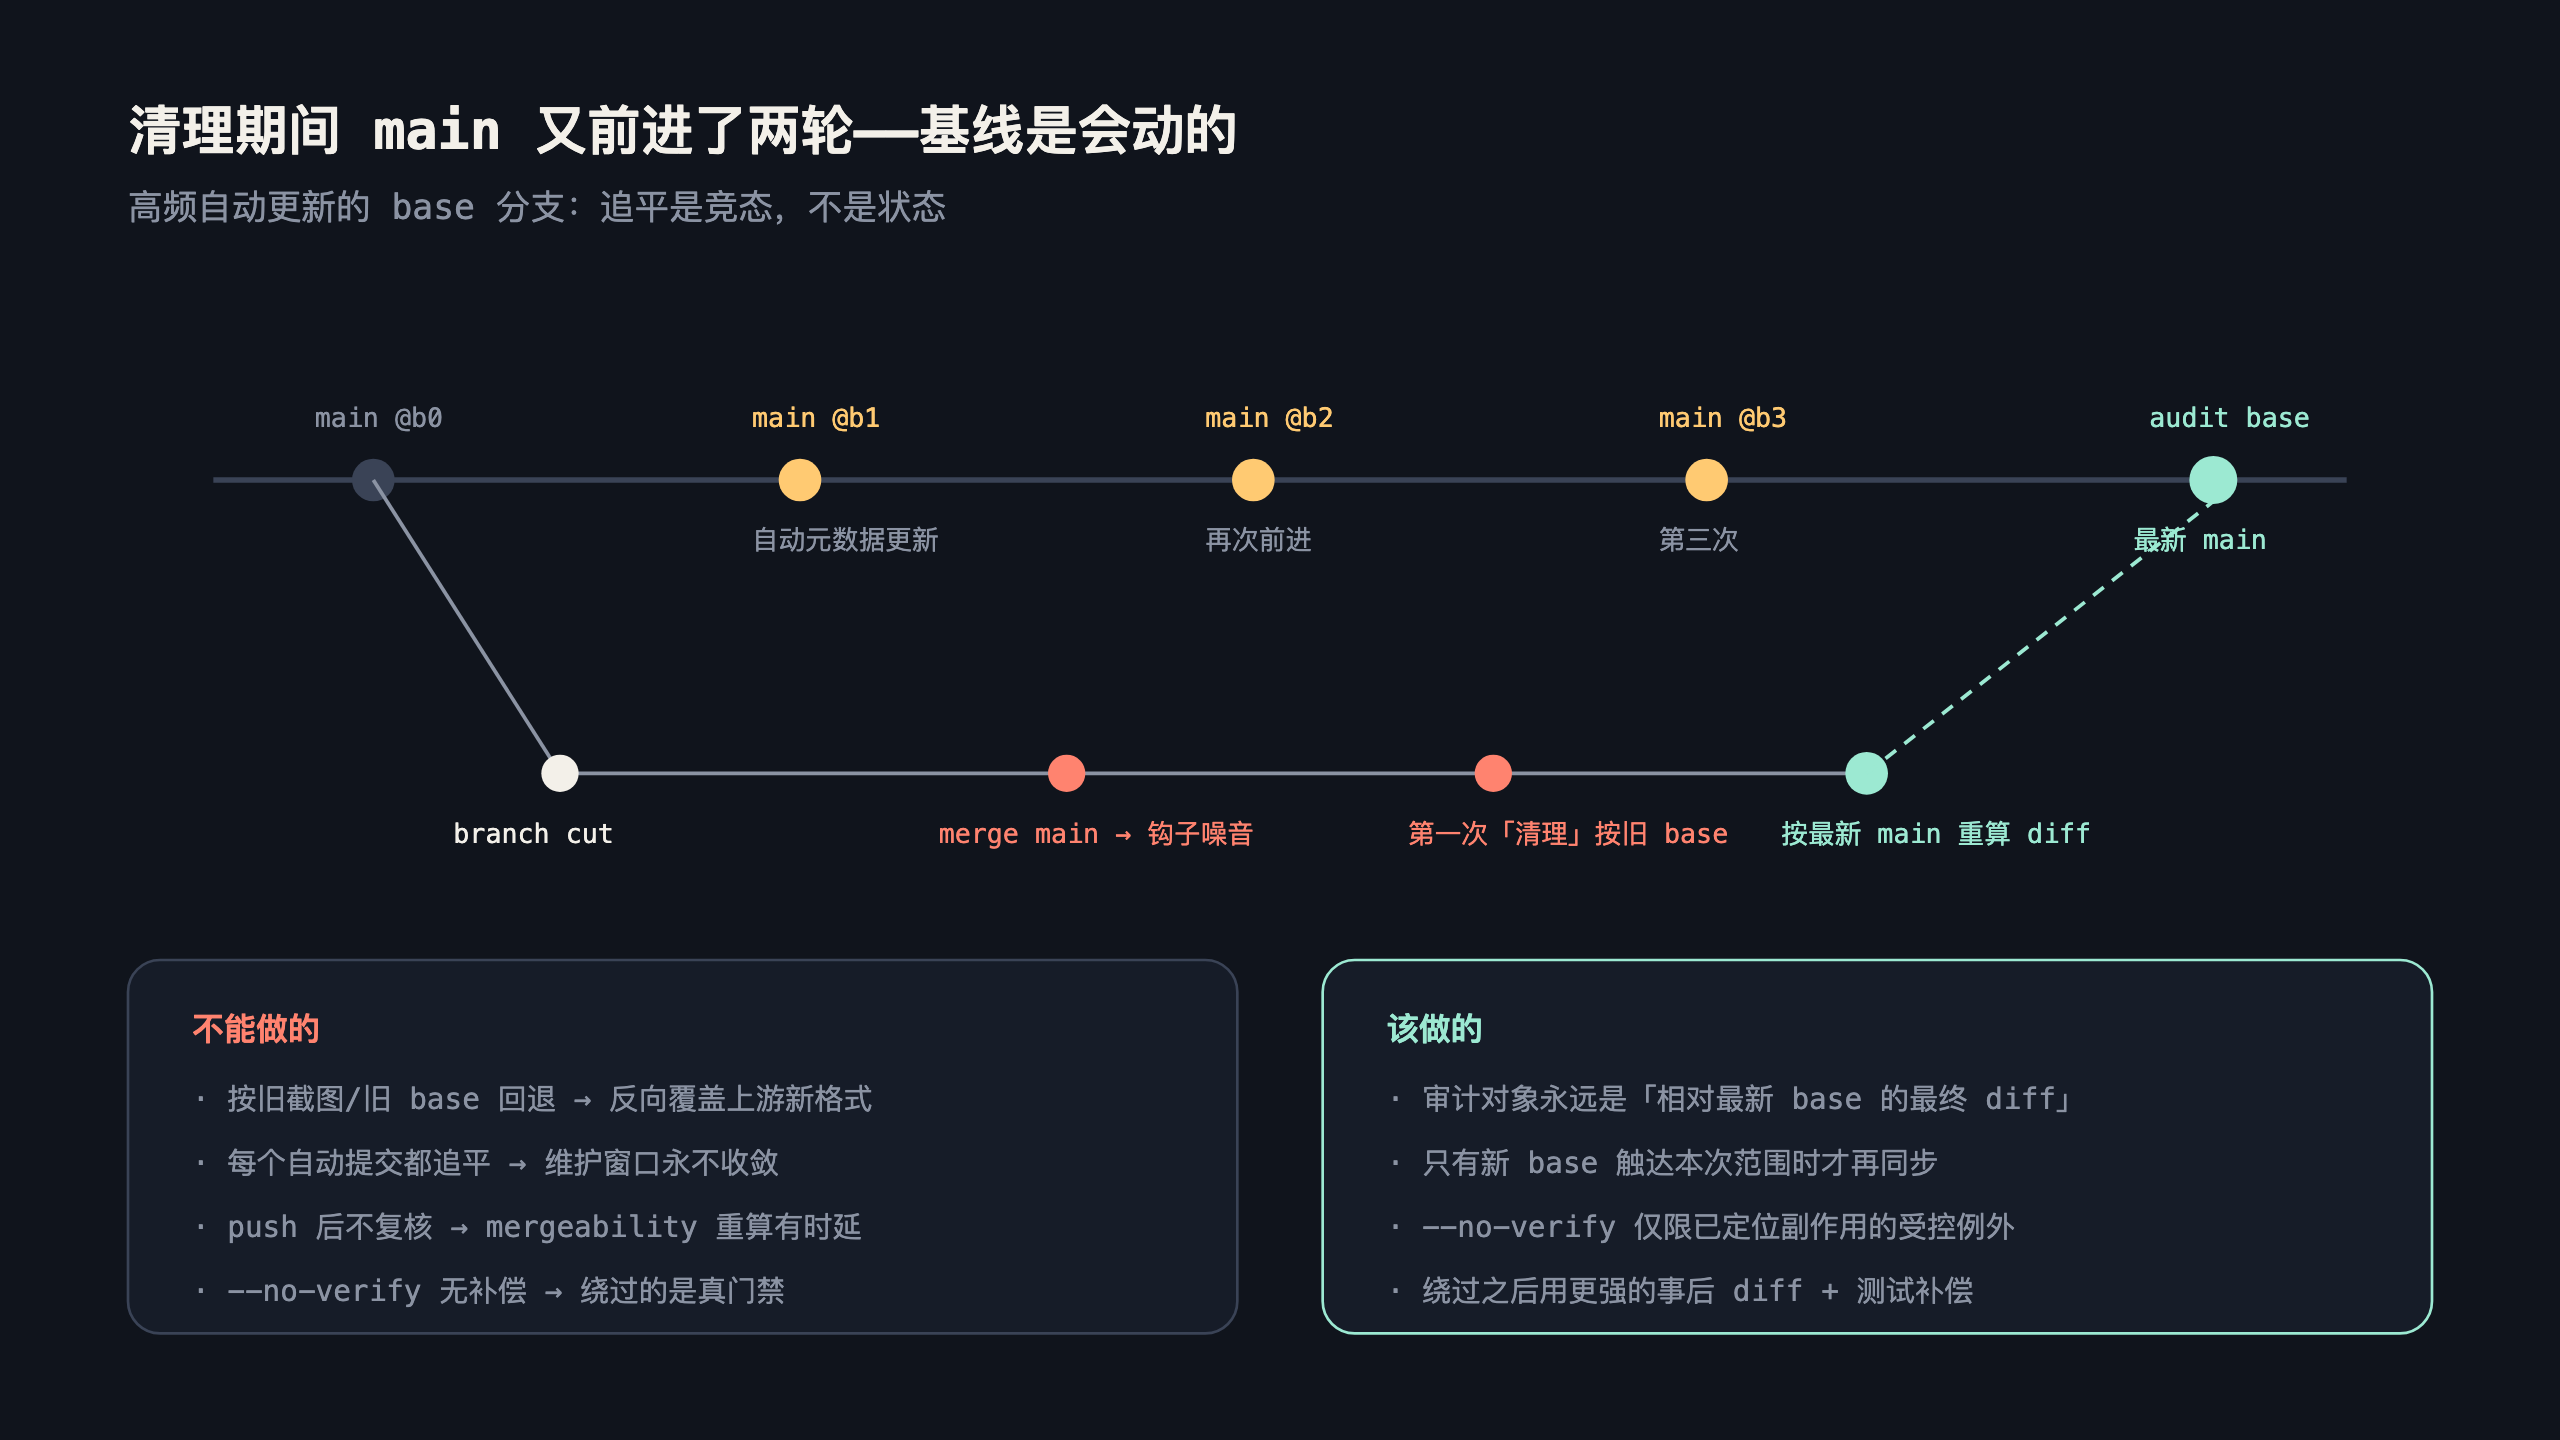
清理动作也因此变得机械而清晰:比较分支与最新 main 的最终 diff,凡是目标范围之外的文件,逐一恢复到 main 的内容;qasey overlay 只保留那一行 name: moego-qasey-api 的有效语义。未跟踪的 openspec/changes/ 目录是用户自己的工作区内容,一律不碰——审计的洁癖不能延伸到替用户处置未提交文件,那是越权的另一种形式。
当时摆在桌上的几条近路也都被一一否掉:只搜冲突标记——只证明语法冲突消失,看不到钩子改写;只跑 Kustomize 和测试——证明结果可执行,证明不了改动范围合理;按最初冲突解决时的截图恢复文件格式——截图固定在旧 base 上,恢复等于反向覆盖上游已接受的新版本;每来一个自动提交就追平一次——main 的高频更新能让这个循环永远不收敛。四条近路共享同一个病灶:用「局部正确」冒充「范围正确」——而这正是事故最初的成因,不该再用它来治疗事故。
–no-verify 的正确用法
最后一步有个细节值得单独说:清理提交我走了 --no-verify。
听起来像掩耳盗铃——钩子不就是质量门禁吗,绕过去算什么?区别在于:此时钩子已经被根因定位了——它会对整个暂存区做格式化和 timestamp 刷新,而我的清理提交恰恰是「把文件恢复成 main 的样子」,再让它跑一遍等于邀请同一台机器把刚擦干净的地板再踩一遍。这是受控例外,不是逃课。
但 --no-verify 有一条铁律:绕过必须用更强的事后验证补偿。跳过钩子之后我做了四层补强:whitespace 逐文件比对、文件范围对照 main 重算、kustomize 渲染复验、push 之后上 GitHub 核对远端 changed-files 和 mergeability。钩子被绕过的那一次,审计强度不是降了,是翻倍了——没这个补偿意识的 --no-verify,绕过的可能不是噪音制造机,是真的门禁。
顺带一个远端细节:push 之后 GitHub 的 mergeability 是异步重算的,短时间内可能显示 UNKNOWN 甚至 CONFLICTING——别急着慌,对着 base SHA 判断是「真冲突」还是「还没算完」。我那次处理里 main 前进了两轮,两次远端复核看到的 base commit 都不一样,如果按「本地记得的状态」断案,早把自己绕进去了。最终结果:清理提交 d271ba6e10 推上去,PR 只剩 9 个 apps/moego-qasey 文件,没有多余的 timestamp 和无关 YAML,MERGEABLE——审计闭环的每一步都留下凭证,收口才收得心安理得。
最小审计闭环
提炼成可复用的清单,merge 类 PR 的验收步骤应该是:
确认最新 base——fetch 远端,别信本地记忆。比较 merge-base/PR diff 的文件范围——列出「相对最新 base 动了哪些文件」,而不是「我编辑了哪些文件」。给每个非目标文件做来源核对——每个出现在 diff 里、又不是本次目标的文件,都要能说出它从哪来的:merge 带入?钩子改写?生成器刷新?说不出处的一律恢复到 base 内容。跑领域验证——该渲染渲染、该测试测试。push 后复核远端——changed-files 清单和 mergeability 以平台为准,本地结论只是候选。
其中「逐文件核对来源」是整个闭环的灵魂:预期之外的文件一定有个制造者,找到它,要么消灭噪音,要么发现你合并理解里的盲区。 我那 6 个文件的账对出来其实很工整——1 个 moego-bff YAML 是格式化器的手笔,5 个 timestamp 是生成器的例行公事,全都来自「钩子对暂存区乘客的无差别善意」。账能对上,清理才敢动手;账对不上的文件出现在 diff 里,说明你对这次合并的理解本身就有洞,补洞优先于清理。
怎么从根上少出这类事
审计闭环是止血,不改机制就还得反复止血。三个方向值得在仓库层面推动:
其一,让钩子只处理「分支实际修改或显式暂存的路径」。按文件清单过滤再跑 formatter,merge 带入的 base 更新根本不进它的视野——这是最对症的一刀,直接把「暂存区全体」和「本次意图」区分开。其二,自动生成内容的 ownership 归机器人。timestamp、部署元数据这类由 CI/部署机器人持有的字段,本来就不该出现在开发者的提交里被刷新——开发者提交里出现自动字段的 diff,本身就是设计泄漏。其三,CI 侧按 allowlist 拒绝越界 PR——声明「这个 PR 只应动 apps/moego-qasey/**」,CI 见到清单外的文件直接标红。本地审计是事后发现,CI allowlist 是事前拦截,两道都要有,顺序是先有事后再有事前——你连噪音长什么样都没见过,写出来的 allowlist 也是瞎猜。
什么仓库特别需要这套
这套流程不是每个 PR 都配得上的成本——手工改三个文件的普通 MR,缩减成「文件范围 + 远端 diff」两步就够。但有三类仓库它基本是刚需:
自动生成内容高频进 main 的仓库——lockfile、代码生成产物、部署元数据、timestamp 刷新——base 永远在动,「相对哪个 base 的 diff」本身就是变量。格式化纪律严格的仓库——一个 prettier/yamlfmt 钩子就能把 merge 带入的几十个文件全改一遍格式,噪音量按 merge 体量而不是按你的编辑量算。以及「冲突很小但 merge 带入文件很多」的 PR——冲突越小越容易给人「搞定了」的错觉,带入面越大留给钩子和竞态的作案空间越宽。
反过来说,这套流程的存在理由可以压成一句话:合并的完成条件不是「没有冲突标记」,也不是「目标文件测试通过」,而是「PR 相对最新 base 的最终差异只包含预期语义」。 前两个条件检查的是「正确性」,最后一个才检查「边界」——而评审者按边界审你。
收个尾
那次事故里最讽刺的细节是:我每一步都做了「验证」——冲突标记搜了、渲染跑了、语义对了——唯独没有看一眼「这次合并最终在评审者眼里长什么样」。验证的对象选错了,验证做得再勤奋也是给错误的问题交完美的答卷。冲突标记、渲染结果、语义检查,三道关卡查的都是「正确性」;而评审者打开 PR 第一眼看到的是文件清单——那是「边界」。正确性证明你做的事对,边界证明你只做了该做的事,缺一个都不算交付。
merge 完成的那一刻,手工编辑就退位成了物证之一;真正代表这次交付的,是远端 PR 页面上那份相对最新 base 的最终 diff。审计它,就是审计评审者眼中的你——别让格式化器替你化妆,也别让 timestamp 替你署名。