做 node-network-devtools 的时候,我给自己定的体验标准很简单——对齐浏览器:Network 面板里每条请求都应该能点开 Initiator,看到是谁发起的它,最好一键跳回源码。
没有这个能力是什么体验?你在面板里看到一条 POST /api/pay,想知道是哪段代码发的,只能复制 URL 回编辑器全局搜索——搜出来五个调用点,挨个猜。猜错了还得回来看 Timing 猜下一手。请求是系统里最神经质的动作,发起者却查无此人,这事本身就很魔幻。Initiator 那一栏干的就是「户口登记」:每个请求都得有爹。
浏览器里这件事是无感的——你点开任何一条请求,Initiator 都乖乖指向那行代码,因为 Chromium 的网络栈在每个请求出生时就顺手把证人带上了。Node 没有这个福利,Network 面板里请求的爹得我自己找。
第一刀:从空栏到假栏
第一刀很容易:requestWillBeSent 里塞个 initiator: { type: 'other' },面板认了,但那栏空空如也——属于「有户口,没户籍」。
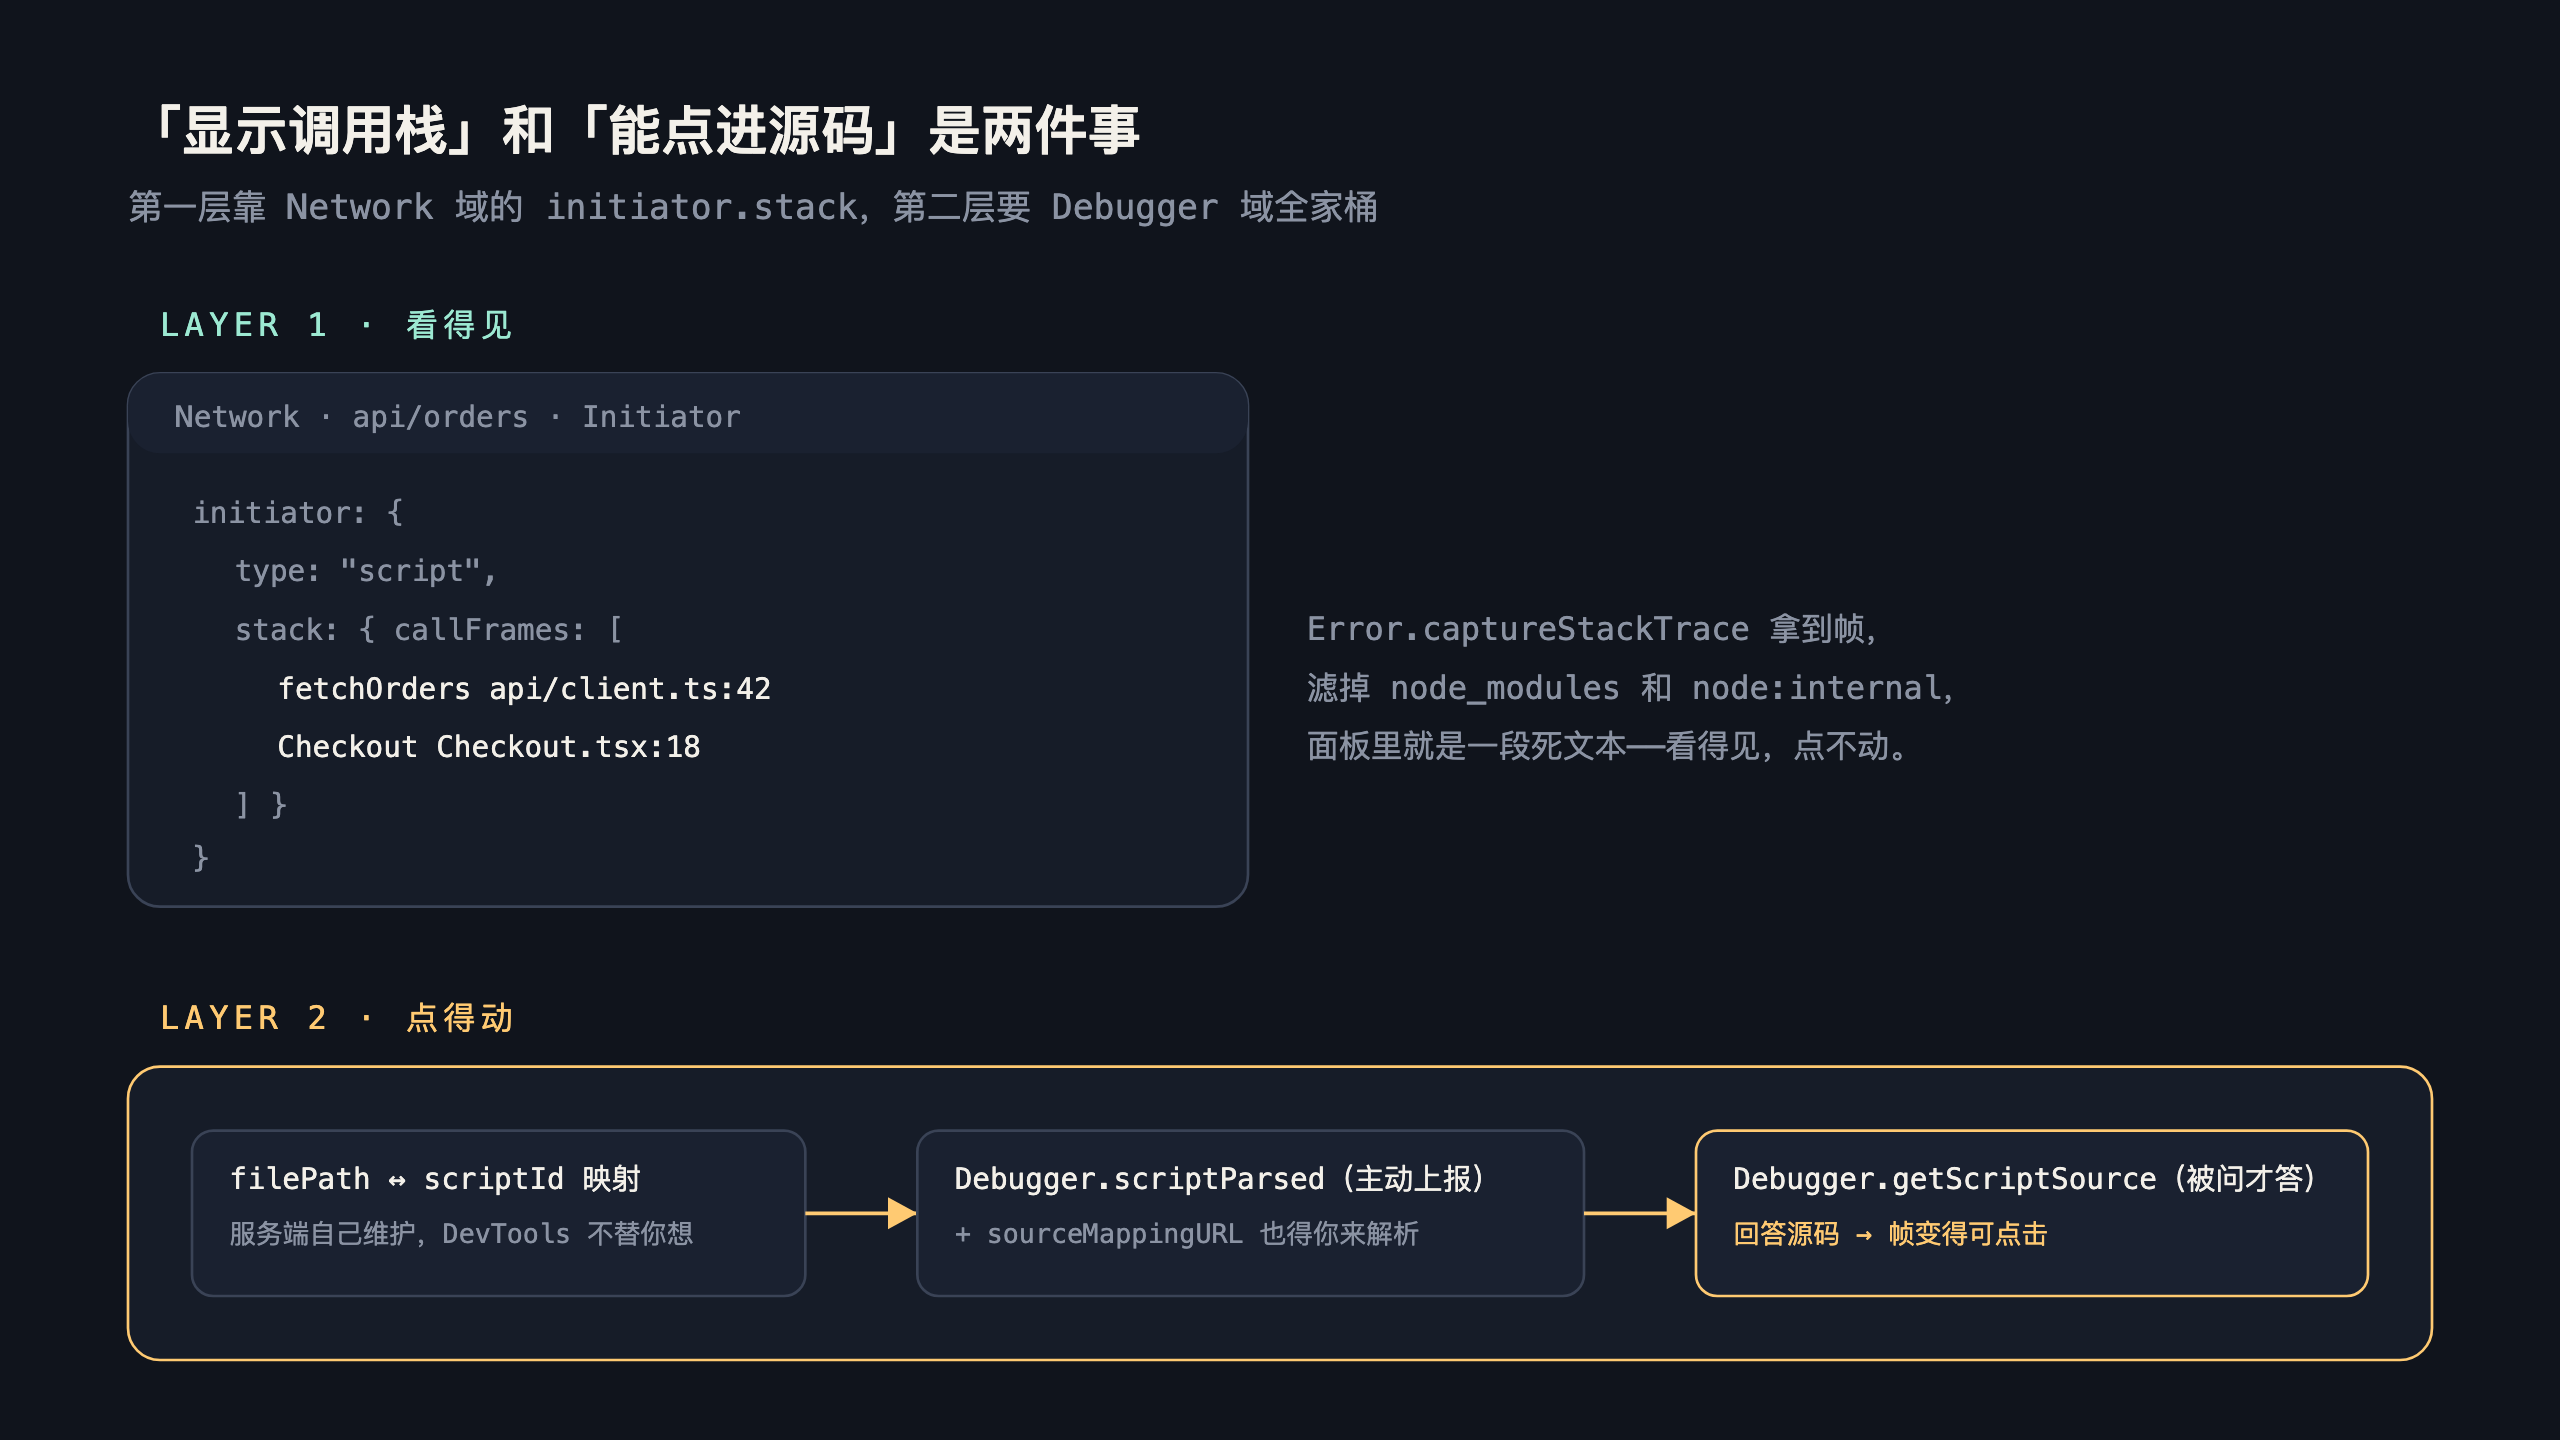
真正让它有内容的是 initiator.stack.callFrames:Node 侧用 Error.captureStackTrace 抓当前栈,把 CallSite 拆成 functionName、fileName、lineNumber、columnNumber,再把 node_modules 和 node:internal/ 这些凑热闹的帧滤掉。到这一步,面板里能看到一串像模像样的调用链。
但「看得见」和「点得动」之间,隔着整个 Debugger 域。
让栈帧能点:Debugger 域的户口登记处
DevTools 不会替你读本地文件——这是很多人第一次造调试器时没意识到的事。浏览器环境里,V8 编译每个脚本时都会分配 scriptId 并广播 Debugger.scriptParsed,Sources 面板的文件树就是这么来的。我的冒牌 Chrome 没有 V8,想让别人点栈帧跳源码,就得自己把这个登记处演出来。
完整链路是这样的:
- 注册通知:CDP Server 自己维护
filePath ↔ scriptId映射,主动发Debugger.scriptParsed告诉前端「这些文件我都认识」。 - 响应拉取:用户点击栈帧,DevTools 回发
Debugger.getScriptSource,按 scriptId 找到文件、读源码递回去。 - 时序对齐:
scriptParsed必须先于用户点击到达,否则 DevTools 根本不知道这个 scriptId 背后有东西可点。callFrames里的url和scriptId对上了,Sources 面板才会把栈帧渲染成可跳转链接。
Sourcemap 也不会自动生效:sourceMappingURL 注释要服务端自己解析,再把映射后的源码位置喂回去。我当时只覆盖了尾部注释这一种形态,inline map 和远程 map 都是留着的坑。
我当时的实现方式在上一篇说过:扫磁盘文件、自增伪造 scriptId 硬凑。能用,但想想都知道这不是能进正规军的方案——伪造的 script 跟 V8 真实的 script 生命周期完全是两码事:V8 知道哪个脚本编译了、哪个被 GC 了,我的假户口只有「生」没有「死」。文件改了、删了,映射表都不知道,第二天还在给前世的文件发户口本。
而且这套伪造还自带一个甜蜜的负担:scriptParsed 必须赶在用户点击之前发完。项目一大,几千个文件一口气全发出去,DevTools 前端接到的是一场文件暴雨——好在它不是人,不会嫌烦。
真正的问题:栈是哪一刻抓的
如果说上面这些是工程繁琐,那接下来的发现直接让我改掉了整个采集时序。
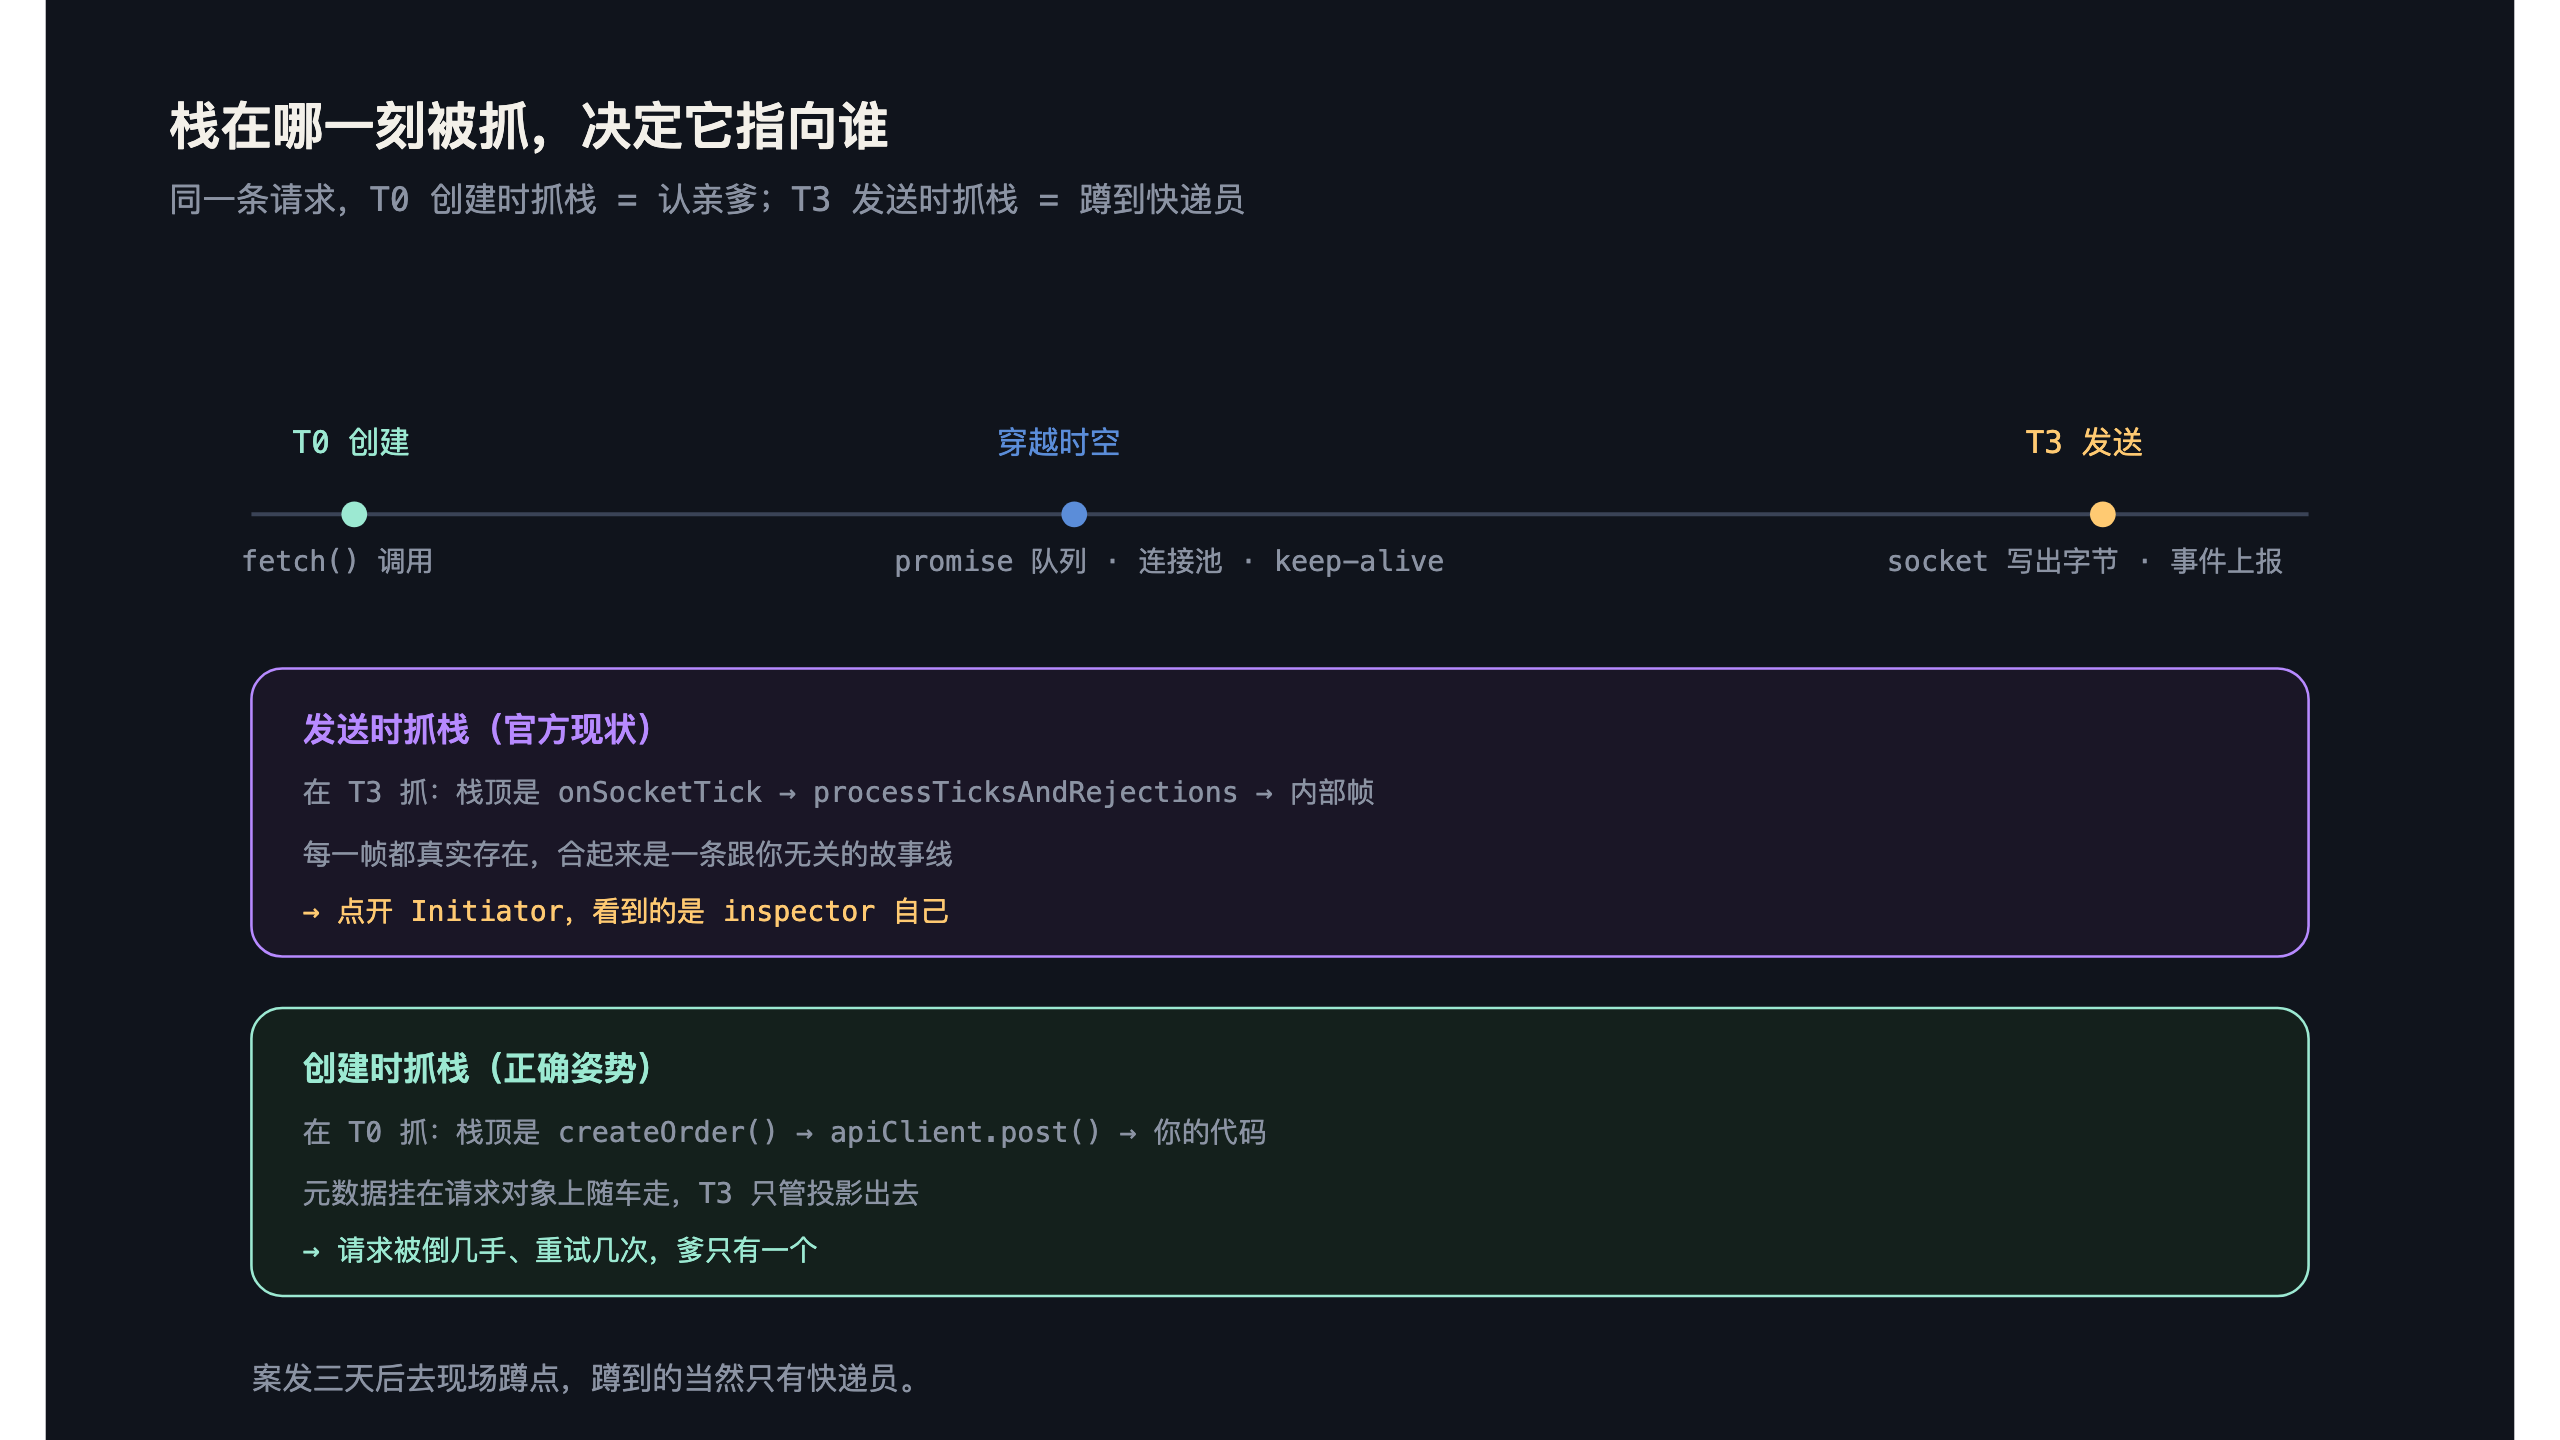
后来我对照 Node core 的 Network Inspector 源码做了一次审查,发现官方实现是:NetworkAgent 在发送协议事件的那一刻调 v8_inspector_->captureStackTrace(true)——栈是「事件发送时」现抓的,不是「请求创建时」留下的。协议层其实留了 url、lineNumber、columnNumber、requestId 这些字段,但没有一处拿它们建立「谁触发了谁」的关系;HTTP、fetch、HTTP/2 几条 bridge 各传各的 requestId 和数据,initiator 元数据压根没往桥下走。
这两种抓法在同步简单场景里看起来没区别。http.get() 同步直发,栈里碰巧会有你的业务文件——现有测试也是这么断言的:只要栈里出现那个文件,就算过。没人断言栈顶必须是真正的调用方。
但请求这个东西是会穿越时空的。
fetch() 在用户代码里调用,真正的「发送」可能隔着 promise、callback 队列、keep-alive 连接复用。尤其 keep-alive:socket 是上次请求留下的,发送动作发生在复用它的那一刻,栈里只剩 socket 的回调链。等 inspector 想起来抓栈,发起者早就散场了,栈顶只剩 network_agent.cc 和 processTicksAndRejections 这些内部帧——证词是真的,证人不对。
可以把这个失真过程脑补成一次刑侦:
- T0 (案发):用户在代码里调了
fetch; - T1~T2 (转移):请求对象进了 promise 队列、被连接池接管、等 socket 空出来(嫌疑人换了几辆车);
- T3 (蹲点):socket 真正写出字节,inspector 这时才抓栈——相当于案发三天后去现场蹲点,蹲到的当然只有快递员。
你点开 Initiator 期待看到「我写的 createOrder()」,实际看到 onSocketTick → processTicksAndRejections → 某内部帧,每一帧都真实存在,合起来是一条跟你毫无关系的故事线。
- WebSocket:更明显,握手完成后才发事件,创建时那口气早就咽了。
- HTTP/2 server push:这种派生请求,爸爸是谁更无从谈起——它是服务器推过来的,本地栈里压根没有「用户代码」这个人。
- 重定向:另一种更隐蔽的派生:302 回来,client 库替你悄悄发第二个请求,栈里只有它内部的 follow-redirect 逻辑,你第一次调用的那行代码隔了一整条请求链。这时候
initiator.requestId就有用了——第二条请求不挂栈,挂它爹的 requestId,DevTools 顺着链子自己就能把谱系画出来。
正确的姿势:创建时捕获,发送时复用
修法一句话讲完:在 request、stream、WebSocket 被 new 出来的那一刻抓栈,把 initiator 元数据挂在请求对象或 requestId 上随车走;协议事件发送时只管把存货投影出去。派生关系再靠 initiator.requestId 补因果链——server push 记它爹的 requestId,DevTools 就能渲染出请求谱系。
「创建点」这个词听起来统一,落地时每条路径的「案发现场」长得完全不一样:
http.ClientRequest:创建点是构造函数被调用的瞬间——用户new它的那一刻栈是真的;fetch:创建点在 undici 的 dispatch 入口,再往下就进了 C++ 的地界;WebSocket:创建点是 upgrade 请求发起时,而不是握手完成时——早一秒晚一秒,证词完全不同;HTTP/2:则是 stream 被分配的那一下。
每条路都得单独勘察,没有一根「统一的创建钩子」等着你。
生命周期是第二个坑。元数据挂在对象上,对象活着数据就在——这听起来自然,实现起来到处是暗礁:请求被 abort 了要不要清?keep-alive 复用的 socket 上跑第二个请求,上一个请求的栈要不要盖掉?requestId 到对象的那张映射表在长驻进程里只进不出就是内存泄漏。调试工具自己制造泄漏,属于医疗事故。
这就是为什么这个修复方向被接受了,却没有一次到位:它本质上是给每条请求路径做一次「案发时间」的取证改造,而每条路径的案发现场、证人、证据保鲜期都不一样。
当时评估过的其他姿势
继续沿事件发送点现抓,改动最小,但异步事件、握手完成、server push 全都给不出真实发起点——只能当兼容性兜底,不能当答案。
只填个 type: script 配一段孤立栈,DevTools 能显示点东西,可没有创建因果,分类反而掩盖错误:一个「看起来像样」的错误答案比一个诚实的空栏更害人,空栏至少承认我不知道。
这两个方案和正解的差距,不在代码量在时序观:发送时刻是协议的事,发起时刻是因果的事,两件事不该由同一个时间点交代。
分寸感:Userland 能野,Core 不行
还有一层边界值得说:userland 那套扫磁盘伪造 scriptId,绝对不能往 core 搬。
官方得复用 V8 inspector 真实的 scriptId 体系——V8 本来就知道每个脚本是谁、什么时候编译的,伪造一套平行宇宙只会和真户口打架。用户态可以糙,糙在我自己的工具里,用户骂我可以卸;core 糙了糙在全世界跑 Node 的进程里。同一个方案,放在不同的爆炸半径里,对错完全不一样。
测试标准跟着换
顺带一说,这个问题是审代码审出来的,不是跑测试跑出来的——这本身就是个信号。
现有测试断言的是「栈里出现了业务文件」,而同步直连场景下这句话几乎永远成立:栈长得再歪,里面总有一帧碰巧是你。测试全绿,功能全坏,这是最危险的一种绿。「栈里含有」和「栈顶等于」是两个完全不同的断言:一个查户口,一个认亲爹,中间差着一整个异步边界。
所以测试断言也得换口径:同步直连的栈好看不算数,要专门补跨异步回调、请求派生、server push 的用例——那些场景恰恰是失真重灾区。断言方式也要从「栈里含有」改成「栈顶等于」。
还有个实践细节:抓栈本身有成本,Error.captureStackTrace 走过越深的帧越花钱,过滤规则最好做成可配置的。除了 node_modules 和 node:internal/ 这些常客,业务自己的 wrapper 层也常是没信息量的帧——你们的 request.js、apiClient.ts,帧还在,信息量没有。过滤器应该允许按项目调,不然面板上一半的帧都在说废话。
成本这事的另一面是:把抓栈从「发送时」挪到「创建时」,频次反而更诚实了。发送时抓栈抓的是每一次网络事件,创建时抓栈抓的是每一次用户意图——一个请求无论被连接池倒了几手、重试了几次,爹只有一个。抓得少了,抓得还更准了。
给同样想造调试器的人留一份清单
把这个坑走完,我攒下一张 checklist,给任何想在 DevTools 里做出「能点的栈」的人:
- 结构要素:
initiator.type决定那栏长什么样,stack.callFrames决定里面装什么——只填 type 是空栏,只填 stack 没因果,两者得一起上。 - Debugger 链路:栈帧能看和能点是两件事,中间隔着一个 Debugger 域:
scriptParsed先登记,getScriptSource再供货,url和scriptId对上了才有链接。 - 捕获时序:栈在哪一刻抓,决定它指向真相还是指向你自己。创建时捕获、发送时复用,是唯一能跨过异步边界的姿势。
- 断言逻辑:测试断言要写「栈顶是谁」,不要写「栈里有谁」。前者是因果,后者是路过。
- 爆炸半径:所有「伪造脚本宇宙」的方案都要标好爆炸半径——userland 的野路子进了 core 就是事故,反过来 core 的正装穿上身,用户态的小工具也犯不着那么累。
Initiator 不是装饰栏,它是「请求从哪来」的唯一证人。证人必须在案发时就位——事后才想起来问话,得到的只能是一段碰巧路过的 stack。