给 Node 的 Network Inspector 补请求体支持时,一切都很顺利:加了 http.client.request.bodyChunkSent 和 bodySent 两条 diagnostics channel,桥接成 Network.dataSent,Network.getRequestPostData 终于能在 DevTools 里看到 POST 出去的 JSON 了。
然后我拿响应体开刀,第一版实现挂在 IncomingMessage 的 data 事件上,跑通文本场景就收工。直到一位用户递来一个复现脚本:他的代码里有一句 outboundRes.setEncoding('utf8')——平平无奇,流式处理响应的标准姿势。我的 inspector 当场表演了一个全线崩溃:Missing dataLength in event,响应体事件一条都发不出去。
那一瞬间我意识到自己犯了一个观测工具的经典错误:把插桩点放在了「数据已经被改写」的那一侧。 用户的 setEncoding 不是刁钻用法,是流的正常功能;我的探针却建立在「chunk 永远是 Buffer」的隐含假设上。观测工具的天职是适应被观测对象的一切合法行为——包括那些恰好把你架设在下层的假设踩碎的行为。
byteLength 会说谎
先拆开 Missing dataLength 这个小错误看机制。data 事件交付的 chunk 类型取决于用户有没有调 setEncoding():不调是 Buffer,调了是 string。我的桥接代码按 chunk.byteLength 取长度——Buffer 上这是线上字节数,一切正常;string 上 byteLength 压根不存在(string 有 .length,那是 UTF-16 码元数),事件校验一卡,整条数据通路哑火。
修起来不难,判断类型分别处理就是。但真正的坏消息在后面:就算把长度修对,从 string 拿回字节这件事本身就是有去无回的。
一个 emoji 🌍:线上 4 个字节(f0 9f 8c 8d),UTF-16 里 2 个码元,string .length 报 2。拿 Buffer.from(str) 去「还原」,UTF-8 良构文本确实能编回来——可一旦线上字节是坏编码(截断的多字节序列、Latin-1 混入、客户端实现的 bug),setEncoding 的解码器已经把它们统一替换成了 U+FFFD。那个 � 就是墓碑:原始字节在解码器里被火化之后,你拿 string 反推,得到的永远是一份体面的伪证。
对「给用户看响应内容」的场景这无所谓——� 也是用户看到的东西。但对观测工具这是渎职:inspector 的职责是报告线上发生了什么,不是报告解码器觉得发生了什么。调试器拿伪证断案,比没有证据更害人。
在语义还完整的最后一层插桩
正确的位置往上找一层:_http_common.js 里的 parserOnBody()。llhttp 从 socket 读出 wire 字节,分片喂给 parser,parser 按 HTTP 语义切出 body 段——在这个回调里,chunk 还是原教旨的 Buffer,是线上字节的最后一份拷贝。把它接进 inspector 的响应体缓存和 Network.dataReceived,用户随后爱 setEncoding 什么随他去,观测面拿到的永远是解码前的真字节。
这个位置的妙处在于它同时满足两个苛刻条件:语义上,HTTP 解析已经完成——chunked 解码、Content-Length 边界、压缩状态都在 parser 手里处理过,拿到的 body 段是「应用层语义」而非「传输层分片」;时间上,用户侧任何消费都还没发生——data 事件没发、setEncoding 没生效、pipe 没接手。它恰好卡在「协议已理解、用户未改写」的唯一缝隙里。往上走一层是 wire 噪声,往下走一层是解码后的主观版本,只有这一层是现场原貌。
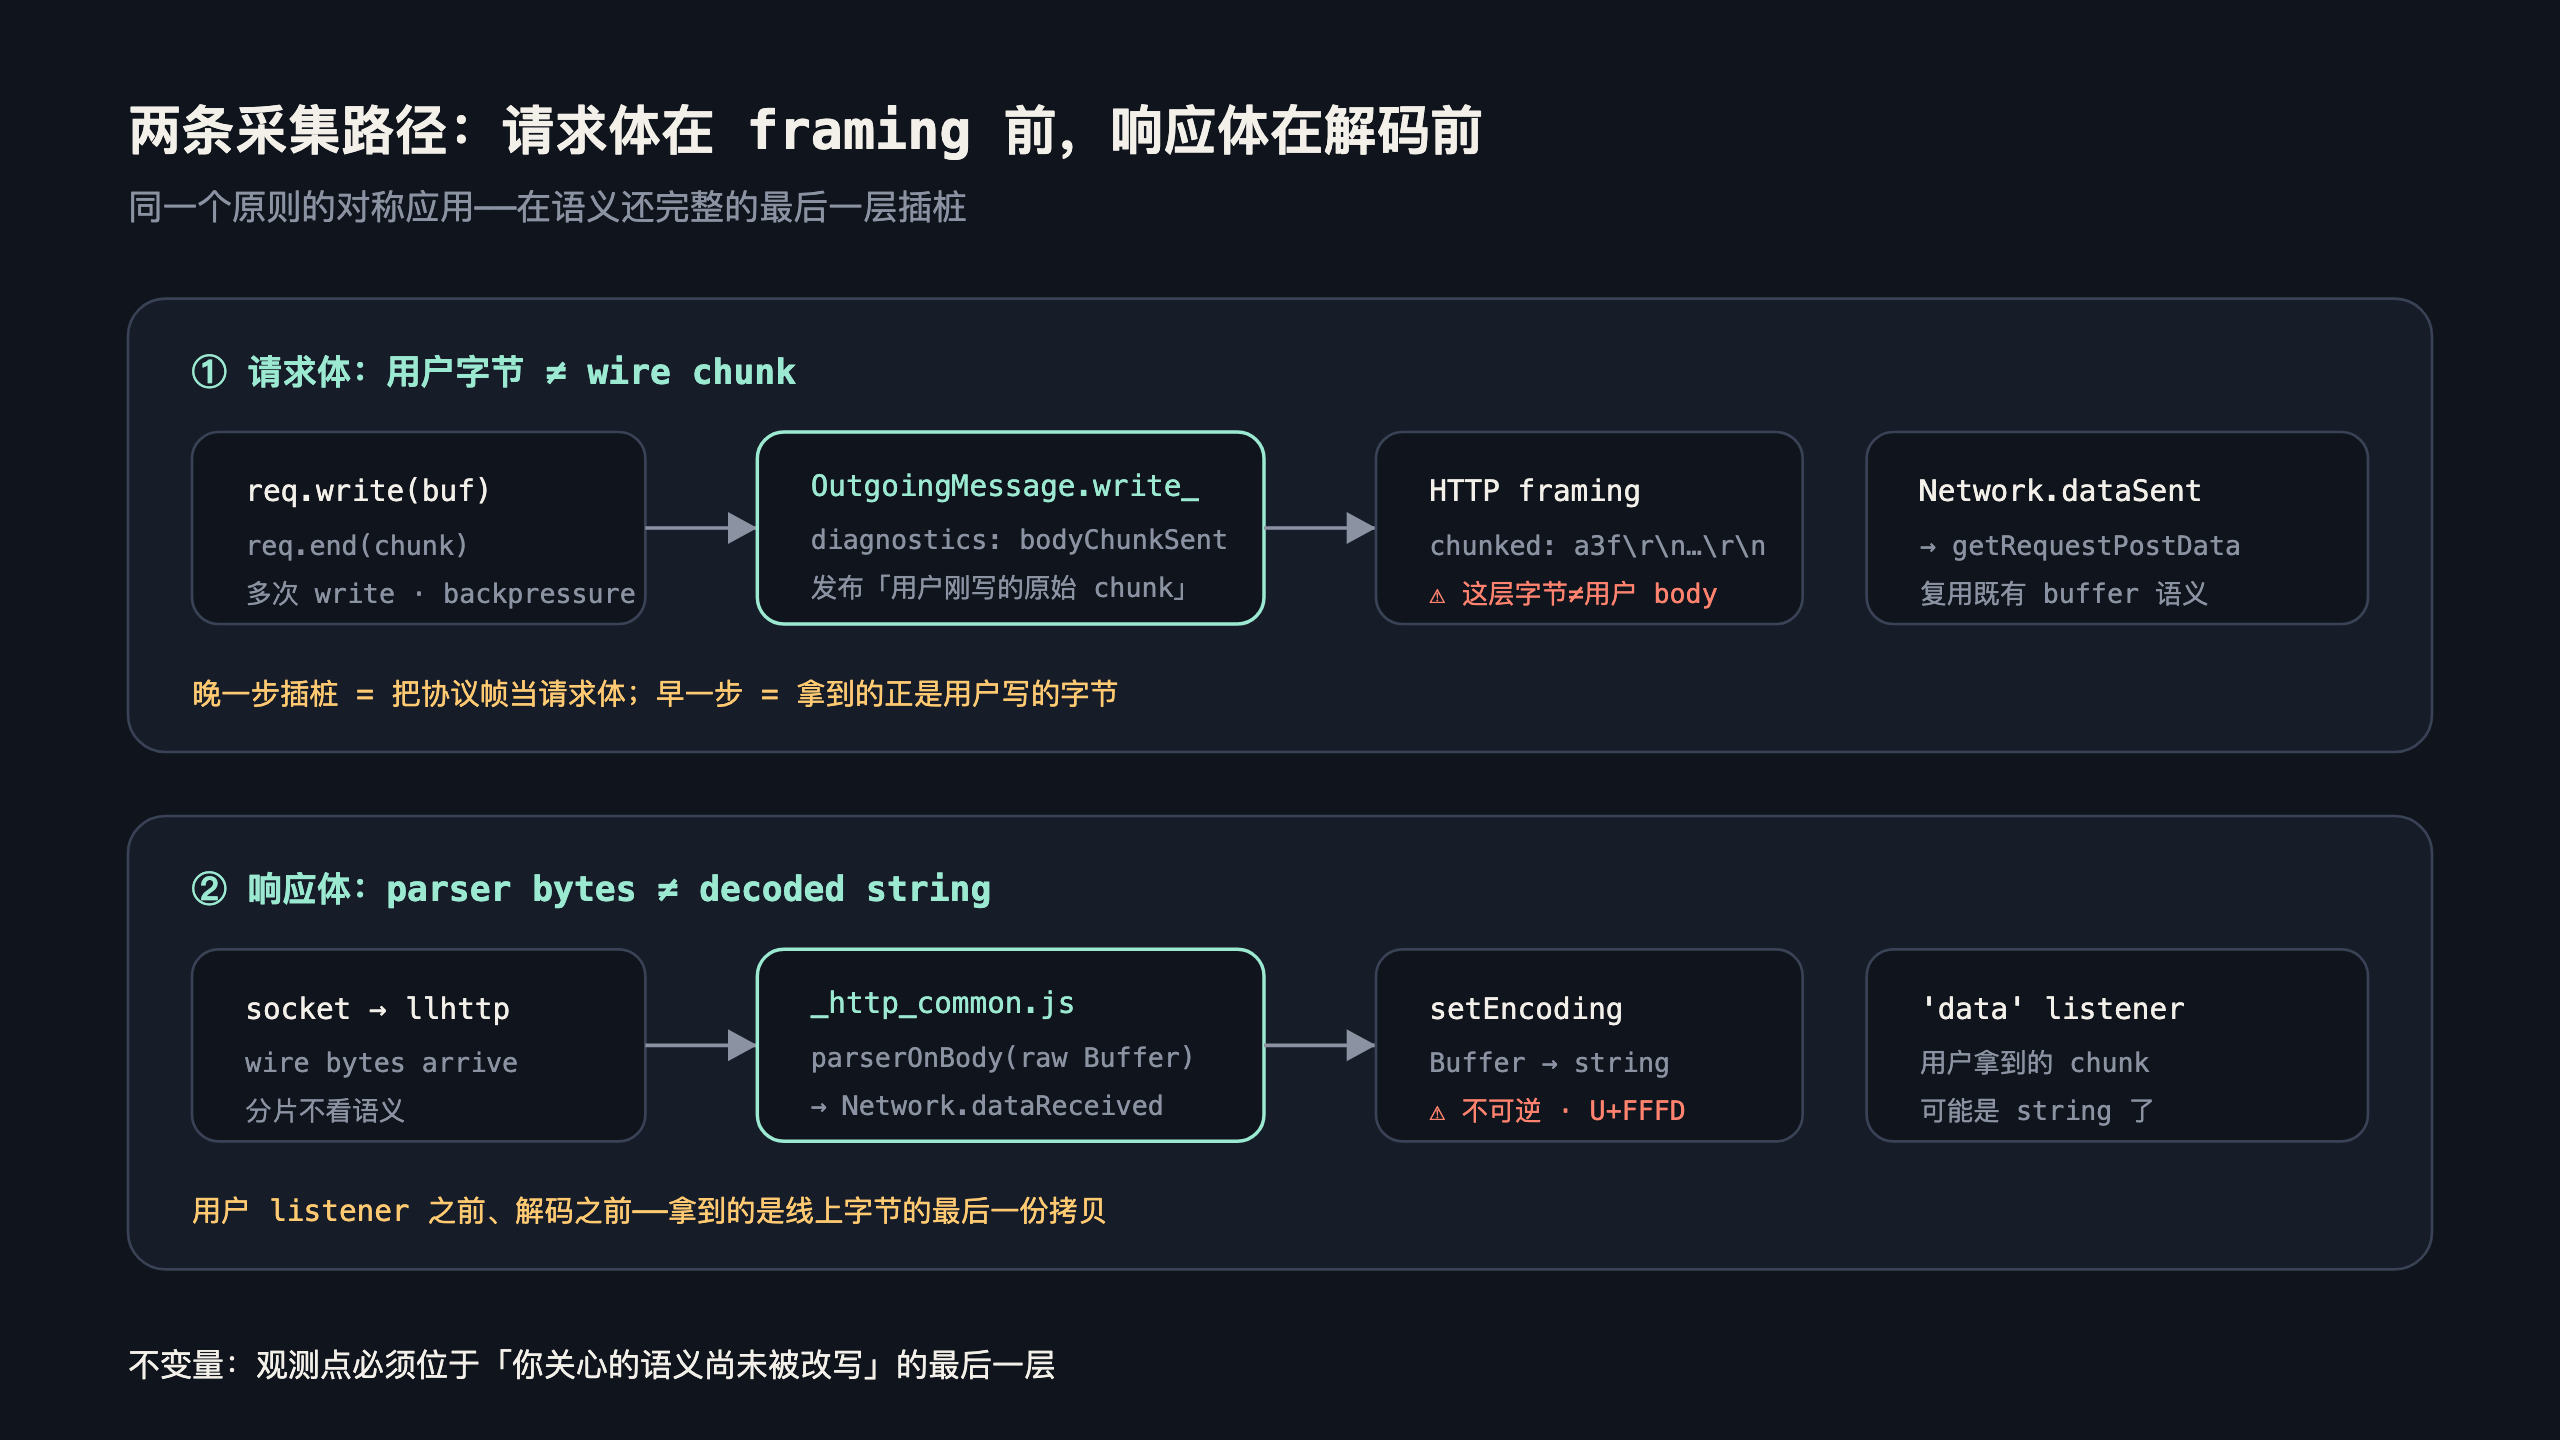
有意思的是请求侧是个镜像问题,只是方向相反。用户 req.write(buf)、req.end(chunk) 写下的字节,进入 OutgoingMessage 后会被 HTTP framing 加工——chunked 编码加长度前缀、\r\n 分隔、可能的压缩管线。在 socket 层抓包,拿到的是「用户 body + 协议包装」的混合体;在 data 级的更外层看,又分不清多次 write 和 backpressure 的边界。所以请求体的正确插桩点是 _http_outgoing.js 的 write_()/end() 共享写路径——用户字节刚交进来、framing 还没接手的那一刻,发布 bodyChunkSent。这样 write()、end(chunk)、分多次写、背压暂停,所有写入形态走的都是同一条采集路径。
这个「同一条」是硬要求,值得拆开看几个会翻车的形态:end(chunk) 带着最后一段 body 直接进 end(),不走 write()——只钩 write 就漏了它;大 body 分几十次 write(),背压让其中一半排队进内核缓冲——在 socket 侧看是断断续续的流,在用户侧看本来就是连续的 body,插桩必须按用户视角重组;chunked 模式下协议往 wire 上写的是 长度\r\n内容\r\n 的帧——在帧层抓,每个 chunk 前面都混着不该算进 postData 的协议开销,POST 一个 10 KB 的 JSON 能被记成 10 KB 加几百字节「不存在的数据」。共享写路径把所有这些形态归一成「用户交出这段字节的时刻」,语义只有一个,漏算和虚算同时消失。
两条路径合起来是一条不变量:观测点必须位于「你关心的语义尚未被改写」的最后一层。 响应体在解码前,请求体在 framing 前——方向相反,原理同一个。
为什么走 diagnostics channel 而不是直接调 inspector
传输层也值得说两句。采集点不在 inspector 里直接写逻辑,而是发布到 http.client.request.* diagnostics channel,再由 lib/internal/inspector/network_http.js 订阅、桥接进 C++ 侧的缓冲和 getRequestPostData。多走这一层不是洁癖,是算账:diagnostics channel 没人订阅时开销接近零,意味着采集逻辑可以长期躺在关键路径上,不用为「没开调试器」的常态付出可见代价;同时它和 undici、http2 已有的事件语义是同一族——三条 client 路径各发各的事件,inspector 只学一种订阅姿势。
缓冲侧同理:body 直接进既有的 inspector buffer 语义,而不是为 getRequestPostData 单开一个缓存。多一套缓存就多一套「什么时候清、上限多少、二进制怎么编码」的私有答案,观测工具的缓存语义一旦分叉,面板看到的就是两套互相矛盾的真相。
还有一层边界要标出来:hasPostData 在 request 创建时是没法精确判断的——body 是后续 write() 才会出现的事实,创建那一刻只能猜。首版的取舍是文本体如实报、二进制体明确 reject,而不是假装全知;协议字段诚实反映「现在知道什么」,比预测未来可靠。
为什么不换个地方偷懒
这个方案不是没有代价。parserOnBody 在 _http_common.js——builtin JS 内部文件,动了它会牵扯 builtin snapshot 构建,增量编译链比改普通 lib/ 文件长一截,构建时间实实在在地涨。当时也认真摆过三个替代:
在 data 事件里把 string Buffer.from() 回去——五分钟能修好 UTF-8 文本场景,但正如前面说的,它对二进制和坏编码是结构性失明,只能当止血,当不了长期实现。否决。
在 _http_client.js 自己推断并缓存请求体——入口直观,但 OutgoingMessage 是所有写路径的共享层,单独在 client 侧推断等于重新实现一遍 write/end/framing 的状态机,跟真实写入脱节只是时间问题。否决,走共享写路径加 ClientRequest 标记。
继续不支持 builtin http 的 request body——零运行时改动,但 getRequestPostData 在 undici/http2 侧已有数据源,builtin http 留着这个洞就是能力断层。用户确认范围后,不采纳。
响应侧也对称摆过「直接在 socket 上搭线」的极端方案——拿的是最原始的 wire 字节,连 TLS 解密后的边界都要自己重切,等于为了取证重新实现半个 HTTP parser。否决逻辑和前面一脉相承:raw 不是越 raw 越好,是要恰好 raw 到「你关心的语义成形」为止。socket 层的字节连「这是 body 还是 header」都还没分家,那不是证据,是原料。
范围也顺手收窄了一刀:首版只承诺文本请求体,二进制 body 继续 reject——getRequestPostData 的 CDP 语义本来就是字符串,为二进制开新字段是把 PR 复杂度翻倍去换一个没人急用的能力。
这个原则其实在所有观测场景通用
写完代码回头看,「在改写点上游取证」根本不只属于网络层。日志中间件放在序列化之前,拿到的才是业务对象而不是它的 JSON 投影;指标在 normalize 之前采样,才不会把「未知标签」统一记成 other;trace 在框架包装层之外注入,才不会把自己的 wrapper 当成调用方。每个改写点都是一次「某个组件替数据做主」的瞬间——解码器决定坏字节是 �,framing 决定 body 长什么样,序列化器决定哪些字段值得留下。
反过来说,改写点下游的观测也不是没价值,只是它回答的是另一个问题:「用户最终看到了什么」。两个答案都对,但不能互相冒充。inspector 的职责在线上事实,所以它必须在 parser 层;如果你的需求是「模拟用户视角」,那 data 事件的 string 反而才是正确的观测面。先决定你要哪个真相,再决定探针插在哪一侧——顺序反了,你就会拿着解码器的口供去审案发现场。
验证清单和一条诚实的边界
会话报告的通过项是一组味道很对的测试:test-diagnostics-channel-http、test-inspector-network-http、test-inspector-network-data-sent、test-inspector-network-http2——四条链路分别从 channel 层、inspector 层、CDP 投影层和协议对照层兜住。分层断言各有分工:channel 层证明事件在写路径上确实发布、payload 带的是用户字节;inspector 层证明桥接没把 chunk 顺序、边界弄丢;data-sent 层证明 CDP 投影到 getRequestPostData 时原样取回;http2 对照层则守住「这套机制没把另一条协议路径带崩」。构建链 ./configure --without-npm + Rust 1.82.0 + make -j8 node,builtin JS 进 snapshot 的代价体现在编译时间上,不在正确性上。
还有个值得记的判案细节:回归测试里冒出过一个 UNABLE_TO_VERIFY_LEAF_SIGNATURE,看着吓人,但它是 TLS 证书链的环境问题,跟 body 语义八竿子打不着。回归红不等于回归是你的错——把环境噪音和语义失败分开记账,是 core 测试纪律的一半。
另一个构建侧的坑顺带提一句:旧构建目录里没有 out/Release/node 时,测试会拿系统 Node 跑,你的改动一个都不会生效——和 bundled undici 那次是同一类「跑的不是你以为的二进制」的鬼魂,只是换了个面具。core 仓库的验证永远从「二进制里到底有什么」开始问,这是血泪条件反射。
同样的诚实边界:这些通过项来自会话转录的最终说明,导出时工具输出被省略了,我也没有在本轮独立重跑那个 checkout。官方 PR(关联 nodejs/node#53946 的 postData gap)当时只到「分支推送 + pull/new 页面」,合没合入 upstream 是另一本账。复盘里的置信度按证据分层写,不掺水。
收个尾
这件事的教训一句话能说完,但值得用一次事故来换:做观测工具时,先在数据流图上标出每一次「改写点」——解码、framing、序列化、normalize——然后把探针插在所有改写点的上游。 下游拿到的永远是某个组件的主观版本,只有上游才有现场原貌。
setEncoding 一行代码就能让精心设计的采集逻辑全线哑火,说明插桩不是「在哪个方便的地方读数据」,是「在语义消亡之前取证」。取证要赶早,这是法医和观测工程师共享的职业道德——等你拿到的是解码器、序列化器、框架包装层层润色过的证词,案子早就冷了。