给 Node core 的 Network Inspector 做 fetch SSE 支持时,我遇到了工程师最怕的一种测试结果:eventSourceMessageReceived 计数恒为 0。
不是报错,不是超时,不是崩溃——就是干干净净的 0。这种失败最磨人,因为没有任何异常告诉你往哪看。更磨人的是,它发生了两次,而两个 0 背后是两类完全不同的故障。第一次是「producer 根本没跑」,第二次是「producer 跑了,但关联键挂错了对象」。同样的症状,相反的修法。
第一个零:你改的代码不在二进制里
三阶段计划的 Phase 2 是给内建 EventSource 发逐消息事件。思路很顺:Undici 自带 EventSourceStream parser,BOM、CRLF、多行 data:、retry、lastEventId 继承全都处理好了,我只要「在已解析出完整消息的位置」发一条 diagnostics,桥接层再投影成 CDP 事件。
改完 deps/undici/src/lib/ 下的源码,跑测试——0 条消息。
查插桩写错了?加日志,没有输出。查事件订阅?channel 名字对得上。查 parser?单独喂字节流能解析。最后才发现一个让我哭笑不得的事实:Node 跑测试时加载的根本不是 deps/undici/src/**,而是 deps/undici/undici.js——一个两万六千多行的打包产物。
这个结构其实合情合理。Node 把 Undici 当 vendored dependency 收进 deps/,上游是多文件源码树,但内建进二进制的必须是单个自包含产物——打包一次,进 builtin snapshot,运行时直接加载。源码树是「给人维护、跟上游同步」的,bundle 是「给机器执行」的。我在 src/lib/web/fetch/index.js 里精心摆放的 diagnostics 发布点,对运行时来说就像贴在一本没人会打开的手稿上的便签。
当时还认真考虑过一个偷懒方案:让 lib/internal/inspector/network_undici.js 直接 require 源码目录里的文件,绕开 bundle。否决得很快——运行时 fetch 走的依然是 bundled 路径,就算 inspector 读到了我的源码改动,事件也还是 0,只是 0 得更难查。这不是「换个加载路径」的问题,是「同一份逻辑存在两份实体」的问题,绕过等于制造第三份。
我改的源码安安静静躺在源码目录里,测试二进制里执行的是 bundle 里那份没被动过的拷贝。插桩不是「写了但没触发」,是压根不在进程里。0 条消息是对这个情况最诚实的报告。
这是 userland 开发和 core 开发的分水岭。在 npm 包里你改 src/ 跑测试,天经地义;在 Node 里,deps/ 下的第三方依赖有「上游源码 → 构建生成 → bundled 产物 → 测试二进制」四本账,改第一本不等于后三本认账。make -j8 node 是增量构建没错,但它增量的是「bundle 变化后的重编」,不是「你刚编辑的那个源文件」。后来这成了我的肌肉记忆:core 改动的第一件事,永远是确认二进制里跑的是哪份代码——必要的时候在插桩函数入口塞一条打印,先看它进没进进程,再谈逻辑对不对。
第二个零:requestId 挂在了没人读的对象上
把 producer 同步进 bundled runtime 重新构建,再跑——还是 0。
这次的 0 更阴险。加最小 diagnostics 脚本一路追,发现消息其实发出去了,parser 正常工作,事件也确实抵达桥接层。问题出在关联键:每条消息事件都要挂一个 requestId,DevTools 靠它把消息归到 Network 面板里那条具体请求上。而我的 requestId,写在了一个没人读的对象上。
机制是这样的:Undici 的 fetch 实现内部会走 cloneRequest()——重定向跟随、body 复用、认证质询重试,这些场景都需要一份「内容相同、生命周期独立」的请求副本。inspector 在 request:create 诊断点上拿到的是 clone 出来的那个 Request,requestId 顺理成章挂在了 clone 身上。但 EventSource 的 producer 读消息归属时,看的是原始 request——用户 fetch() 创建、穿过整个 pipeline 的那个对象。
这里还摆过一个看似更顺手的方案:干脆把 requestId 写进 clone——它离 request:create 事件对象最近,改起来一行的事。否决理由一句话:EventSource producer 读的是 inner original request,id 写在 clone 上等于把钥匙挂在了别人腰上。修 bug 不是找「最方便写入的位置」,是找「读取方真的会看的位置」。
结果就是:消息事件每条都发了,每条都带着一个 requestId,只是这个 id 属于一条 DevTools 视角里「不存在」的内部 clone。消息流水账记了,账本的户名写错了。面板上的 EventStream 页签依旧是空的,测试依旧是 0。
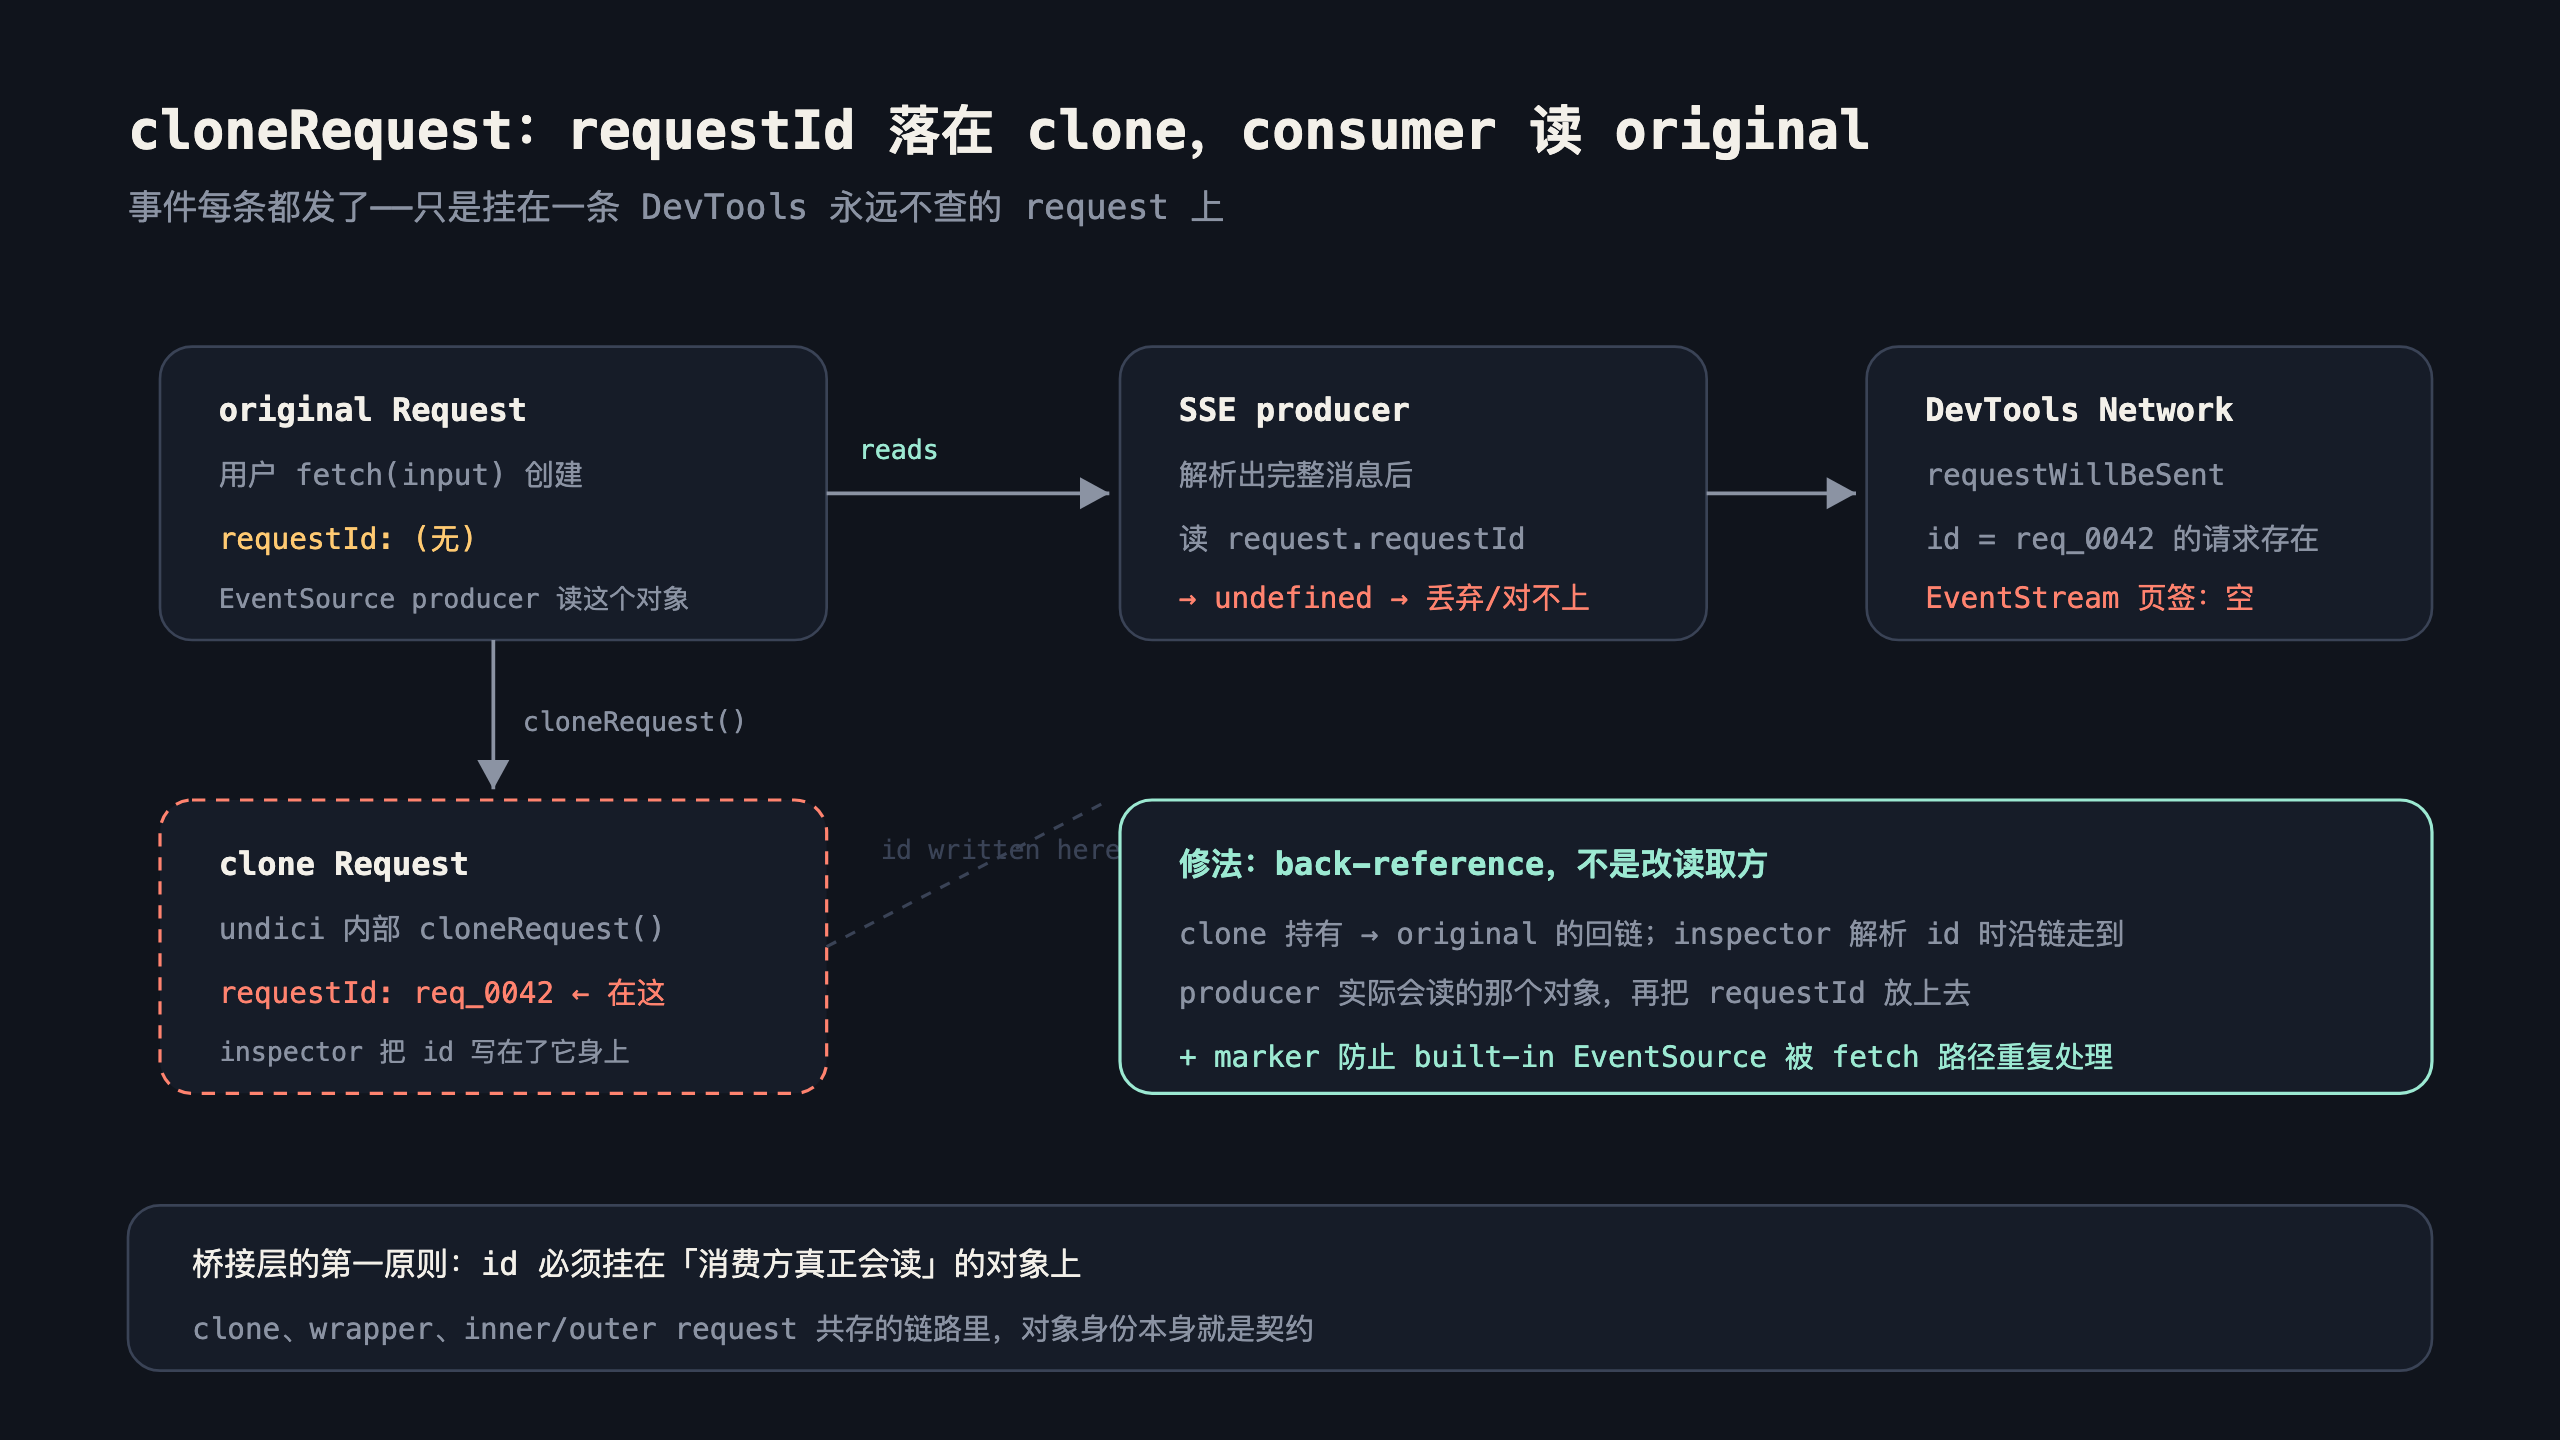
修法不是改读取方——producer 读 original 是对的,那是语义上真正的请求。修法是给它一座桥:让 clone 持有指向 original 的回链,inspector 解析 requestId 时沿链走到「消费方实际会读」的那个对象,再把 id 放上去。顺手加一个 marker,防止内建 EventSource 被 fetch 侧路径当成普通流重复处理一遍——同一条连接在面板里出两条记录的事故,我在 WebSocket observer 那边已经栽过一次了。
这个坑的可复用性远超 SSE:任何事件桥接,id 都必须挂在「消费方真正会读」的对象上。 clone、wrapper、inner/outer request、proxy 共存的链路里,「这是同一个逻辑请求」是人脑里的概念,机器只认对象身份。写事件的人觉得 id 给了「那个 request」,读事件的人读的是另一个 request——双方都做了局部正确的事,合起来全局错误。
协议侧其实只动了四块砖
把视野拉高一层,这次改动的协议桥其实薄得可怜:src/inspector/domain_network.pdl 里加 Network.eventSourceMessageReceived 的事件定义,src/inspector/network_agent.cc 里加对应的 emitter,lib/inspector.js 导出 JS 侧桥接,lib/internal/inspector/network_undici.js 订阅 diagnostics channel 做投影。真正的心脏在 deps/undici 的 fetch 实现里——在解压后的正文路径上、消息被 EventSourceStream 语义组装完整的位置,发布 undici:fetch:eventsource:message。
「解压后」三个字值一篇论文。bodyChunkReceived 这类靠近网络的插点拿到的是 gzip/br 压缩态字节——你在那解析 SSE,等于拿压缩包当文本读。而 TCP 分片不看消息边界,一条 data: {...}\n\n 可能横跨三个 chunk。所以插桩只能坐在「解码完成、消息成形」的最后一层,这层在 Undici 内部恰好是 EventSourceStream 的输出侧。位置选错,后面所有测试都在验证一个错误的东西。
然后我做了一次范围裁剪
两个阶段都跑通之后,摆上桌面的实现其实有三块:内建 EventSource 的逐消息 producer、fetch() SSE 的解压后 producer、undici.fetch() 内部入口的额外测试加 --experimental-eventsource 和 --expose-internals 两个调试 flag。
全放进首个 PR?覆盖面是漂亮,但 reviewer 看到的 public surface 就等于你的承诺清单。内建 EventSource producer 意味着我们承诺维护一套独立的 EventSource 生命周期语义;undici.fetch() 测试等于把内部 API 摆上了验证台面;实验 flag 更是明晃晃的新入口。首版真正被用户确认的范围只有 fetch() + http/https——多出来的每一样,都是未来兼容性上要还的债。
当时也纠结过「既然都做了,为什么不一起交」。三个理由压住了冲动:其一,review 成本按 surface 面积算,不按实现工作量算——三个 producer 意味着三份语义要评审、要回归、要写文档;其二,内建 EventSource 和 fetch SSE 共享一部分 Undici 路径,但消息解析层的对象身份不一样(就是刚才那个 clone/original 的坑),一起交等于让 reviewer 在心智里同时跑两套关联模型;其三,stash 不是删除——探索成果可恢复,后续阶段拎包入住,代价只是延迟,不是损失。
裁剪方案:保留协议事件、fetch SSE producer、http/https inspector 路径和 fetch SSE 测试;内建 EventSource producer、测试、两个 flag、undici.fetch() 的公开验证,全部收进 stash@{0}。分支就叫 feat/inspector-fetch-sse,测试文件改名为 test-inspector-network-fetch-sse.js——让 PR 的 public surface 和测试文件名逐字对齐,reviewer 一眼能核对「这版到底承诺了什么」。较大的实现留在 stash 里可恢复,不丢探索成果,也不强塞给评审。
这个决定回头看仍然正确:PR 被 review 的速度,跟「需要确认多少隐含承诺」成反比。把范围砍到和文件名一致,本质上是把「你需要担心什么」压缩到一眼可查。
验证与没验证的边界
会话里报告的验证:make -j8 node 构建通过,定向测试覆盖了一批我想看到的硬场景——消息跨 chunk 边界重组、CRLF 行尾、多行 data: 拼接、id 继承、gzip/deflate 压缩响应、错误 Content-Type、协议事件参数校验。这些是 SSE 的语义要害:chunk 边界和消息边界从来不是一回事,压缩态字节里连 event: 这几个字符都不存在,所以 parser 必须坐在解压后的正文路径上,而不是 raw chunk 插点上。
测试清单里我最在意的是 id 继承那条:lastEventId 是跨消息演进的状态,不是每条消息的孤立字段——前一条没给 id,后一条要继承上一次值;投影丢了这层语义,EventStream 页签就是一本撕掉页码的账。压缩响应那条同理:gzip 包着的 SSE 流,消息事件必须和「解压后的文本」语义一致,而不是和 wire 字节一致——这是整个插桩位置决策的回声,值得一条独立断言守着。
但也要诚实标记边界:这些结果是会话转录报告的「通过」,我没有在本轮独立重跑那个 checkout,Screenpipe 也没有同期屏幕证据。所以我的置信表述是「实现完成、会话报告验证」,而不是「已核实合入」——这两者之间隔着一个重跑 make 的下午,写复盘时不把前者升级成后者,是给自己的证据纪律兜底。
叠在一起的故障只能按顺序揭晓
还有个值得单独说的结构性质:这两个 0 是串联的——不修好 bundle 同步,requestId 那个坑连露面的机会都没有。你在第一个故障没排除时,连第二个故障的「作案现场」都进不去;每修掉一层,测试才肯告诉你下一层坏在哪。
这就是为什么「一口气把怀疑点全改一遍再跑」是坏策略:如果碰巧修对了两层,你不知道哪一层起了作用;如果只修好第一层,输出还是那个熟悉的 0,你会误判「改的方向不对」然后回滚掉正确的修复。分层故障的正确姿势是逐层锁定、逐层验证——每修一层,给这一层单独留一个可观测信号,确认它真的活了再往下走。这也是为什么我在 producer 里留 diagnostics 日志而不是等到 CDP 投影再观测:观测点离故障点越近,一层故障就越不可能冒充另一层。
收个尾
两次归零教会我的排查顺序:看到恒 0,先问「producer 在不在进程里」,再问「事件发没发」,最后问「关联键对不对」。三层对应三种故障:构建/打包没带上、逻辑没走到、对象身份对不上——越往后越难查,因为越往后系统表现得越「正常」。
零结果从来不是一种结果。先分清你的 0 是「没发生」还是「对不上」,再决定往哪个方向修——这个二分法省掉的不是时间,是往错误方向狂奔的那一下午。以及在 core 仓库里,src/ 和 bundle 是两份实体这个常识,值得被写进每个人的开工清单第一行。