去年我在维护一套自建的 Expo Updates 服务。OTA 更新听起来是个很简单的系统:客户端问一句「有没有新 bundle」,服务端答一句「有,拿这个」。整个协议的核心交互一次握手就能讲完,剩下的都是工程量——至少我当时是这么想的。结果一个月里我被三个坑轮流教育,而这三个坑的唯一共同点,是它们都藏在「看起来不可能会错」的地方。
先交代一下战场。这套服务管着移动端 bundle 的发布和下发:客户端带上自己的 runtimeVersion、channel、当前 update ID 来问 /api/manifest,服务端查一圈库,决定给它哪个 bundle 或者告诉它「你手里的就是最新的」。背后是一套不算复杂但也不寒碜的数据模型——App、Channel、Binding、RolloutPlan、Bundle,再加一个用来记设备状态的 DeviceSession。app 本体是 Next.js,旁边还挂着一个 AI Service 共用这个库。全部家当架在 RDS 上的 PostgreSQL。
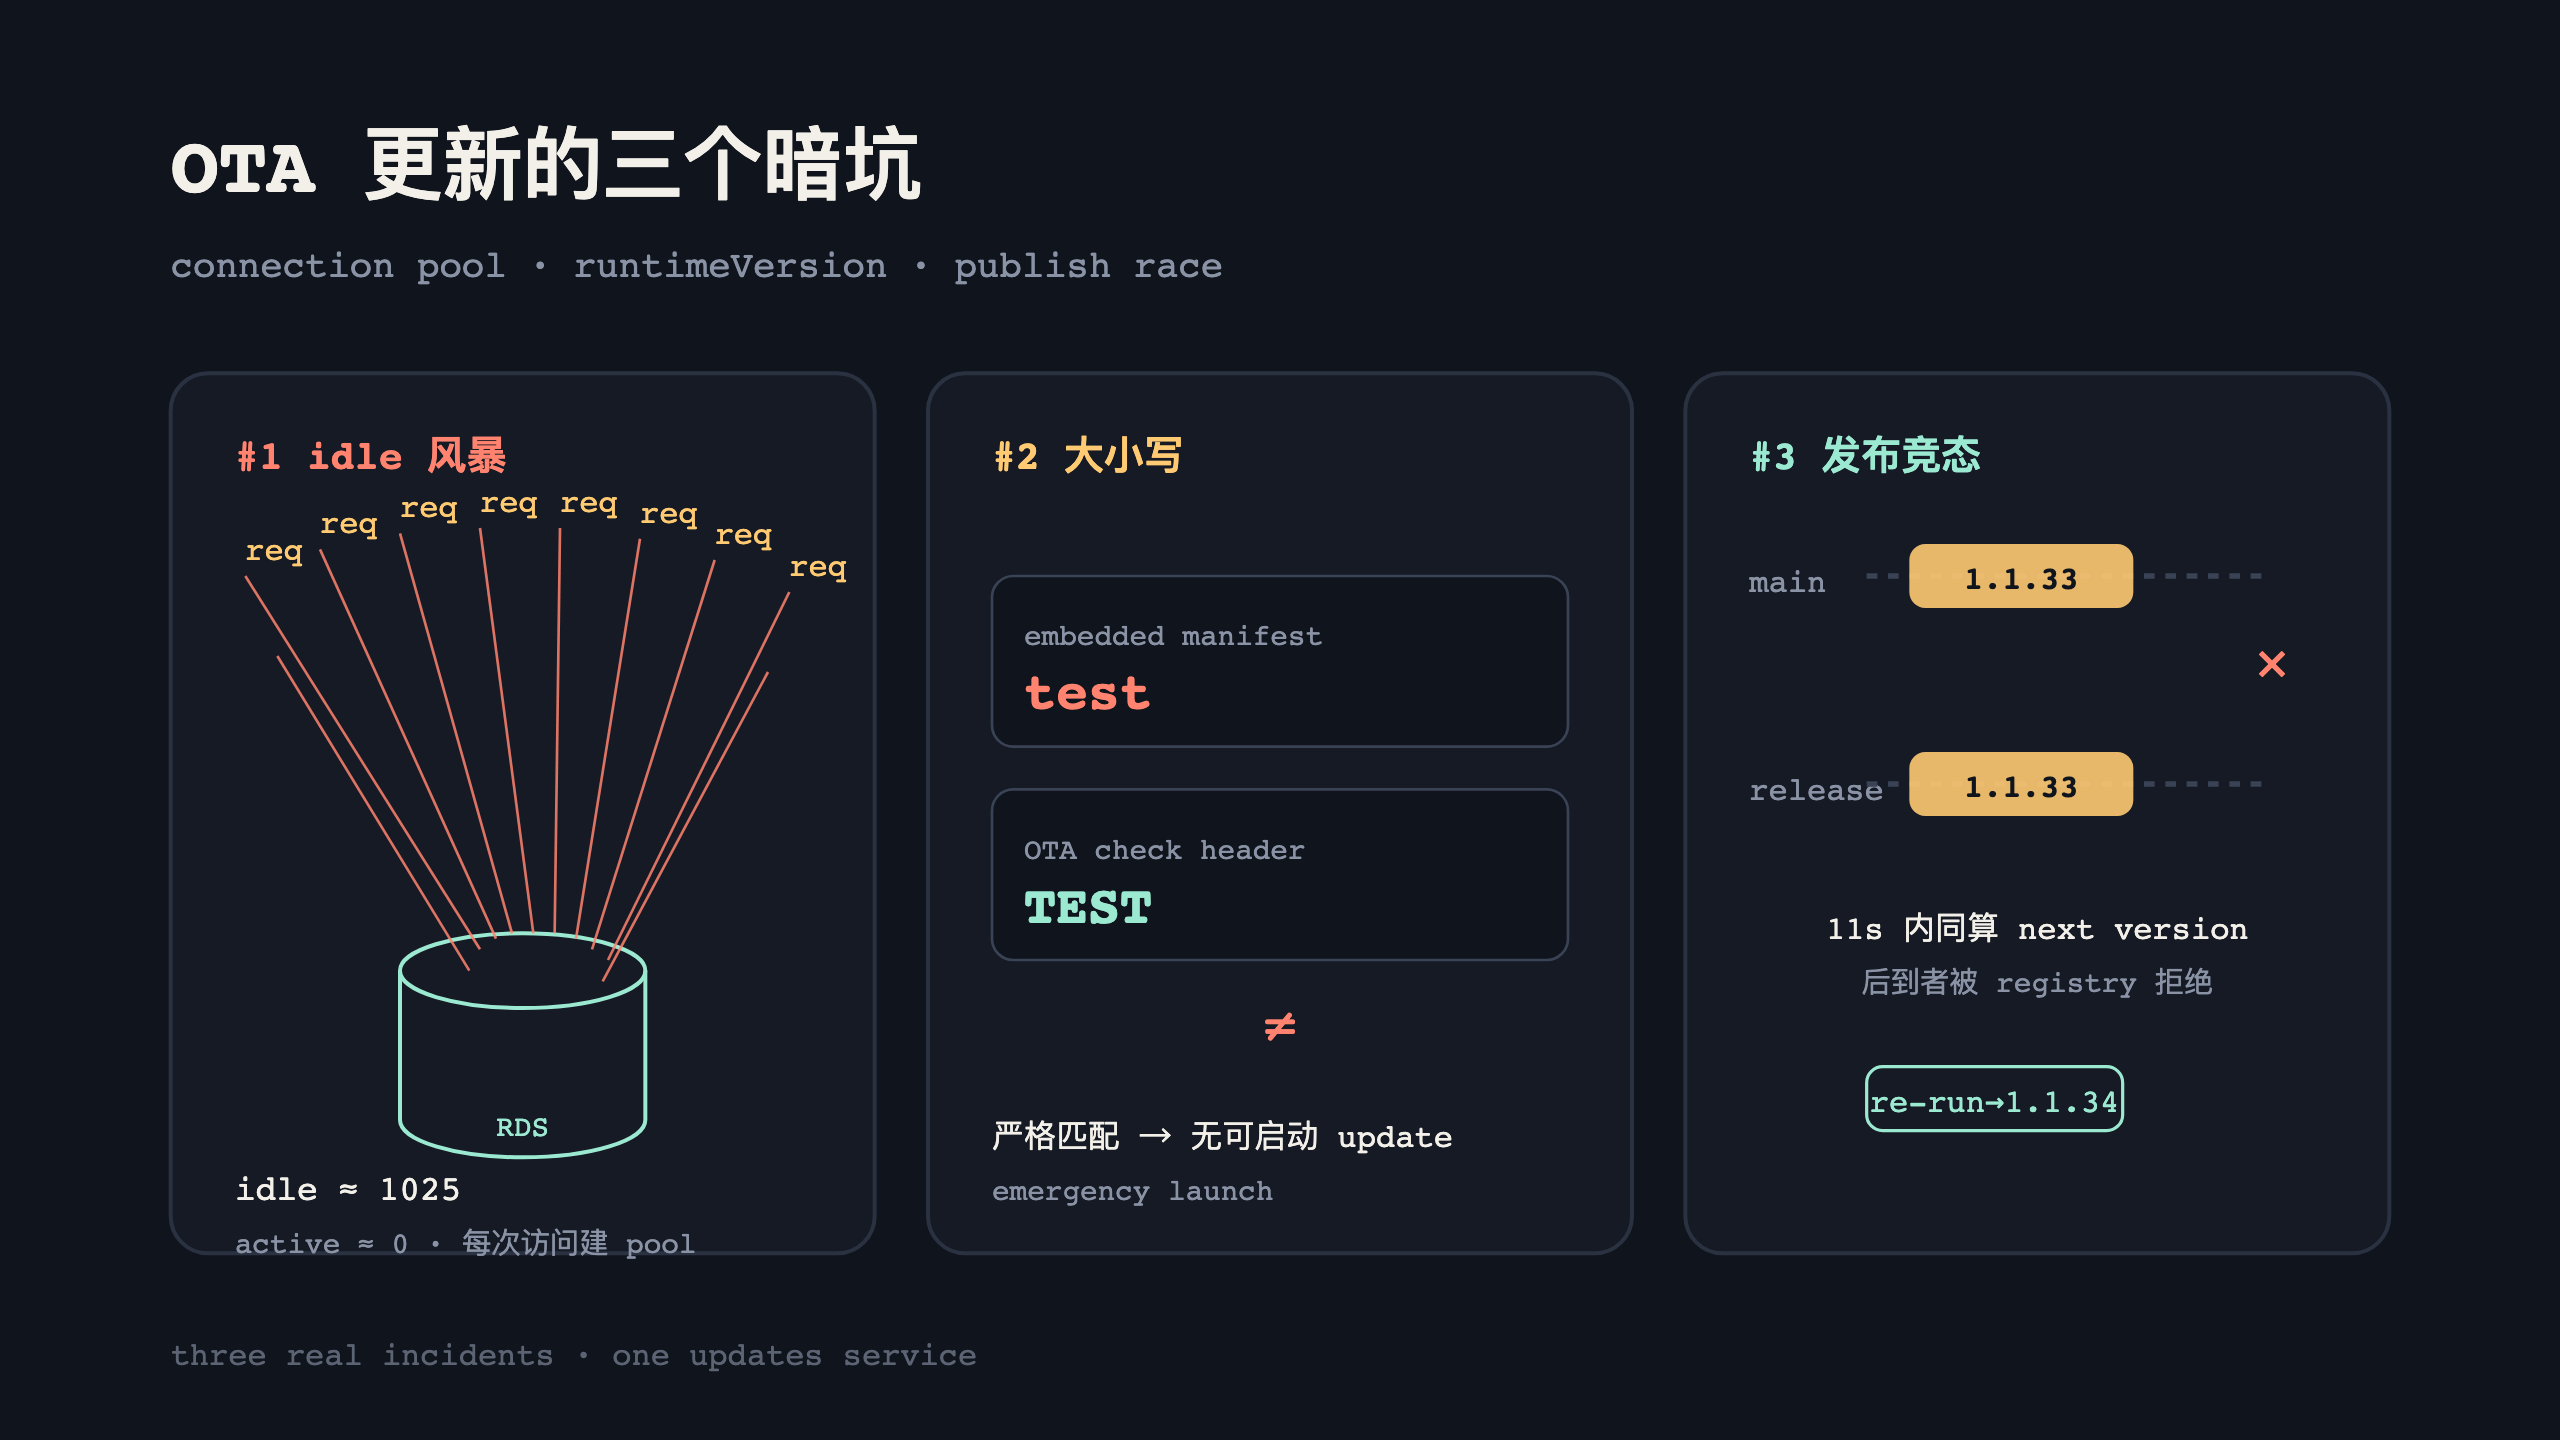
坑一:一千个没人用的数据库连接
先是监控告警:RDS 上 idle 连接破千,active 却低得可怜,期间没有任何发布或重启。这个组合很贼——active 低说明不是慢查询在堆栈,idle 高说明有人不停建连接又不用。如果是正常业务流量打满连接池,你看到的应该是 active 和 idle 一起涨;只有「建了不用、用完不扔」才能造出这种畸形曲线。
这里插一句方法论,后来我用它逮过好几个同类问题:连接数诊断先分 active/idle 定性,再用「请求率 × 每请求资源创建数 × 生命周期」建数量级模型。定性错了,后面所有数学都是给错误答案抛光。
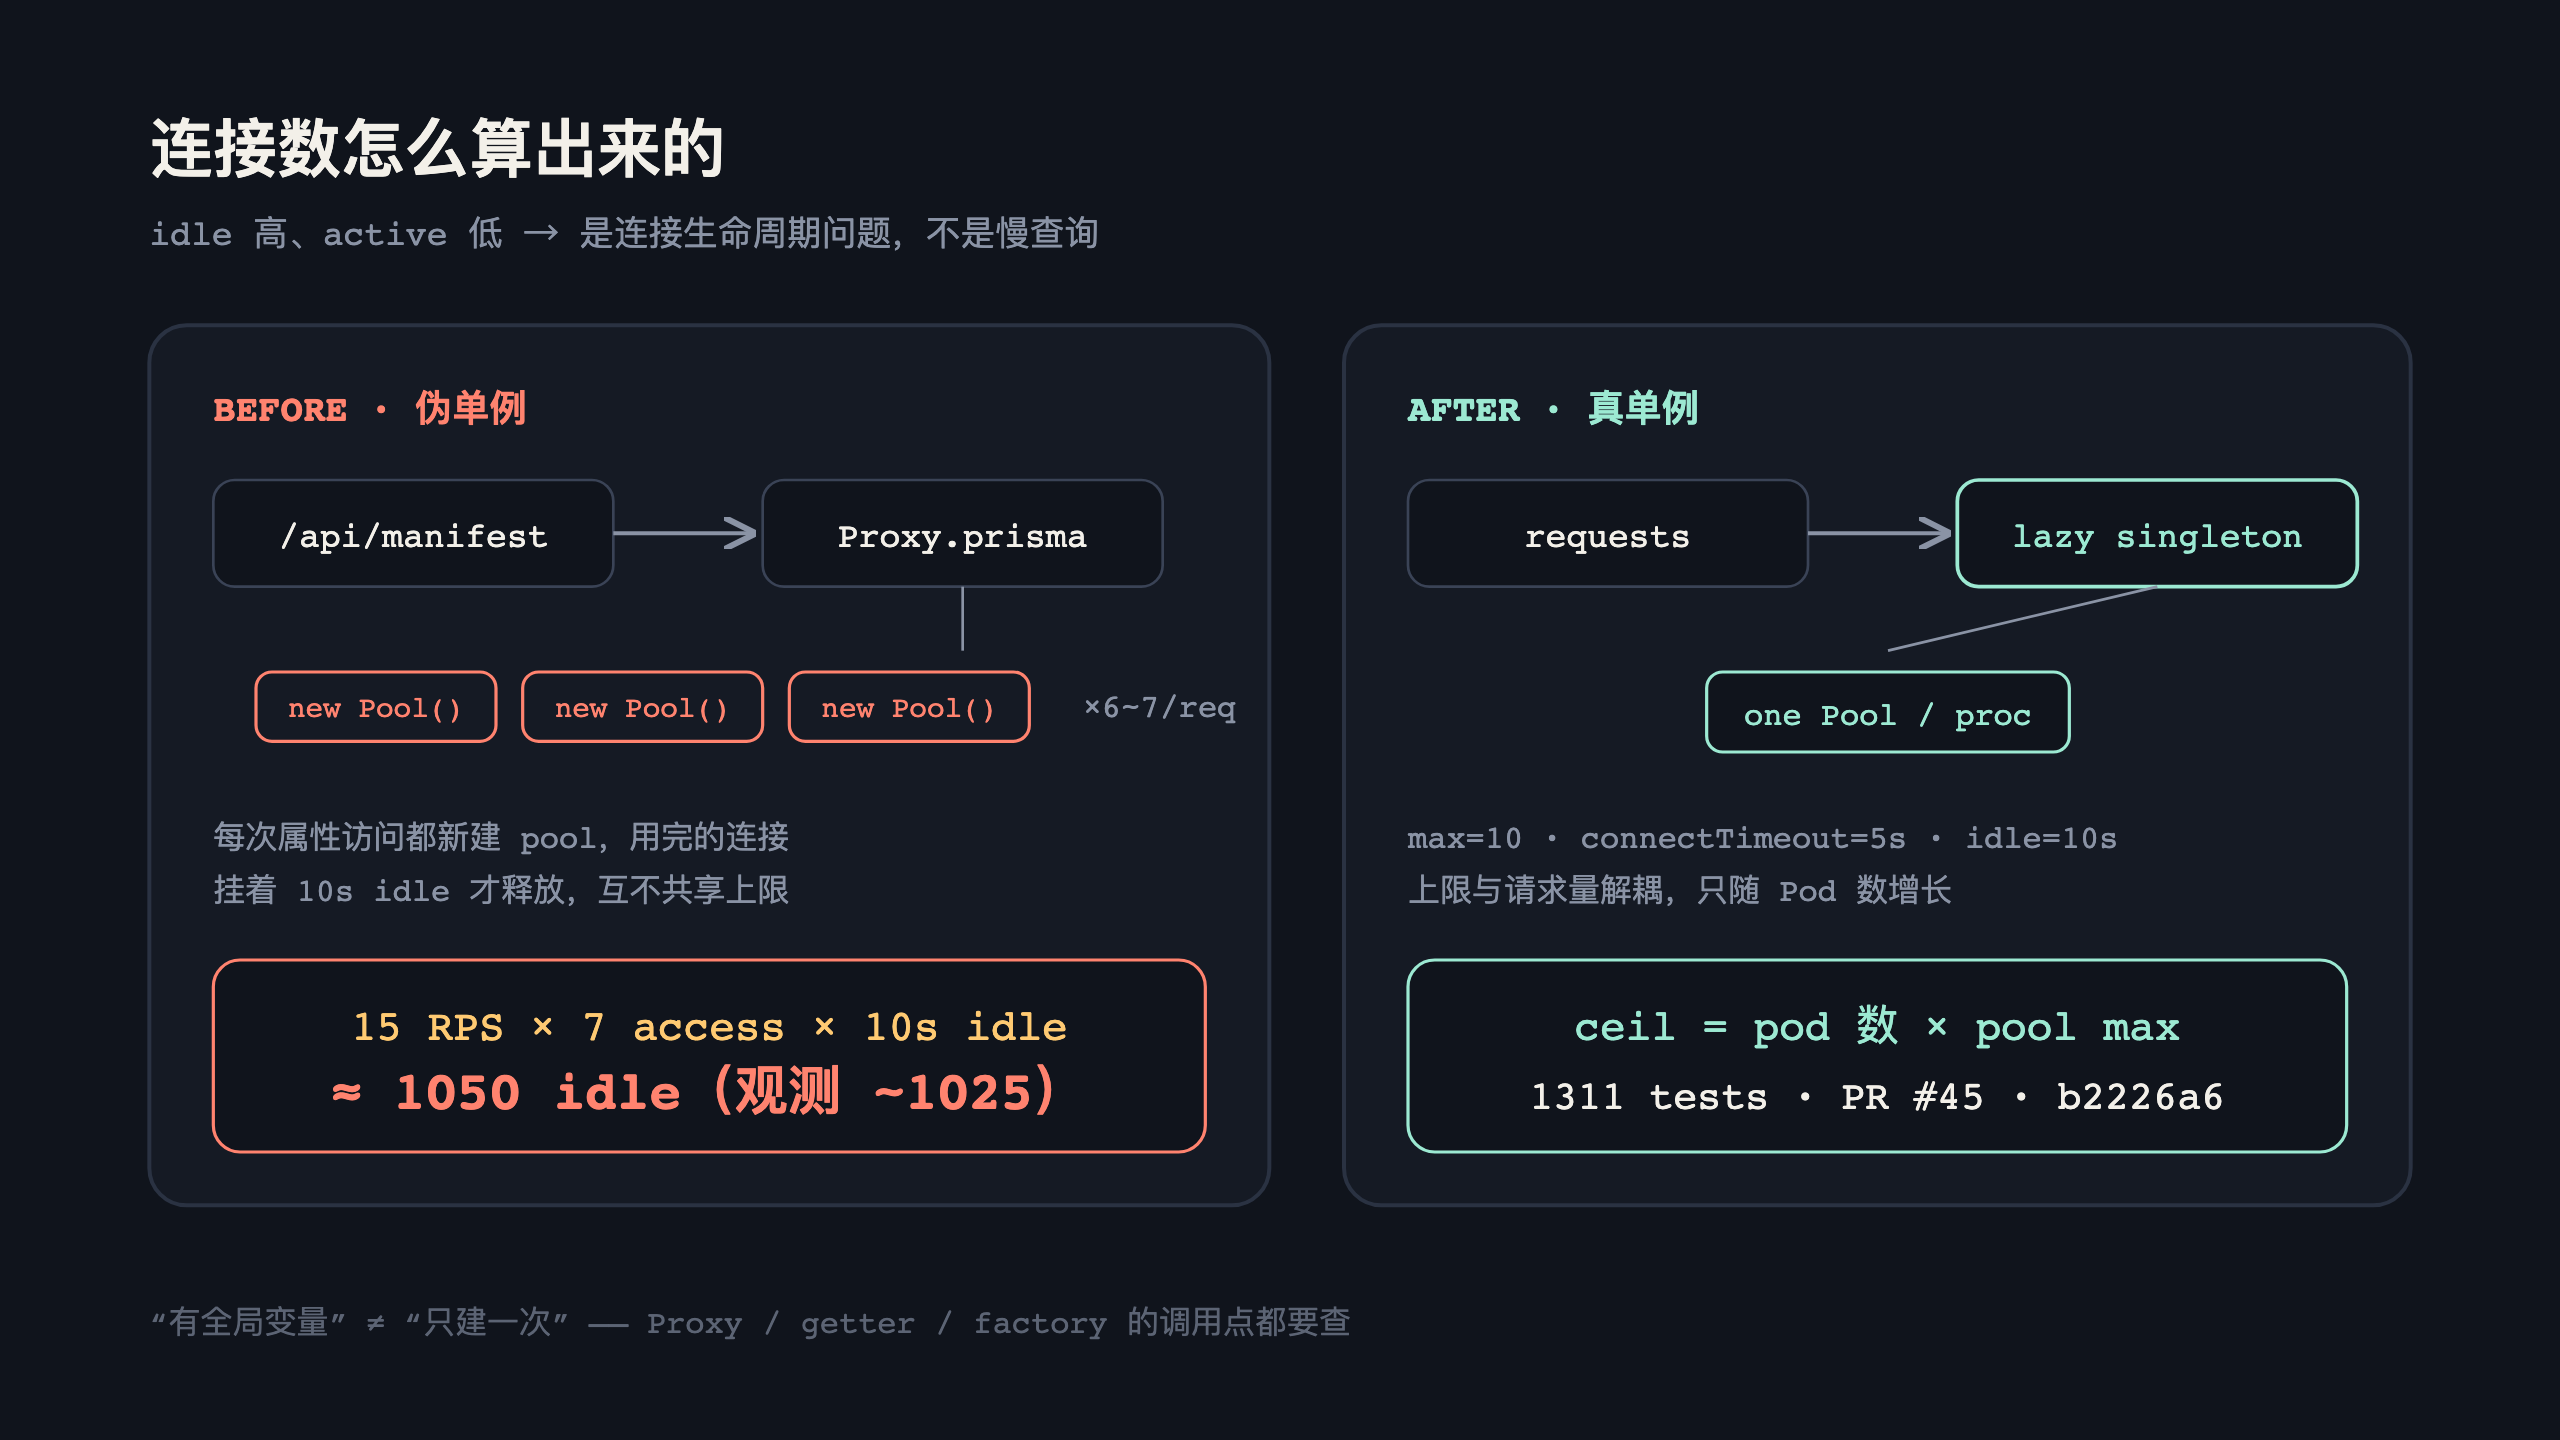
查代码发现 lib/prisma.ts 用了个「伪单例」:开发环境把 Prisma client 挂在 globalThis 上缓存——这是 Next.js 圈的经典配方,为了扛住 dev server 的热重载;但生产分支不缓存,外面还套了层 Proxy。于是生产上每次属性访问都新建一个 Pool。注意,不是每次 new PrismaClient 才建池,是每次 .prisma 这个 getter 被摸到就建一个——访问模式和创建频率是 1:1 的。
而 /api/manifest 这条热路径一次请求要查六七次库:校验 App、Channel、Binding、RolloutPlan、Bundle,回头再查一次 App,最后 upsert 一个 DeviceSession。每一查都经过那个 Proxy。算一笔账:约 15 RPS × 7 次建池 × 10 秒空闲保留 ≈ 1050 个连接,和观测到的 1025 几乎严丝合缝。数字对上的那一刻,比告警本身还让人踏实——排障最幸福的事不是「好像修好了」,是「我算出来的数和监控里的数是同一个数」。
这套公式的另一半价值是预判:任何一个「每请求创建一次、用完靠 GC」的资源,只要把三个数代进去,就能算出它在什么流量下会爆。连接、文件句柄、临时线程池,全是同一个模具。
还有个隐蔽的放大器:这些临时 pool 各自都有自己的 max,各自管自己的 idle 回收,每个 pool 都觉得自己很节制——但决定连接总数的从来不是单个池子的上限,是池子的数量本身不设防。全局变量层面你看到的是「一个 prisma 实例」,连接层面其实是「一片各自为政的池子共和国」。
修复很朴素:所有环境共用一个懒加载单例,max=10、连接超时 5 秒、idle 10 秒。懒加载不能去掉,因为 AI Service 有环境变量加载顺序的依赖——这是个真实约束,不是洁癖;顺手我还得保证不碰用户本地的 .env,不夹带任何数据库变更。改完之后,连接上界从「请求数 × 查询数 × idle 窗口」收敛成「Pod 数 × 10」——从跟着流量呼吸的变量,变成一个可以拿手指头算出来的常数。
PR #45(commit b2226a6)过完全部 193 个 suite、1311 个测试上线。为什么不重启 Pod 或者扩 RDS 上限?重启只是把浴缸水放了,水龙头还开着;扩容是给漏水点加薪——漏水的速度配得上更大的上限,你就永远在为同一个 bug 交两份钱。但要诚实说一句:上线时我没拿到部署后的 RDS 曲线,连接数掉下去是高置信预期,不是已测结果。修 bug 的最后一步「回头看一眼曲线」,在我的交付清单里是欠着的。
真正的教训是:「全局变量存在」不等于「只创建一次」。Proxy、getter、factory 的每一个调用点都得查——单例是个关于「创建路径」的命题,不是个关于「变量声明」的命题。
坑二:一个字母的大小写
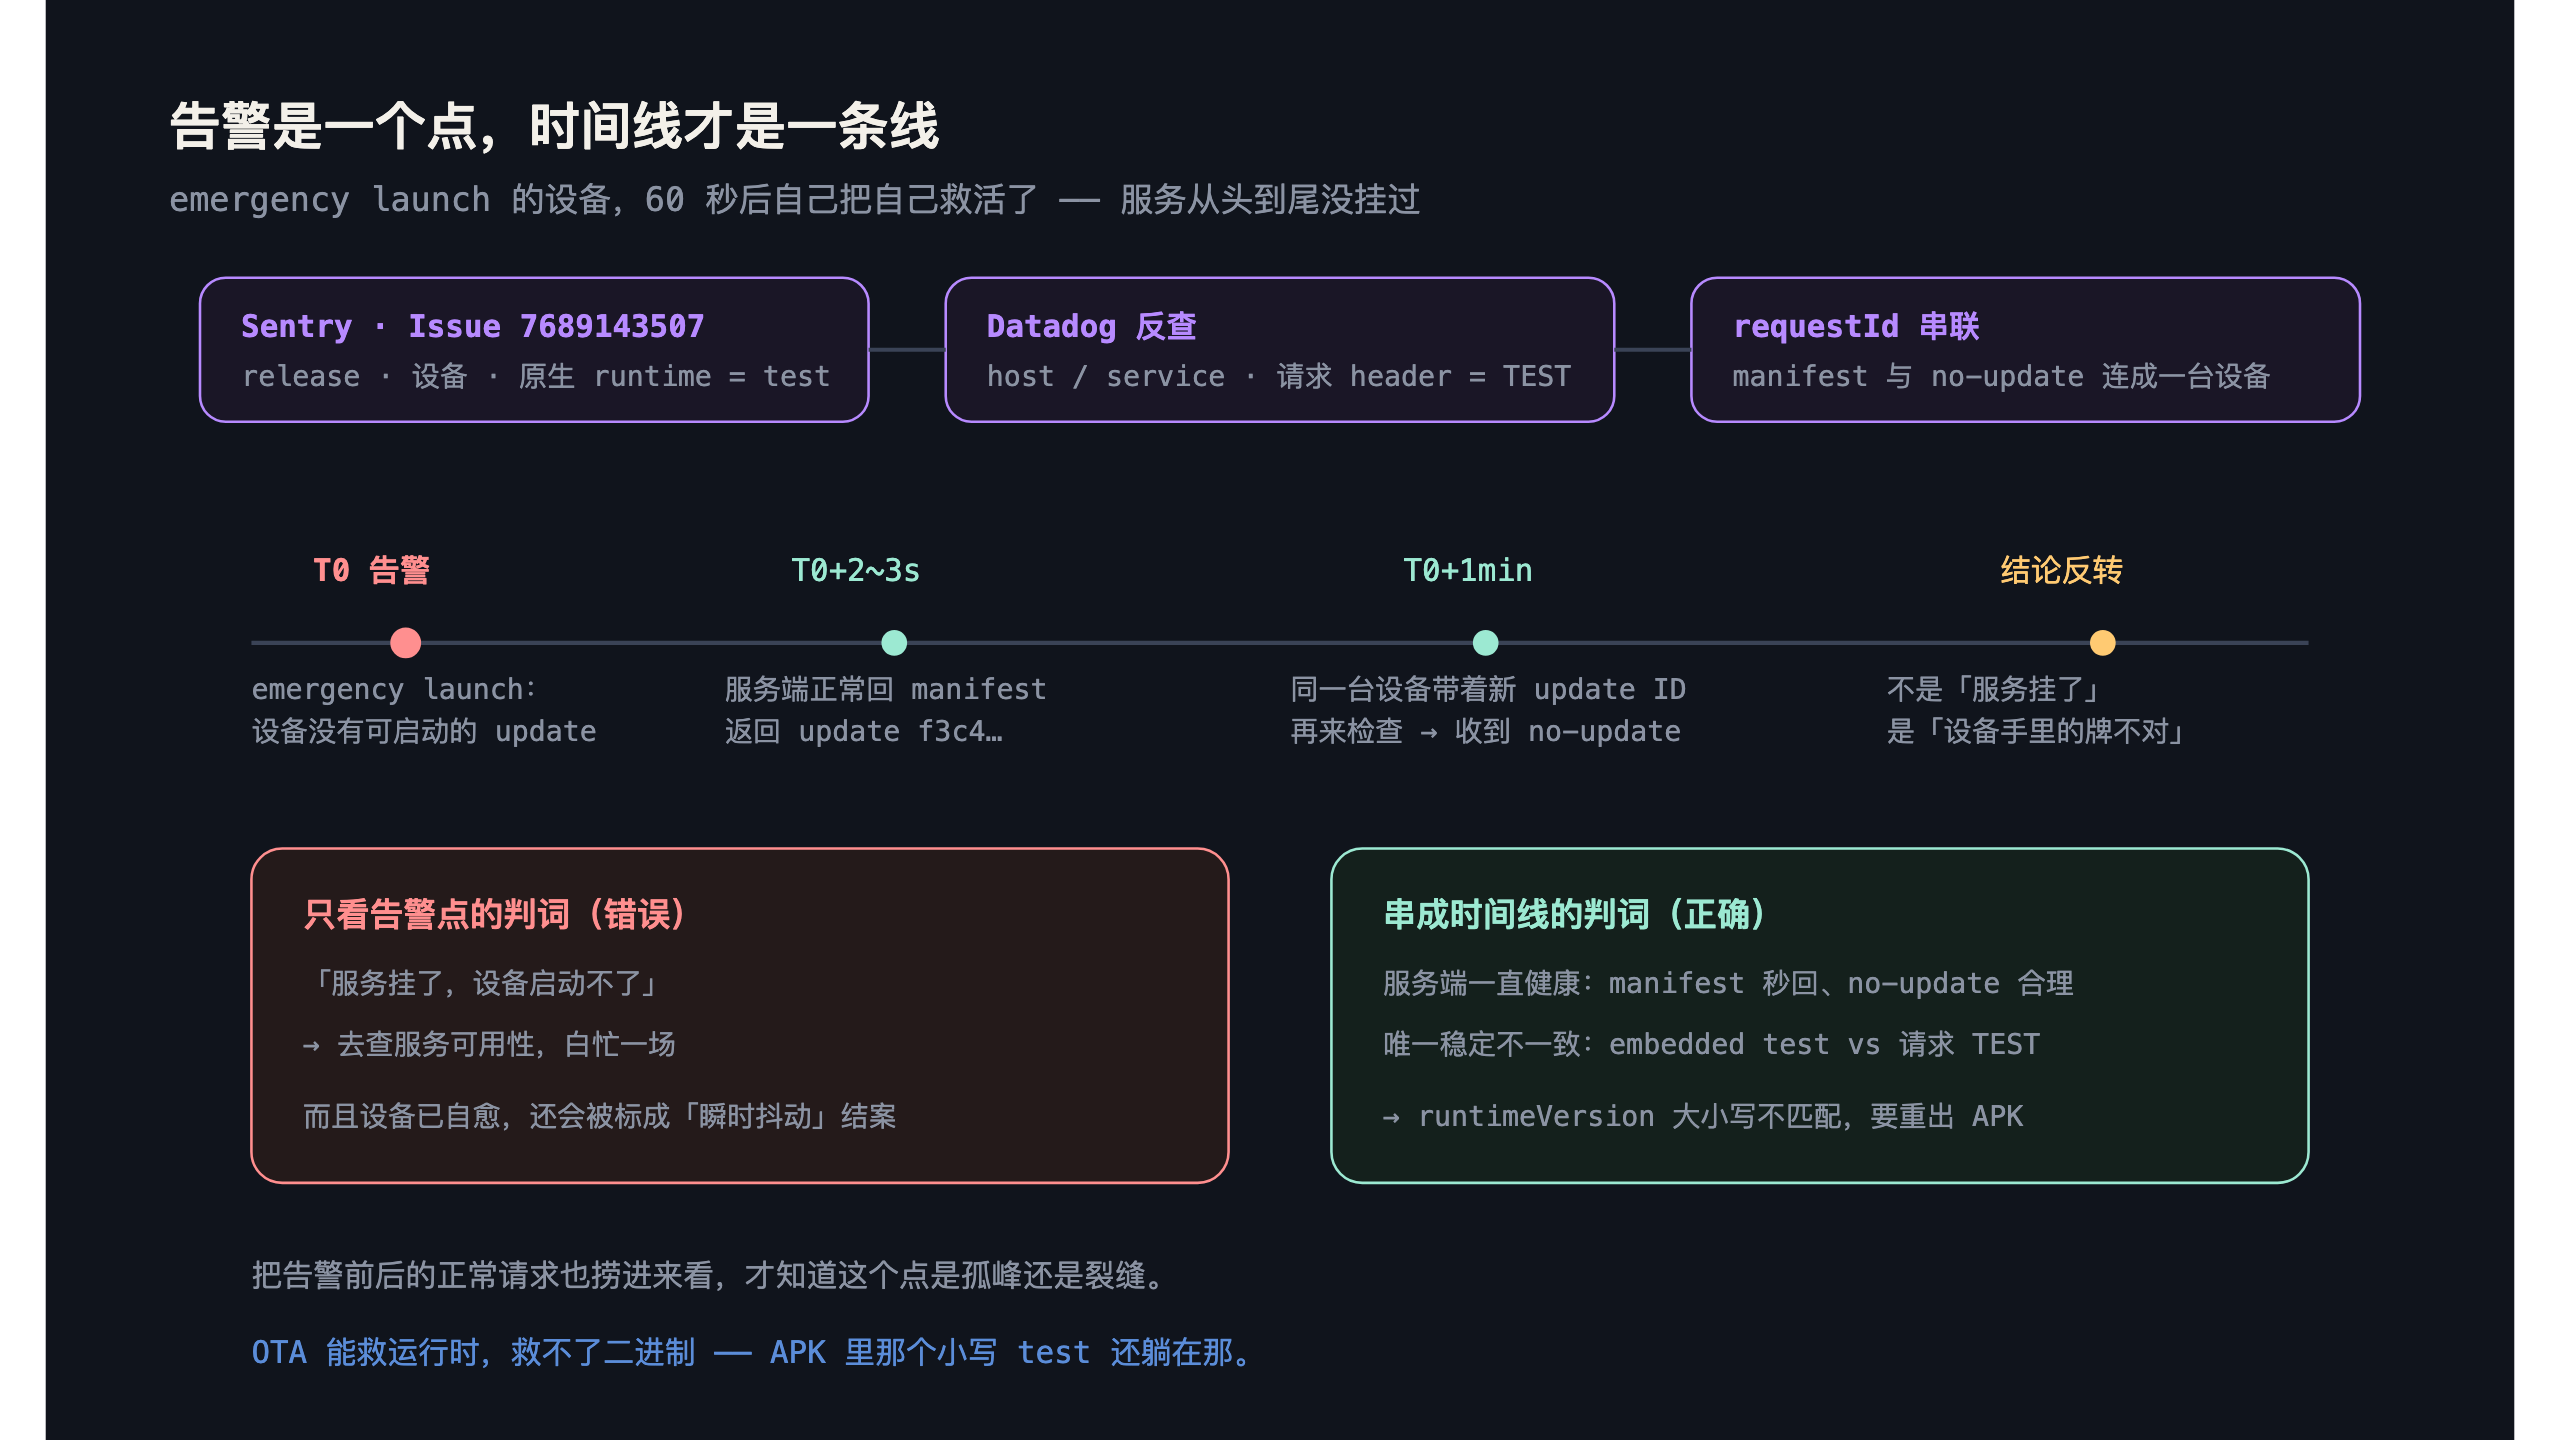
接着 Sentry 报了个 Android testing 的 emergency launch(Issue 7689143507):设备没有任何可启动的 update。第一反应是服务挂了,结果时间线一拉,故事完全不是那个形状:告警后两三秒服务端正常回了 manifest,返回了一个新 update(ID 开头 f3c4);约一分钟后,这台设备带着新 update ID 再来查,收到 no-update——也就是说它早就自愈了。设备从头到尾都在跟一个健康的服务端说话。
观测链是这么串起来的:Sentry 的 release、设备和原生 runtime 上下文,反查 Datadog 的 host/service,再用 requestId 把 manifest 和 no-update 两条请求连成一台设备的时间线。单看告警是「服务挂了」,串起来看是「服务一直活着,是设备手里的牌不对」。这个手法值得单独记住:告警是一个点,时间线是一条线。把告警前后的正常请求也捞进来看,才知道这个点是孤峰还是裂缝。
这里还出了个插曲,说出来引以为戒:排查途中需要往 Datadog 发请求验证 header,session 里一度出现了凭据明文。发现之后立刻撤销轮换——debug 的时候人最容易犯的错就是为了「赶紧看一眼」把 token 粘进聊天框。工具越方便,这个反射弧越要刻意练。
服务没问题,路由也没问题。这里有个诱饵值得展开讲讲:ns-production 这个 namespace 居然承载着 testing channel 的流量——看着就像路由写反了。我找同事确认过,这是预期设计:mobile 的分支映射把特性分支映到同名 channel,而 EXPO_BUNDLE_SERVER_URL 决定了 bundle 实际传到哪个环境,非生产构建也可能指向生产域名。「名字像生产」和「服务的是测试流量」在这个系统里可以同时成立。排查时这种「看着可疑」的路标,一定要拿当事人的确认来排除,不能拿自己的直觉当证据。
真正的嫌疑人藏在原生上下文里:APK 内置 manifest 的 runtimeVersion 是 test,而客户端发起检查请求时带的是 TEST——common/env.ts 里仓库约定就是大写。Expo 把 runtimeVersion 当兼容性主键,严格匹配,区分大小写。要理解这台设备为什么摔,得先知道 launcher 手里的牌:启动时它在「本地缓存的 update」和「APK 内置的 embedded update」之间挑一个 runtime 匹配的跑。缓存那份的 runtime 是大写——那是从服务端按 TEST 名义下载的;内置那份是小写——打 APK 的时候跟着包名烙进去的。两张牌的 runtime 都和设备自报家门的 TEST 对不上,launcher 两手一摊,只能 emergency launch。
这个大小写不匹配的来源也很有意思:它说明打包时烙进二进制的那份配置,和运行时代码读的那份配置,在某个环节走了岔路。大小写这种差异不会在任何测试里报警——字符串相等函数在单元测试里永远拿同一侧的值,只有到了「二进制里烙的值」对上「运行时发的值」这个跨世界接缝上,一个字母才变成一颗雷。
最阴险的是:新 OTA 下发后设备确实恢复了,所以这事差点被标成「瞬时抖动,已自愈」。但 OTA 救得了运行时,救不了二进制——APK 里那个小写 test 还躺在那,下次缓存再失效照样摔。OTA 恢复不等于 embedded fallback 健康,修这个得重新出包,不是再发一个 bundle 的事。当时会话结束时,APK 重出包和无缓存启动验证都还是待办——诊断闭环了,修复没有。还有一个没排除干净的次级假设:会不会是前一个 JS 启动错误先把缓存 update 干回滚了,才露出这个 runtime 不匹配?现有证据不够推翻主结论,但也不够把它彻底划掉。诚实的复盘要把这种「差不多确定但还差一块」的角落写出来。
坑三:11 秒内撞车的版本号
刚修好连接池,部署时 CI 又挂了,这次在 CLI publish 阶段。日志显示:main 和 release 两条流水线在 11 秒内先后启动,各自读 registry 当前版本、各自算出 next version 都是 1.1.33。release 先发布成功,main 后到,被 registry 拒绝——「读当前值 → 加一 → 发布」不是原子操作,两个并发执行体共享这个算法就是裸奔。
这个算法平时看起来人畜无害:check 当前版本、bump、publish,CI 里教科书级的三步。问题在于它的每一步都正确,合起来却是一个分布式系统里最经典的 read-modify-write 竞态——「当前版本」是共享状态,「加一」是本地计算,「发布」是乐观写入,中间没有任何一步问过「在我读和写之间,世界变了没有」。平时不出事只是因为两条流水线很少同时醒;那天我修连接池的 PR 和 release 流程撞在同一个窗口,等于两个沉睡的并发假设同时被叫醒。
当时有人猜是 registry 缓存抽风——毕竟「撞同一个版本号」听起来太像缓存幻觉了。但日志证明是实打实的竞态:release 那条线真的把 1.1.33 发出去了,registry 的拒绝是在保护它。这个区分很重要:把竞态误诊成缓存问题,你会去刷新一个无辜的组件;把缓存问题误诊成竞态,你会去锁一个无辜的算法。两种修法都很贵,而且都修不对。
重跑生成 1.1.34,部署恢复。但说句诚实的:到现在长期方案(单一发布者、互斥锁、冲突自动重试)状态仍是 proposed——重跑解的是这次的阻塞,不是下次的竞态。三个候选各有脾气:单一发布者最干净,但要动发布权限的边界,谁有资格发版是个组织问题不是技术问题;互斥锁要引入跨流水线共享状态,CI 系统里做分布式锁从来都不是免费的;冲突自动重试最轻,代价是版本号会跳——1.1.33 撞了就自动试 1.1.34,业务语义上无所谓,审计口径上得说清楚为什么缺号。知道的坑没修和不知道的坑,在排障手册里是两回事,至少这个写进去了——哪天真的又撞一次,接手的人不用从「registry 是不是抽风」重新推一遍。
三个坑的共性
回头看,这三个坑有个共性:故障都发生在边界假设上——「单例应该只建一次」「字符串应该不分大小写」「版本号应该没人跟我同时算」。每一个假设单独看都合理到不值一查,合起来就是一个月的排障日程。
OTA 表面是个简单协议,底下横跨数据库、二进制产物、CI 三个世界,每个世界都有自己坑人的方言:数据库那边,资源生命周期跟着访问模式走不跟着变量声明走;二进制那边,嵌进 APK 的东西不会因为 OTA 健康而自动变好;CI 那边,「读-改-写」三步曲在并发下天然不设防。
排查时把告警和后续成功请求串成一条设备时间线,比盯着告警本身有用得多——毕竟那个 emergency launch 的设备,其实是自己把自己救活的。告警告诉你「有人摔倒了」,时间线告诉你「他是被人推的还是自己绊的」。前者决定你多紧张,后者决定你修什么。一个月的学费换回来的就这句话:凡是「看起来不可能会错」的地方,都值得为它准备一条时间线。