排查会话问题,用户甩给我一个 PageSpy 导出链接——S3 签名 URL,X-Amz-Expires=300,五分钟后失效。先下载再说的本能救了我一命:这份「会话录像」一旦过期就是一阵烟,所有的分析都建立在先把物证搬进本地缓存上。这也直接写进了后来 ingest 工具的第一条契约:URL 是一次性消耗品,拿到手第一件事是物证保全,不是分析——先落盘、按内容 hash 建缓存,之后才轮得到理解数据。顺序反了,五分钟后你手里就只剩一个 403 和一段回忆。
文件落盘,0.66 MB,看着人畜无害。解压之后是 1.90 MB 的事件流——粗略换算约 50 万 token。直接喂给 LLM?一条 rrweb 的 FullSnapshot 就占 1.75 MB,相当于把整本书拍在桌上问「第几页有错字」。这份数据的正确形态不是「文档」,是一台被序列化倾倒出来的状态机——而状态机是不能用「读一遍」来理解的,得先归一化,再造查询。
事件流不是日志,是状态机的快照序列
先拆格式。每条事件形如 {type, data, timestamp},data 是 latin-1 bytes → zlib inflate → JSON 的三明治解码——压缩二进制被当成 latin-1 字符串嵌在 JSON 里,这是「JSON 不能裸装字节」的经典绕法,意味着解码链任何一步拿错编码,后面全是乱码惨案。59 秒窗口里 200 条事件,分三类:network 62 条 / 188 KB,storage 126 条 / 23 KB,rrweb 12 条 / 1.78 MB。
体积分布本身就是第一份诊断:92% 的字节是 rrweb DOM 快照,而绝大多数「这次会话卡在哪」的问题根本不需要 DOM。 用户抱怨的是请求慢、页面转圈——答案在 network 事件里,不在那 1.75 MB 的 FullSnapshot 里。第一条设计原则就此落地:rrweb 不进常规索引,按需加载或通过 DOM 查询间接暴露——把它放进索引,等于为了一成需求背九成成本。
第二个坑更隐蔽:那 62 条 network emission 不是 62 个请求。PageSpy 的 network 是「每个 readyState 变化吐一条状态快照」——一个请求从打开、发送、接收头、下载体到完成,要留下 4-5 条记录,每条都带着当时已知信息的截面。按条数算,这个会话发了 62 个请求,吓人;按 request id 合并后,实际只有 13 个逻辑请求。合并语义也有讲究:不是「取最后一条」,是把每条快照当成状态转移——status、duration、response 在生命周期里逐步填充,合并时要保留终态和「哪条快照带来了哪个字段」。任何「每个 tool 自己解码 network 字段」的设计都会在这里踩坑:两套工具对「有几个请求」给出两个答案,可观测系统的信誉当场破产。所以归一化必须在 ingest 层一次做完,所有下游消费同一份 SessionIndex。
storage 是第三种形态:126 条里一大半是 _dd_s 之类的高频 cookie 写入,同一个 key 几秒刷一次。原始回放需要它们还原状态,分析只需要「这个 key 最终被写成什么样、抖动频率多高」——折叠成「key → 写入次数 + 值序列摘要」,23 KB 变几行。
索引里到底存什么
SessionIndex 不是把 JSON 换个容器装,是三类实体各自的「分析友好形态」。network 按 request id 聚成一行:method、URL、终态 status、duration、起止时间戳、trace correlation 字段,外加指向原始 emission 的 locator——回答「哪些请求、各活成什么样」,同时保留「不信就自己去看原物证」的坐标。storage 按 key 折叠:写入次数、最终值摘要、写入频率——「这个 key 在抖」比「第 47 次写入的值是什么」更有诊断价值。rrweb 只留元数据:事件序号、时间戳、增量/全量类型——内容留在原文件里按需取,索引里只登记「哪一秒有快照可取」。
overview 则是索引之上再卷一层:时间跨度、各类型计数、错误与慢请求摘要、涉及的页面。它是刻意设计的小响应——Agent 首调拿地图,按图索骥再调细粒度工具,而不是一上来就把整卷胶片拖进上下文。
归一化之后,异常自己浮出来
索引建完,跑一遍异常规则,这个会话的故事自己就讲出来了——而且是那种人工翻原始事件几乎不可能发现的模式。
listSmsFollowUps 这条请求返回 503,耗时 5321 ms,响应头里 server-timing: total;dur=5001.7——服务端自己报时 5 秒整,典型的上游超时熔断。单看这条,结论是「后端有个 5 秒超时」。
但把 13 个合并后的请求按时间排开,故事升级了:正常轮询间隔稳定在 5.3 s 左右,而这条 503 耗时 5.3 s 之后,下一次请求是在它完成后约 5.08 s 发出的。也就是说前端不是「每 5 秒一次」的 setInterval,是「响应落地后再等 5 秒」的 setTimeout 链——慢响应会把整个轮询节奏往后推,502/503 高峰期请求频率自动降载。这个行为从单条请求的视角根本看不见,它只存在于「合并后的请求时间线」这个视图里。
顺手还能把前后端证据缝起来:请求带 traceparent,响应 expose x-request-id,拿着 correlation id 就能跳 Datadog 后端 trace——前端看到「5.3 s 后 503」,后端 trace 告诉你是哪个下游拖满了那 5 秒。一次分析,三层证据闭环。这里也有个脱敏分寸:trace id 本身算敏感运维数据,留在索引里要配 TTL 和手动清理,工具返回时是带 correlation hint 还是可点击链接,得看部署侧的权限模型——可观测性和数据主权是同一张桌子的两端。
这就是归一化的回报:人工在 200 条原始事件里翻,能发现「有个 503」;查询引擎在归一化索引上跑,能发现「为什么有 503、503 改变了什么、503 在服务端对应谁」。 一个是事件,一个是因果链。
值得把这条因果链再拆细一点看推理结构:503 本身只说明「服务端没办成」,server-timing 的 5001.7 ms 才暴露「是超时不是快失败」;而 5.08 s 的间隔规律把单点故障接回了前端逻辑——三个证据任何单看都只是线索,按时间线交织才构成解释。这正是「状态机视角」和「日志视角」的分水岭:日志里的每条记录是孤立的证词,状态机里的每条记录是系统彼时状态的一个截面——截面之间的差分,才是行为。
工具即预算:每个工具都必须自带护栏
接口形态我坚持「查询引擎式 MCP」,不是「读文件 MCP」。区别在哪:读文件是把决策成本和体积风险一起甩给调用方,查询引擎是把「什么可以进上下文」设计进工具契约里。
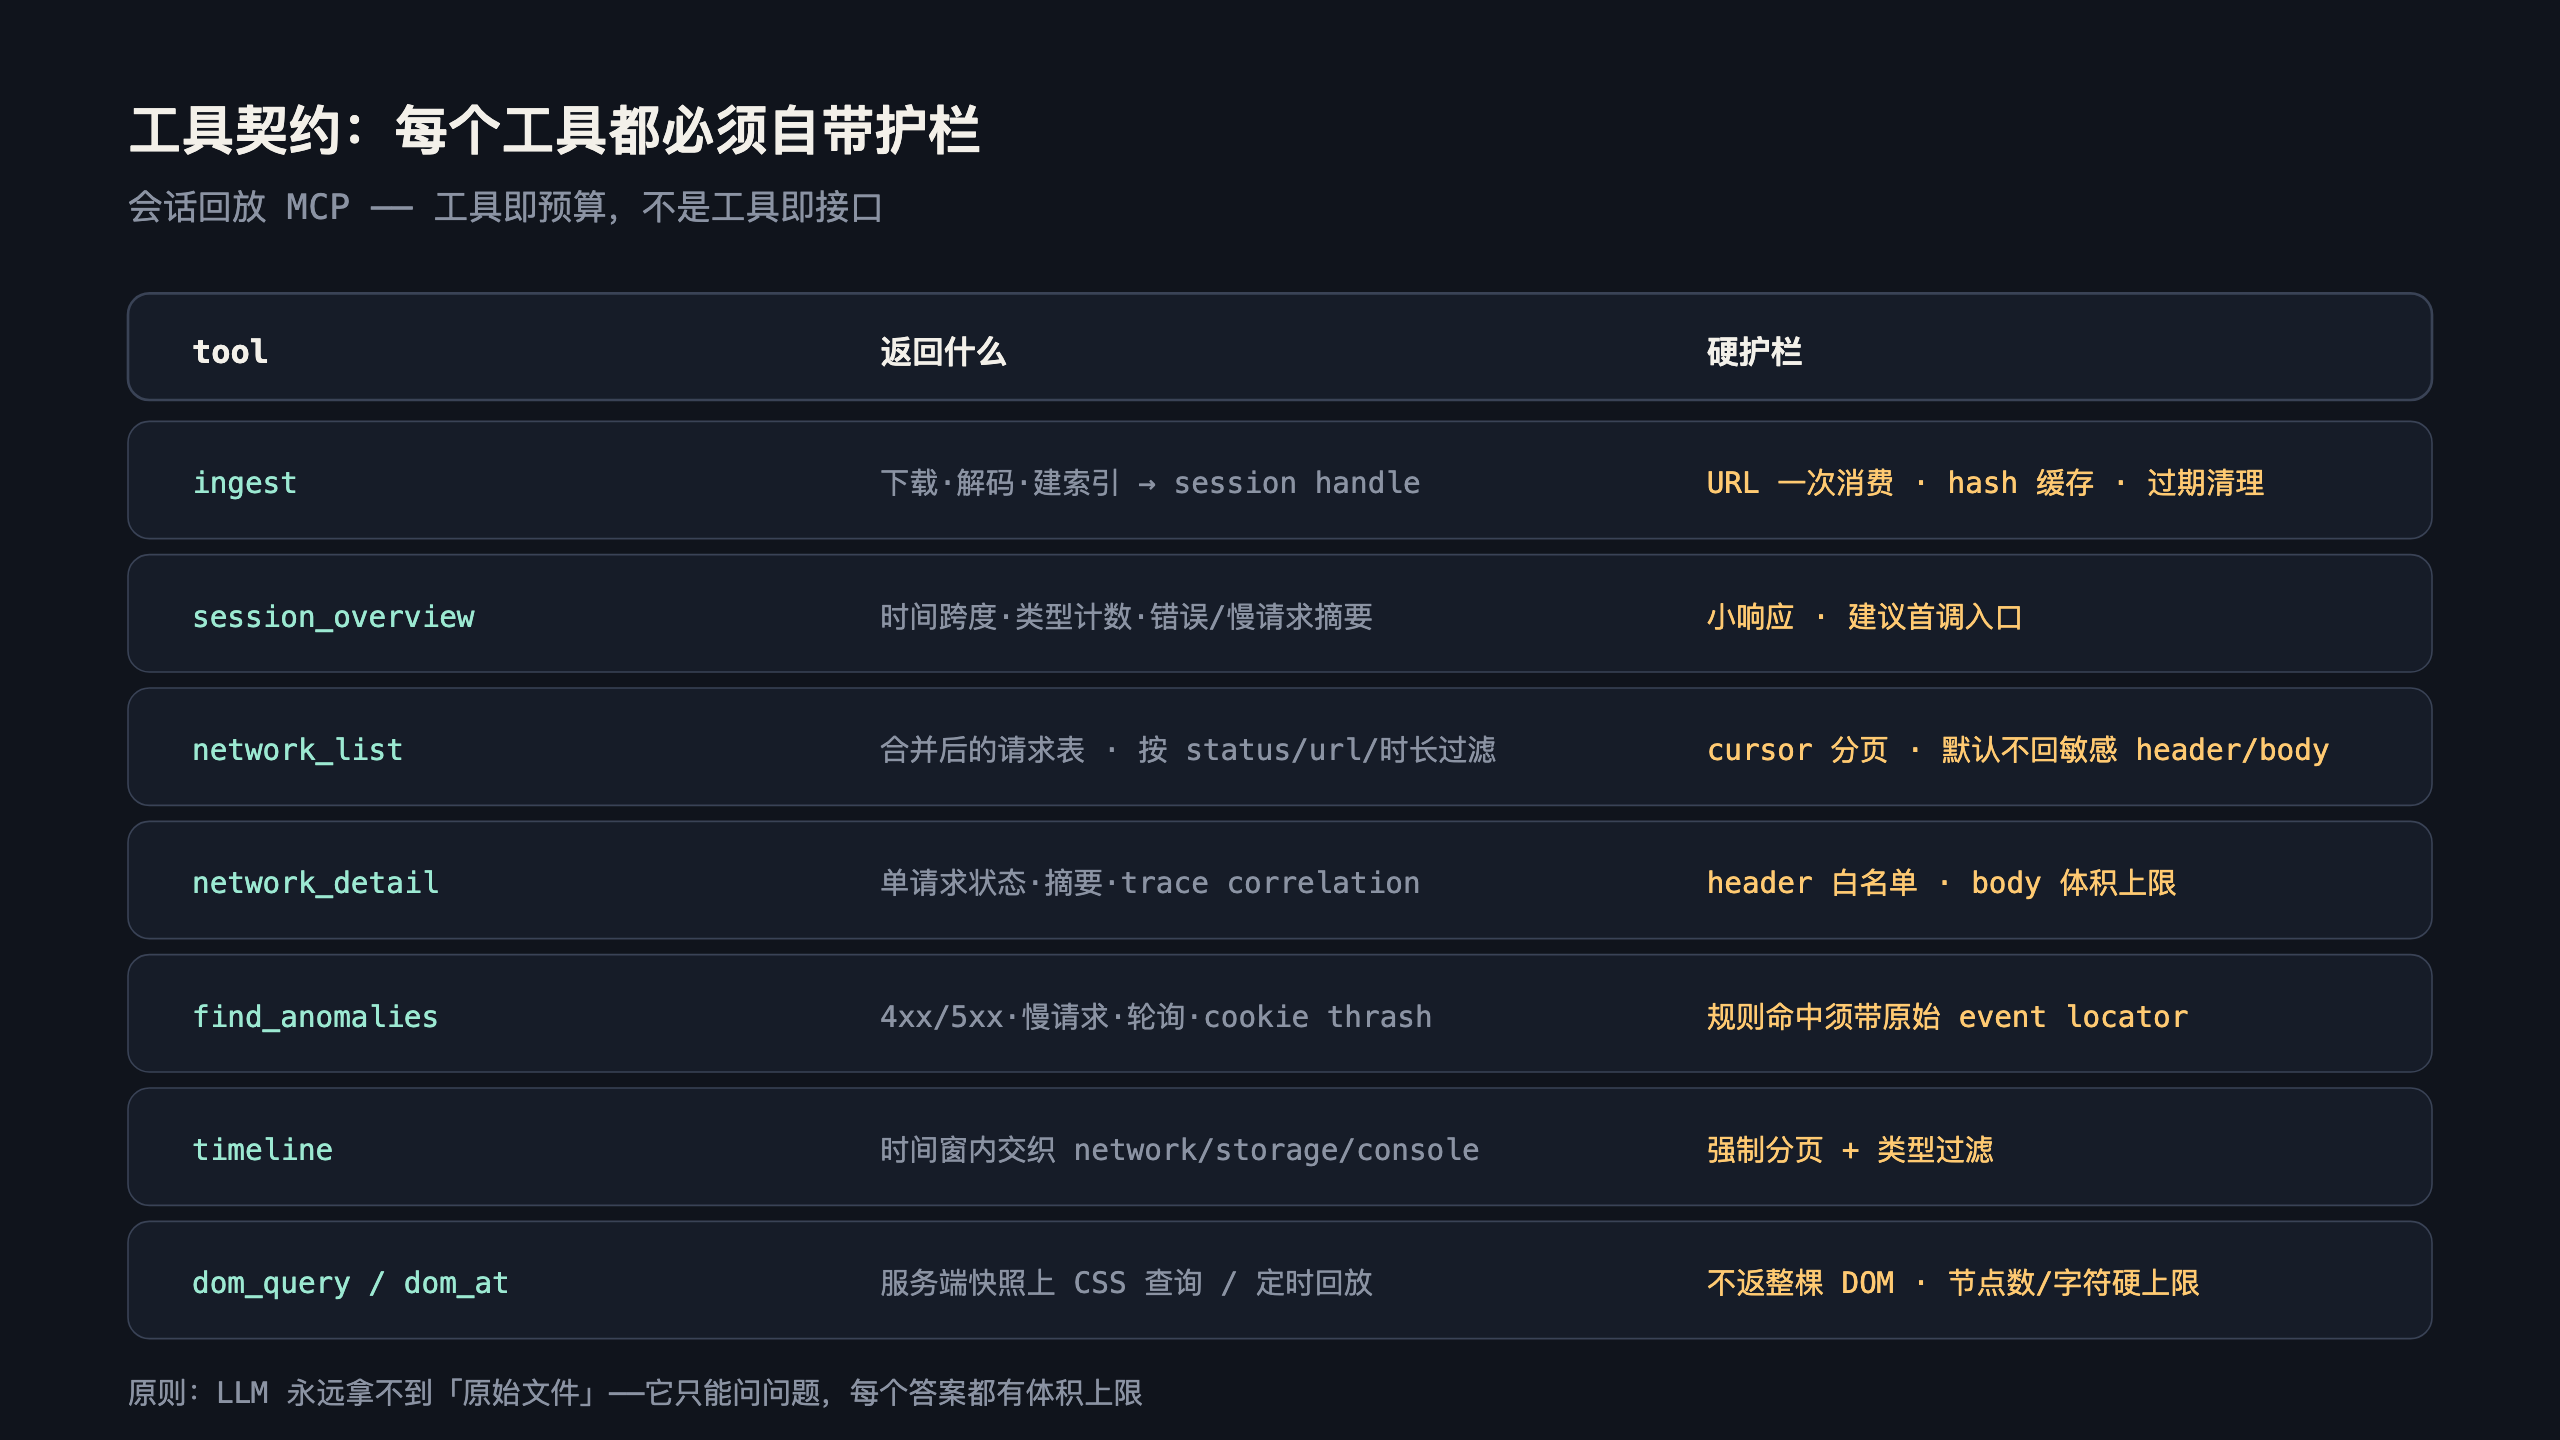
ingest 是唯一碰原始数据的人:下载、三明治解码、建索引,返回一个 session handle——签名 URL 一次性消费,索引按内容 hash 缓存在 ~/.cache/pagespy-mcp/,过期清理。session_overview 是小体积首调入口:时间跨度、类型计数、页面、错误/慢请求摘要,让 Agent 先拿到地图再决定往哪挖。network_list 给合并后的请求表,按 status/URL/时长过滤,cursor 分页,默认不回敏感 header 和 body。network_detail 才上细节,但 header 走白名单不走黑名单——cookie、tenant id、签名信息都在 header 里,黑名单是「忘了哪个会出事」,白名单是「只放行明确安全的」。find_anomalies 跑 4xx/5xx、慢请求、重复请求、轮询、cookie thrash 的规则集,每条命中必须带原始 event locator——规则结论没有指向源头的坐标就是孤证。dom_query/dom_at 放在服务端快照上查 selector 或定点回放,节点数和字符数硬上限,永远不返整棵 DOM。
每个工具的输出都有体积上限,每个敏感面都有默认关闭。LLM 永远拿不到「原始文件」这个选项——它只能问有边界的问题,拿有上限的答案。
这套契约背后的原则也适用于所有「给 LLM 接数据源」的活:工具的返回预算应该长在接口定义里,而不是寄托在调用方的克制上。 一个「返回全部匹配」的 API 是在赌每个调用者都记得分页;一个「返回文件路径」的工具是在赌模型不会顺手 cat 整个文件。赌输的代价不是报错,是上下文静默爆炸——Agent 的 scratchpad 被 50 万 token 的胶片灌满后,后面每一轮调用都要替这张胶片再买一次门票。所以白名单、硬上限、强制分页、locator 回指,这些不是「安全加分项」,是工具能不能被 Agent 长期持有的及格线。
摆在桌上的替代方案和否决理由
原始文件直接丢给 LLM——约 50 万 token,rrweb 单快照即可撑爆,否决在第一行。每个工具自己解码和理解状态——实现重复,且 network 快照必然被误算成多个请求,否决。缓存原始文件——敏感 payload 全量留盘,每次查询还要重解码,否决,倾向缓存归一化索引。第一期就完整重建 DOM 回放——复杂度和大多数 network 诊断无关,延后。
未知事件类型保留有界 raw summary、不让整个 ingest 失败——样本里只有 storage/network/rrweb 三类,console、system、page、database 没有真实 fixture,「没见过的类型不让管线崩」是前向兼容的保险丝,不是可选项。
验证过和没验证的边界
诚实的边界:这是一个样本验证过的方案,不是上线的系统。数据格式、合并规则、异常发现都在真实样本上跑通,MCP server 本身没在那个会话里实现。单样本本身就是风险项:readyState 快照的字段分布、storage 的写入模式、rrweb 的快照节奏,我都只见过一个会话的样本——合并规则和折叠策略按「语义」设计而不是按「这份样本长什么样」设计,正是为了扛住第二份数据长得不一样的那天。样本之外:console/system/page/database 四类事件没有 fixture,只能验证「未知类型降级」语义,不能声称完整支持;归一化索引的 TTL、磁盘配额、手动删除接口没定;Datadog 联动该返回可点击查询、trace id 还是脱敏 hint,取决于权限模型,没拍板。
更大的悬而未决:PageSpy 后来要迁 OpenReplay,这套 SessionIndex + 工具契约是随之作废,还是移植到 OpenReplay 的 export/API 上——方案设计时被刻意做成「采集层可换、索引层可搬」的两层,就是给这种迁移留的命。
收个尾
会话回放、rrweb 快照、事件流——这类数据的共同陷阱是「长得像文档,其实是状态机」。文档可以读,状态机只能查。把 50 万 token 的原始倾倒物变成三个有界答案,靠的不是更大的上下文窗口,是 ingest 时一次性付清的归一化成本——合并按 id 归位、折叠按 key 去抖、大对象按引用登记,付完这笔一次性的账,后面每个问题才是便宜的有界查询。
下次再有人甩给你一个「就 0.66 MB 的小文件」,先解压看看——体积是会骗人的,状态机不会。而那条五分钟后就失效的签名 URL 会教你另一件事:物证保全永远先于分析,顺序不能反。