去年我给一个内部知识平台做数据源同步——把 Slack、飞书、Intercom 里的内容搬进统一检索,供内部问答产品用。刚开始我以为同步是个单纯的 IO 问题:webhook 收到事件,写库,完事。这个天真的版本大概活了两周。做完才发现这根本是一场严酷的一致性工程:上游会变、传输会断、调度会疯、连「删除」这个词背后都藏着三种截然不同的含义。而我交的学费分三期,一期比一期贵——第一期教我传输不等于持久化,第二期教我调度器也会杀人,第三期教我连「删除」都得先问清楚是哪一种。
第一期:实时事件管延迟,管不了正确性
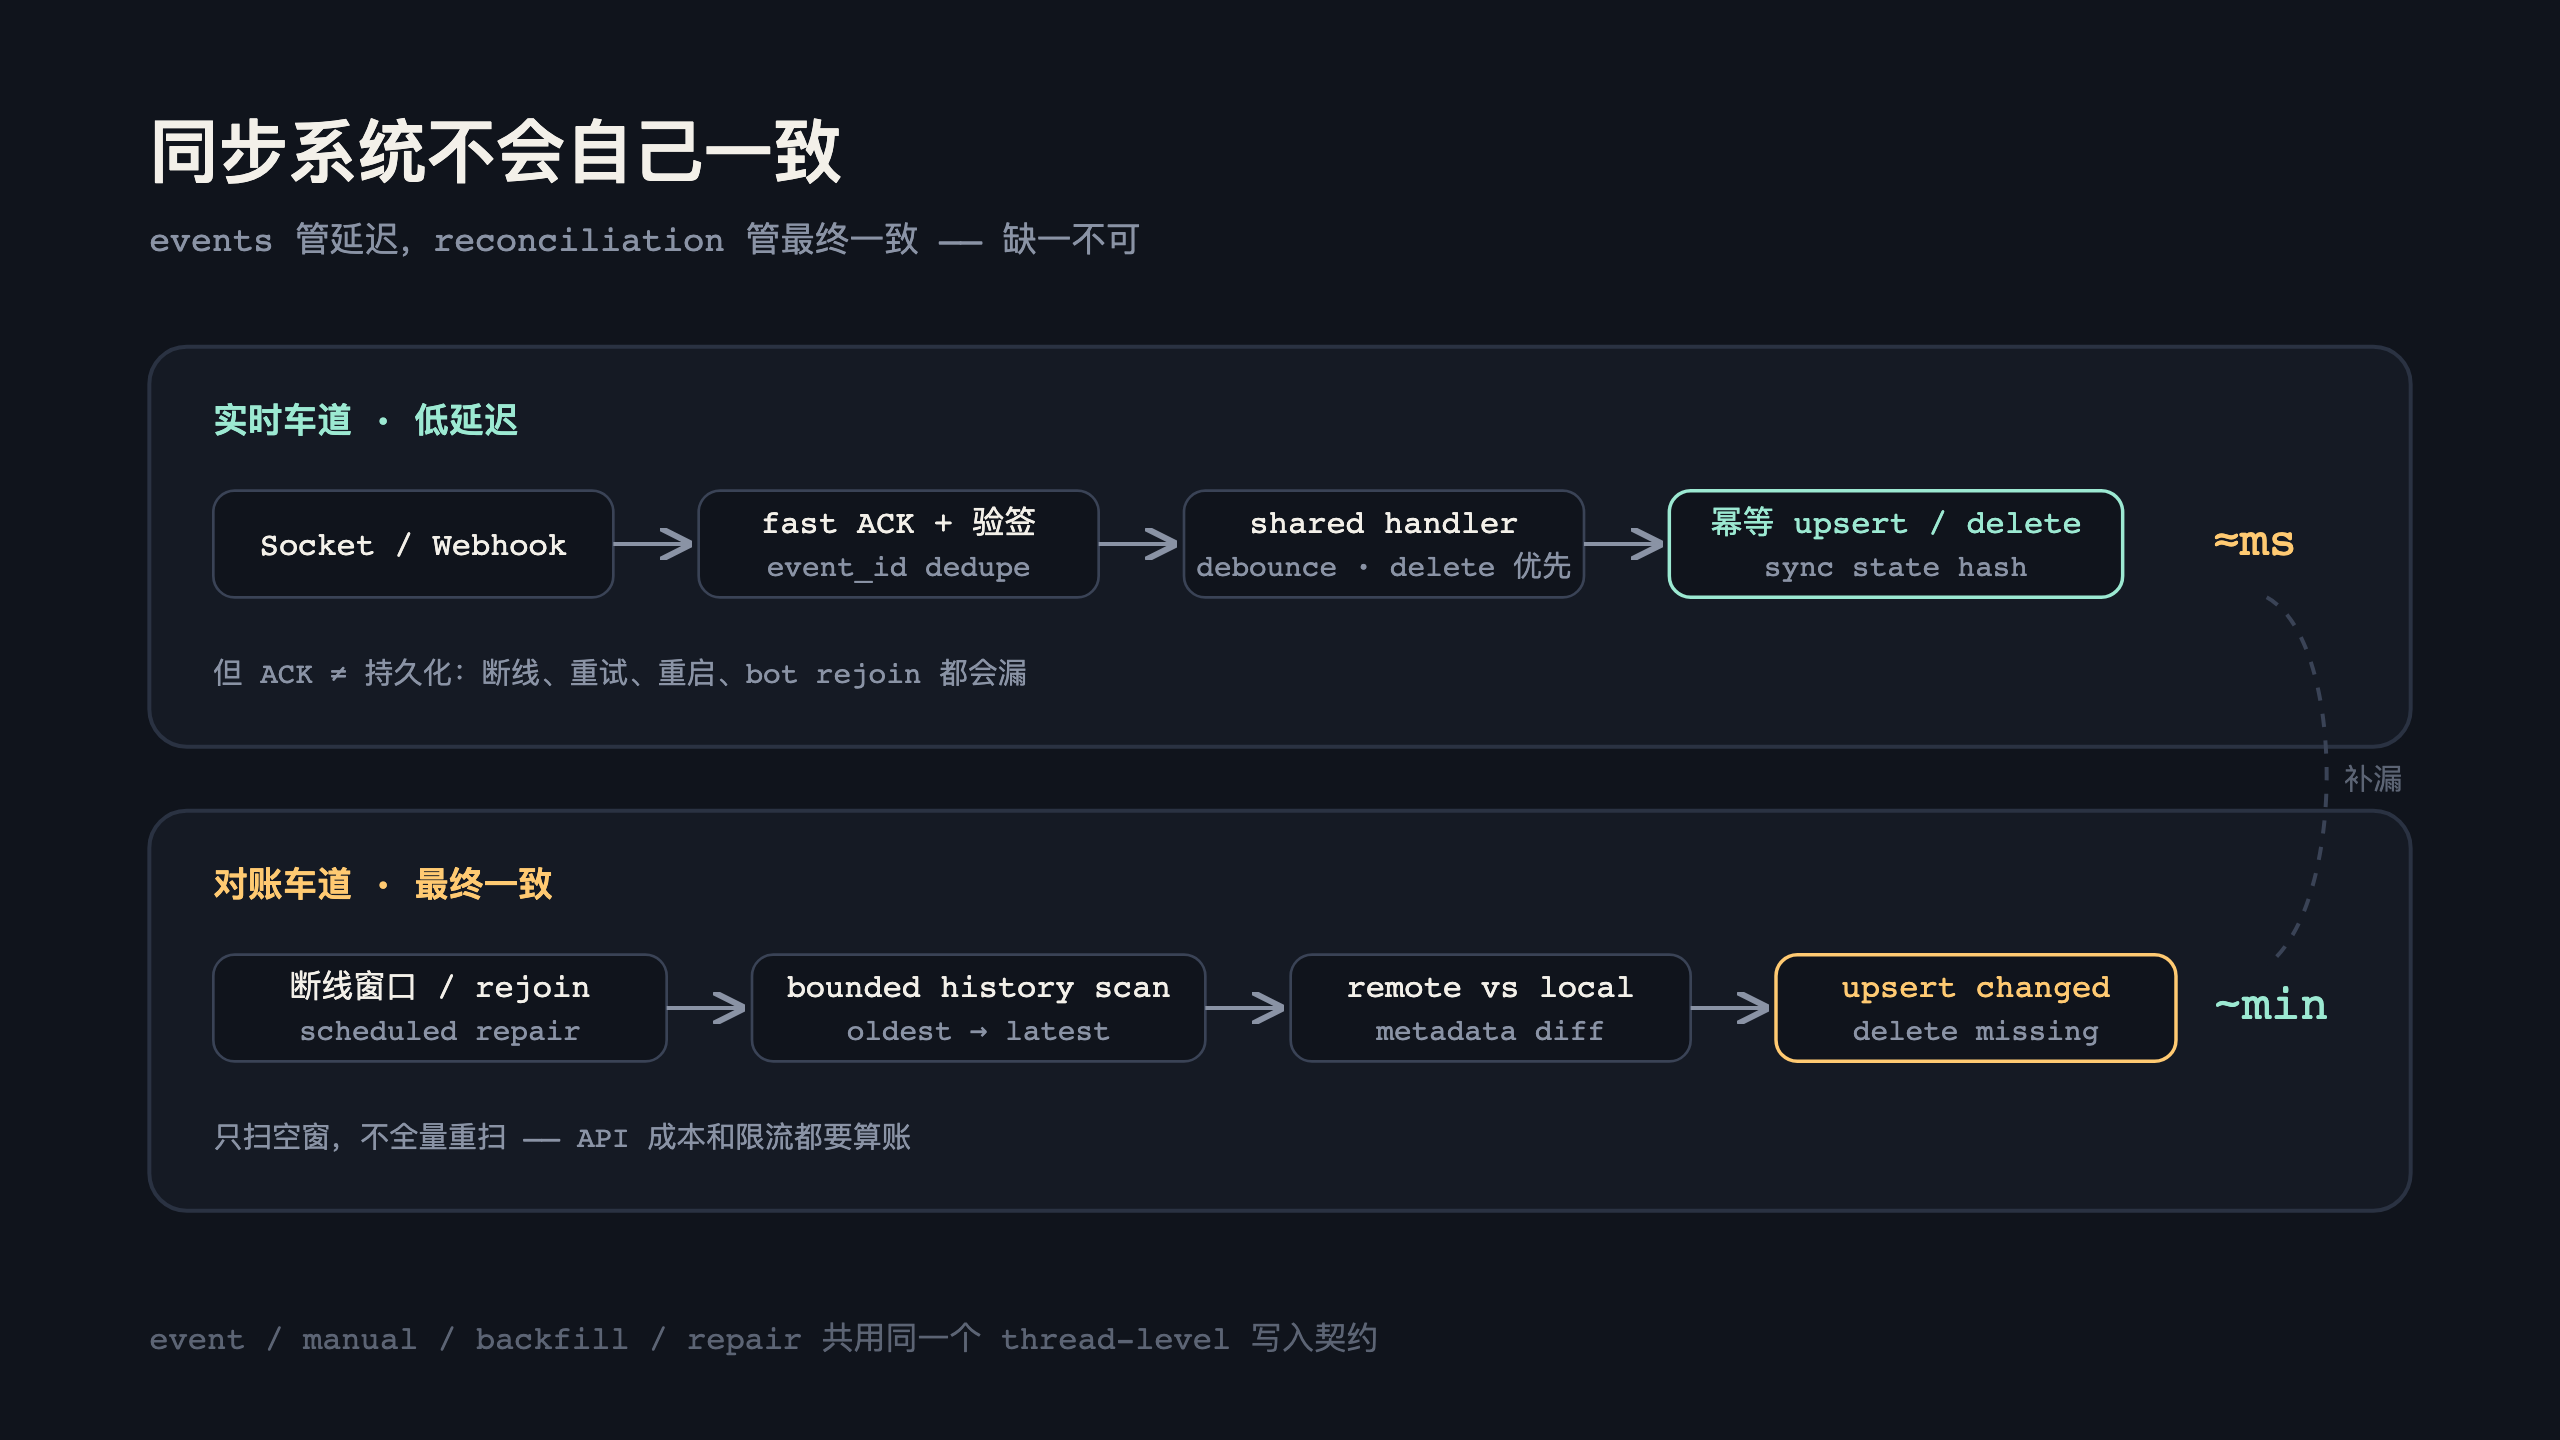
Slack 接入有两条路:Socket Mode 和带签名的 HTTP Webhook。一个走长连接,一个走回调,性格完全不同——Socket 要维护连接健康、会断线重连;Webhook 会被 Slack 主动重试、会乱序、还要过验签和 challenge 握手。我做的第一个正确决定是让它们共用同一个事件处理器:transport 层只负责快速 ACK、验签、challenge 和 event_id 去重,再把 transport 健康和 channel 订阅状态暴露给 registry 巡检;业务层的 thread debounce、删除优先、幂等 upsert/delete 只有一份。handler 输出统一的 SourceRuntimeRequest,往下的写入路径完全不关心这条消息是从哪条 transport 爬上来的。
为什么强调「只有一份」?因为两条 transport 各写一套同步逻辑,去重和删除的语义迟早漂移成两个物种,到时候你修 bug 都得双修——Socket 那边删除算 tombstone,Webhook 那边删除算「哦那跳过吧」,同一个频道能给你演出两种平行宇宙。共享 handler 还有个额外好处:manual retry、backfill、scheduled repair 全都收敛到同一个 thread-level runner 和同一份状态 hash 上——admin 在后台手动重试一条 thread,走的和实时事件是同一条幂等写入路径,不存在「手动操作有隐藏通道」这种幺蛾子。
handler 里有个容易漏掉的排序规则:删除优先于同 thread 的待处理 upsert。理由很具体:消息先进 debounce 队列,等待期间用户把整条 thread 删了——如果 upsert 先结算,debounce 结束后会把一具尸体重新写回检索库。删除事件不是「又一条普通事件」,它是给前面排队的所有人发的死刑判决书。
但就算事件链路做到完美,ACK 也只证明「我收到了」,不证明「我存下了」。断线重连的空窗、bot 被移出又拉回频道、服务自己重启——每一个都会留下窟窿,而这些窟窿有个共同特点:没有任何人会来告诉你它们存在。Socket Mode 不会发一条「对不起我刚才断了几分钟,错过了这些消息」的道歉信。
所以第二条车道是 reconciliation:断线边界、bot rejoin、定期修复都触发一次带 oldest/latest 的有界 conversations.history 扫描,拿远端 metadata 和本地 state 做 diff,变更的 upsert、缺失的 delete。关键是「有界」——断线空窗被显式记录下来,恢复时只扫那段时间。为什么不每次重连全量重扫?因为大 channel 的历史是分页的,全量翻一遍等于每次网络抖动都给 Slack API 交一份限流税,税交多了,429 先来给你收尸。当然,有界的代价是窗口边界必须可靠记录——disconnect 时间戳记错了,漏掉的消息就永远漏掉,这个 trade-off 是明牌。
一句话:event stream 优化延迟,reconciliation 保证最终一致,谁也别想替代谁。这部分写了 78 个测试文件 558 条用例,pnpm check 全绿,生产只读 smoke 也证明了 bot token 能调带边界的 conversations.history 且没有 429。但按惯例泼冷水:本地没有真实的 App Token/Signing Secret,十分钟测试窗口里也没有真实消息流过——也就是说真实事件链路的 E2E,当时是欠着的。单测全绿证明「逻辑对」,不证明「链路通」,这个边界我心里有数,也写进了交付说明里。
第二期:调度器把自己打成了重启风暴
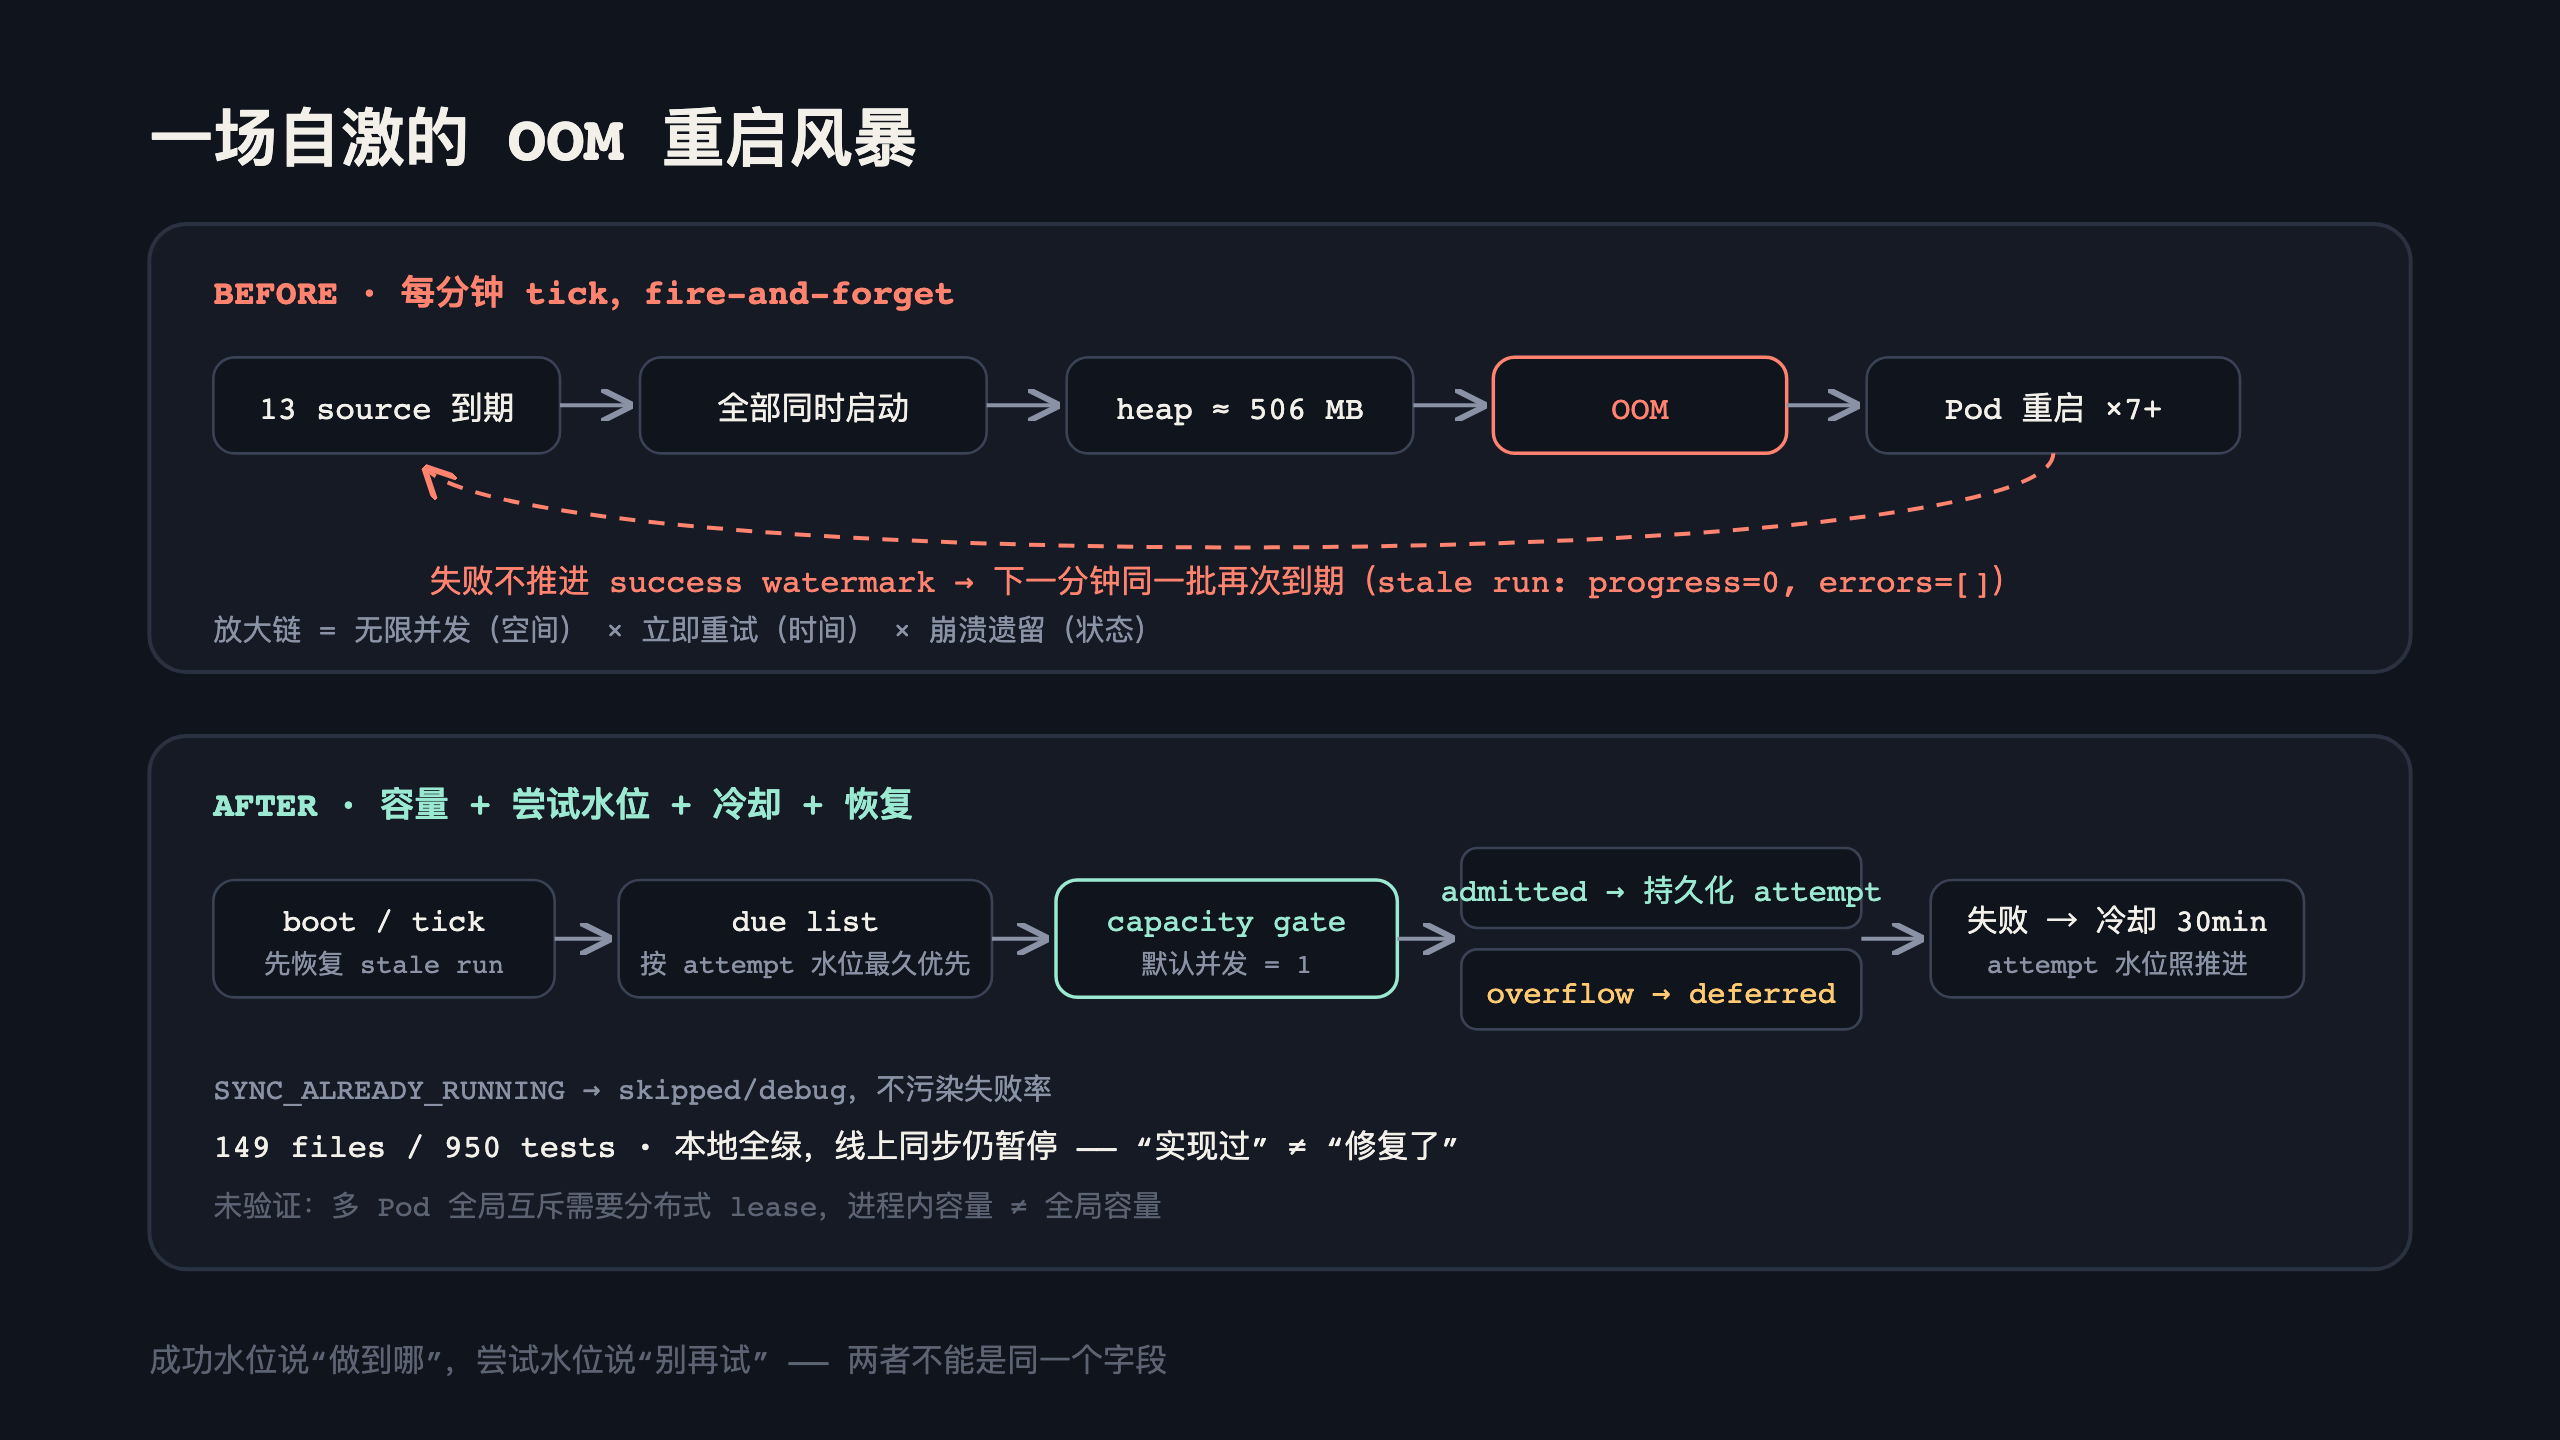
另一条线是定时同步。scheduler 每分钟 tick,判断「到期」只看 last_reconciled_at——一个成功水位。问题就出在这:失败的 source 不推进成功水位,于是下一分钟它又到期;而启动方式是 fire-and-forget,所有到期 source 一起上,没有任何容量概念。
线上实况是:13 个 source 在几秒内并发启动,单 Pod Node heap 冲到约 506MB,OOM,重启。重启时 stale recovery 倒是尽职尽责地把遗留 run 标成失败——但 source 的到期判定没变,下一分钟同一批再次点火。至少 7 次重启,一场完美的自激风暴。这个系统最讽刺的地方在于:每个组件都在做「正确的事」——recovery 正确地标记了中断的 run,scheduler 正确地发现它们到期,然后它们合力把 Pod 反复打死。
页面上那些 progress=0、errors 为空的 run 看着像 connector 集体摆烂,其实只是进程被杀后留下的尸检报告。这是同步系统特有的陷阱:崩溃产物和业务失败长得一模一样。不看 heap 日志和重启计数,你会以为 13 个 connector 同时得了同一种怪病。
还原一下自激的完整链条,值得逐环看:失败 → 成功水位不动 → 下一分钟到期 → fire-and-forget 全量并发 → heap 打满 OOM → Pod 重启 → stale recovery 把 run 标失败 → 水位还是没动 → 再下一分钟同一批再点火。这个环里没有任何一环是「bug」——到期判定按规则办事,recovery 按规则办事,点火也按规则办事。风暴不是某个组件坏了,是几条各自正确的规则咬合出了一台自驱动的爆炸装置。这也是为什么修它不能只挑一个环节:堵任意一个环,其他环照样能绕出新的放大路径。
修这个不能加内存——加内存只是让爆炸场面更壮观,506MB 的风暴换成 1GB 的风暴而已。也不能让失败推进 last_reconciled_at,那是把失败伪装成成功,水位的语义当场作废。修复是四件套,每一件对应一种放大机制:
容量默认 1,超额记 deferred 而非 error——管空间放大,同时不能让「排队等位」污染失败率;last_scheduled_sync_at 尝试水位持久化,失败也推进,外加 30 分钟冷却——管时间放大,而且要持久化,进程内 cooldown 在 Pod 重启那一刻就随风而逝,风暴会原样复活;候选按最久未尝试排序——管公平,不然固定顺序下排最前面的失败源会长期占着唯一的槽位,后面的健康源活活饿死;服务启动先恢复 stale run 再开调度,SYNC_ALREADY_RUNNING 记 skipped 而不是 error——管时序,不然重启后遗留 run 和新 run 交叠,正常的并发竞争也不该假装成故障。
顺带把调度指标也重新立了户口:triggered、deferred、skipped、failed、recovery 各自独立计数。这件事看起来是顺手,实际上是给下一次排查买保险——deferred 堆高说明容量该调了,recovery 堆高说明进程在反复死,混在一起的全是糊涂账。
149 个测试文件 950 条用例全绿。但按惯例要泼冷水:代码当时没部署,线上同步在用户授权下还停在暂停状态,多 Pod 下「全局容量 1」需要分布式 lease 证明——implemented locally 不等于 fixed。还要再泼一盆:默认并发 1 和 30 分钟冷却是拍脑袋的保守值,调优要靠吞吐和恢复时间指标,不是靠信仰;跨 source 限流也管不了单个巨型 source 自己吃爆内存——那是单任务预算和流式处理的课题,别指望容量阀门顺便解决。成功水位回答「做到哪了」,尝试水位回答「什么时候才准再试」,把这两件事塞进同一个字段,风暴就是学费。
第三期:你说的「删除」,是哪一种删除
最后是个语义坑,也是我最喜欢的一个,因为它暴露了同步系统最深的问题:同一份数据活在四个世界里,而每个世界对「状态」的定义都不一样。
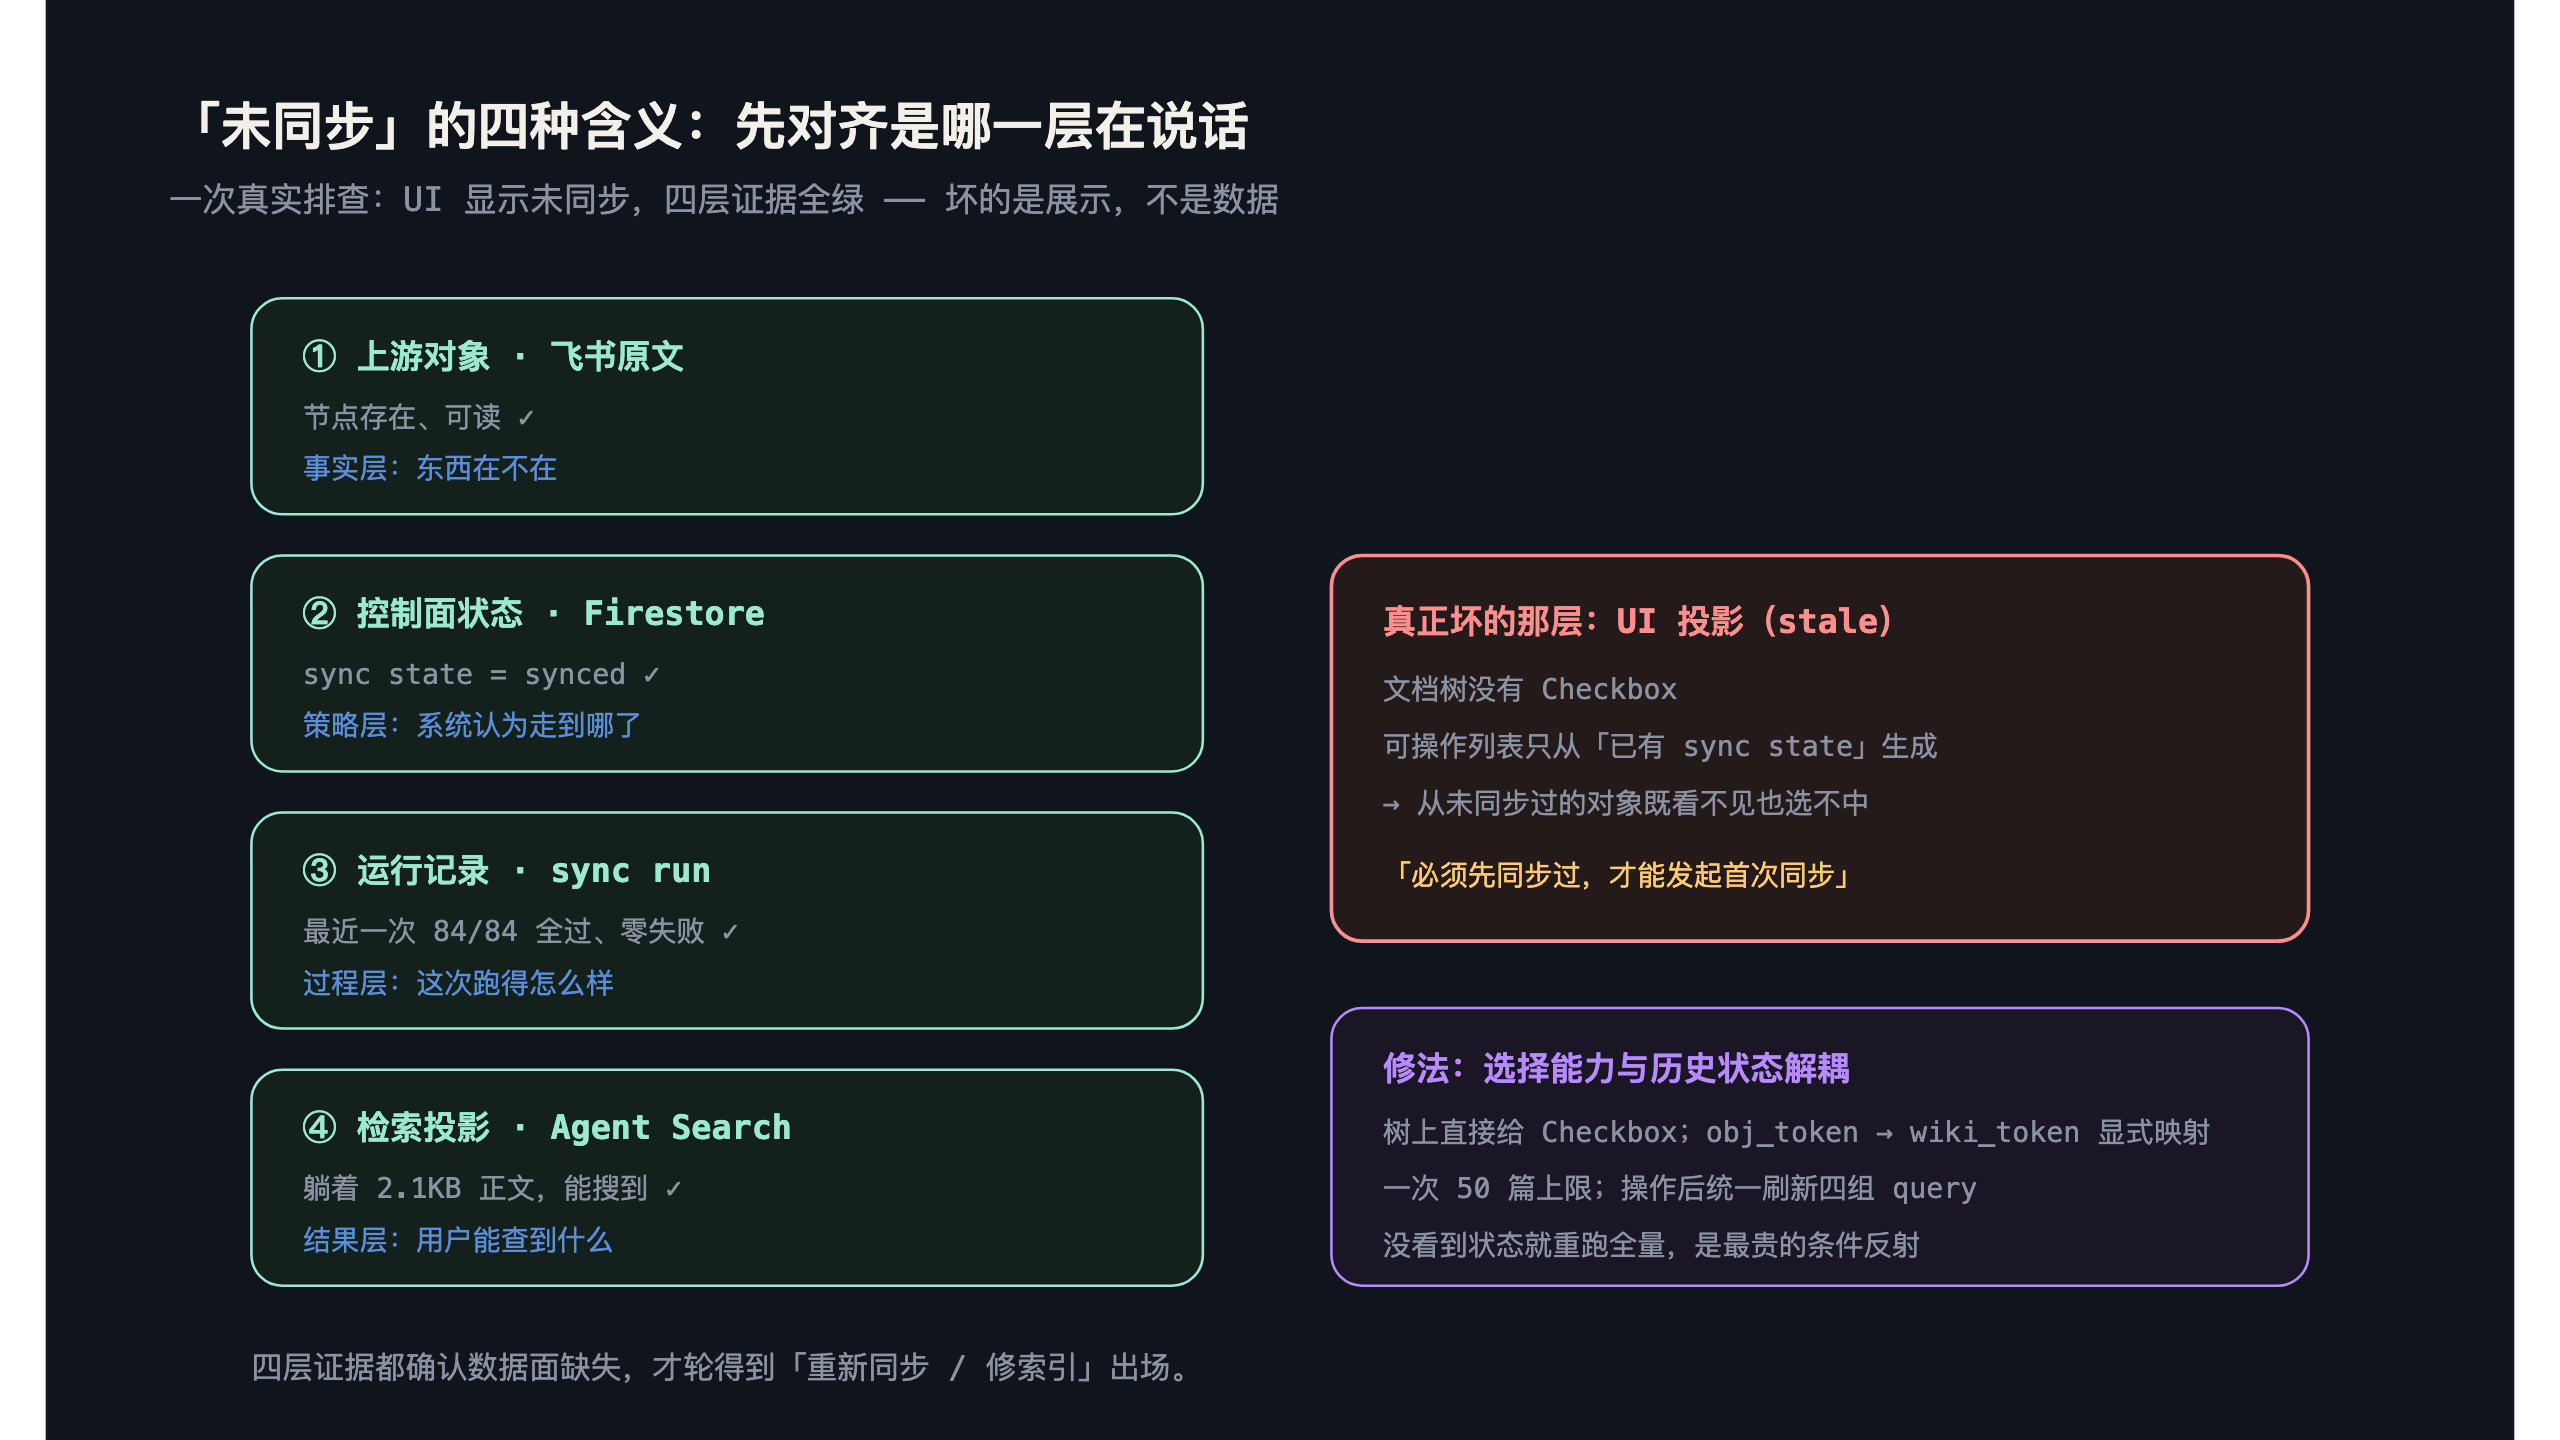
排查「漏同步」时我学到的模型是把四层分开:上游对象、同步策略(exclude)、控制面状态、检索投影。一次真实排查里 UI 显示某飞书节点「未同步」,沿四层一查:上游对象在、Firestore 状态 synced、最近一次 run 84/84 全过、检索库里躺着 2.1KB 正文——是 UI stale,不是数据丢了。四层证据都在,唯独展示层活在过去。没看到状态就重跑全量,是这个系统里最贵的条件反射——重跑不解决 UI stale,还顺手给 API 限流交税。
这个 bug 还有个更精彩的结构成因:文档树没有 Checkbox,可操作列表又是从「已有 sync state」生成的——于是从未同步过的对象既看不见也选不中。「必须先同步过才能发起首次同步」,一个教科书级的循环依赖,藏身在一个看起来只是「UI 少了个勾」的地方。这种 bug 最气人的是每一层单独 review 都觉得没问题:树负责展示、列表负责操作、state 负责记录,各管各的,合起来恰好把「第一次」这个最重要的时刻漏掉了。修法是把「对象可被选择」从历史状态里解耦:树上直接给 Checkbox,obj_token 显式映射成同步 API 要的 wiki_token,一次最多 50 篇,操作完统一刷新树、状态、run、检索四组 query——缓存视图们得一起收敛,不能你刷新了你的、我 stale 着我的。
删除也分三种:上游原文删除、exclude(只管未来同步,不追溯)、手动删检索投影(写 deleted 状态)。三种删除的生命周期完全不同:exclude 表达的是策略——「以后别碰它」,对已经索引的历史一毫米都不动;手动删除表达的是处置——「现在这个投影给我撤了」,飞书原文一个字节都不能碰;上游删除才是事实本身——原文没了,同步时按缺席处理。把这三个动作当成同一件事,就会出现「运营 exclude 了但老内容还能搜到」的灵异工单。
最阴的是幽灵记录:删了投影但没 exclude,下一轮同步按内容 hash 判断「没变过」直接 skip——控制面写着 synced,检索面查无此物,一条「状态在、投影没了」的幽灵就此诞生。所以 deleted 且未 exclude 的对象必须打破 hash skip 强制 reindex。这里的世界观也得立住:投影是可重建的,它从来都不是原始事实——删投影不等于销毁证据,UI 上必须明说「下次同步可能恢复」,想永久排除请走 exclude。批量删除也定了规矩:校验 source ownership 和编辑权限、一次 50 项上限、逐项记录成败——「部分失败」必须是一等公民,一个统一 200 盖住的批量操作,事后对账全是眼泪。这条路走完过了 1197 个测试,改动精确隔离在 9 个文件里单独提交——批量删除这种高权限功能,提交粒度本身就是审计的一部分。
还有一个容易想当然的边界:exclude 是「未来策略」不是「追溯删除」。运营在后台给一个老节点勾了 exclude,发现它还能被搜到,工单就来了——「你们删不掉」。事实上 exclude 从实现层面就只拦 discovery/sync 的入口,对已经写进检索库的历史投影一毫米都不动。「停止以后同步」和「删除已经索引的内容」是两个动作,产品语义上不拆开,工单就会一直来。
回头看,同步系统的正确性不在「事件到达率」,在「状态可解释性」:每一条 run、每一个水位、每一种删除,都得能回答「你现在处于哪个世界」。事件说「我到了」,水位说「我走到哪了」,投影说「检索里长什么样」,控制面说「我认为现在是什么状态」——四句话经常各说各的,排查就是逼它们对质。一致不是默认值,是一层一层对出来的。一个同步系统最让人放心的时刻,不是所有灯都绿,而是每一盏灯你都知道它量的是哪个世界。