去年我给内部 RAG 服务做 CodeGraph 远程索引——简单说就是把几百个仓库的代码结构离线解析成图,让影响分析、调用链查询这类功能不用现场翻源码。架构上它不是一个独立微服务,而是主服务里的一块共享 runtime:轻量查询在主进程借用只读的 active generation,重型索引扔到子进程里跑,正式索引先在 inactive generation 上构建、校验通过后原子切换。这套设计听起来四平八稳,直到我第一次跑全量同步。
当时的场面堪称行为艺术。同事说「首次同步一直失败」,我打开日志一看,确实一直失败——但每次失败的地方都不一样。我连着修了四个根因,每修好一个就冒出下一个,像打地鼠。只不过这些地鼠分布在 Git、子进程、图存储和数据库四个完全不同的洞里,共用的只是一句模糊的「同步失败」。
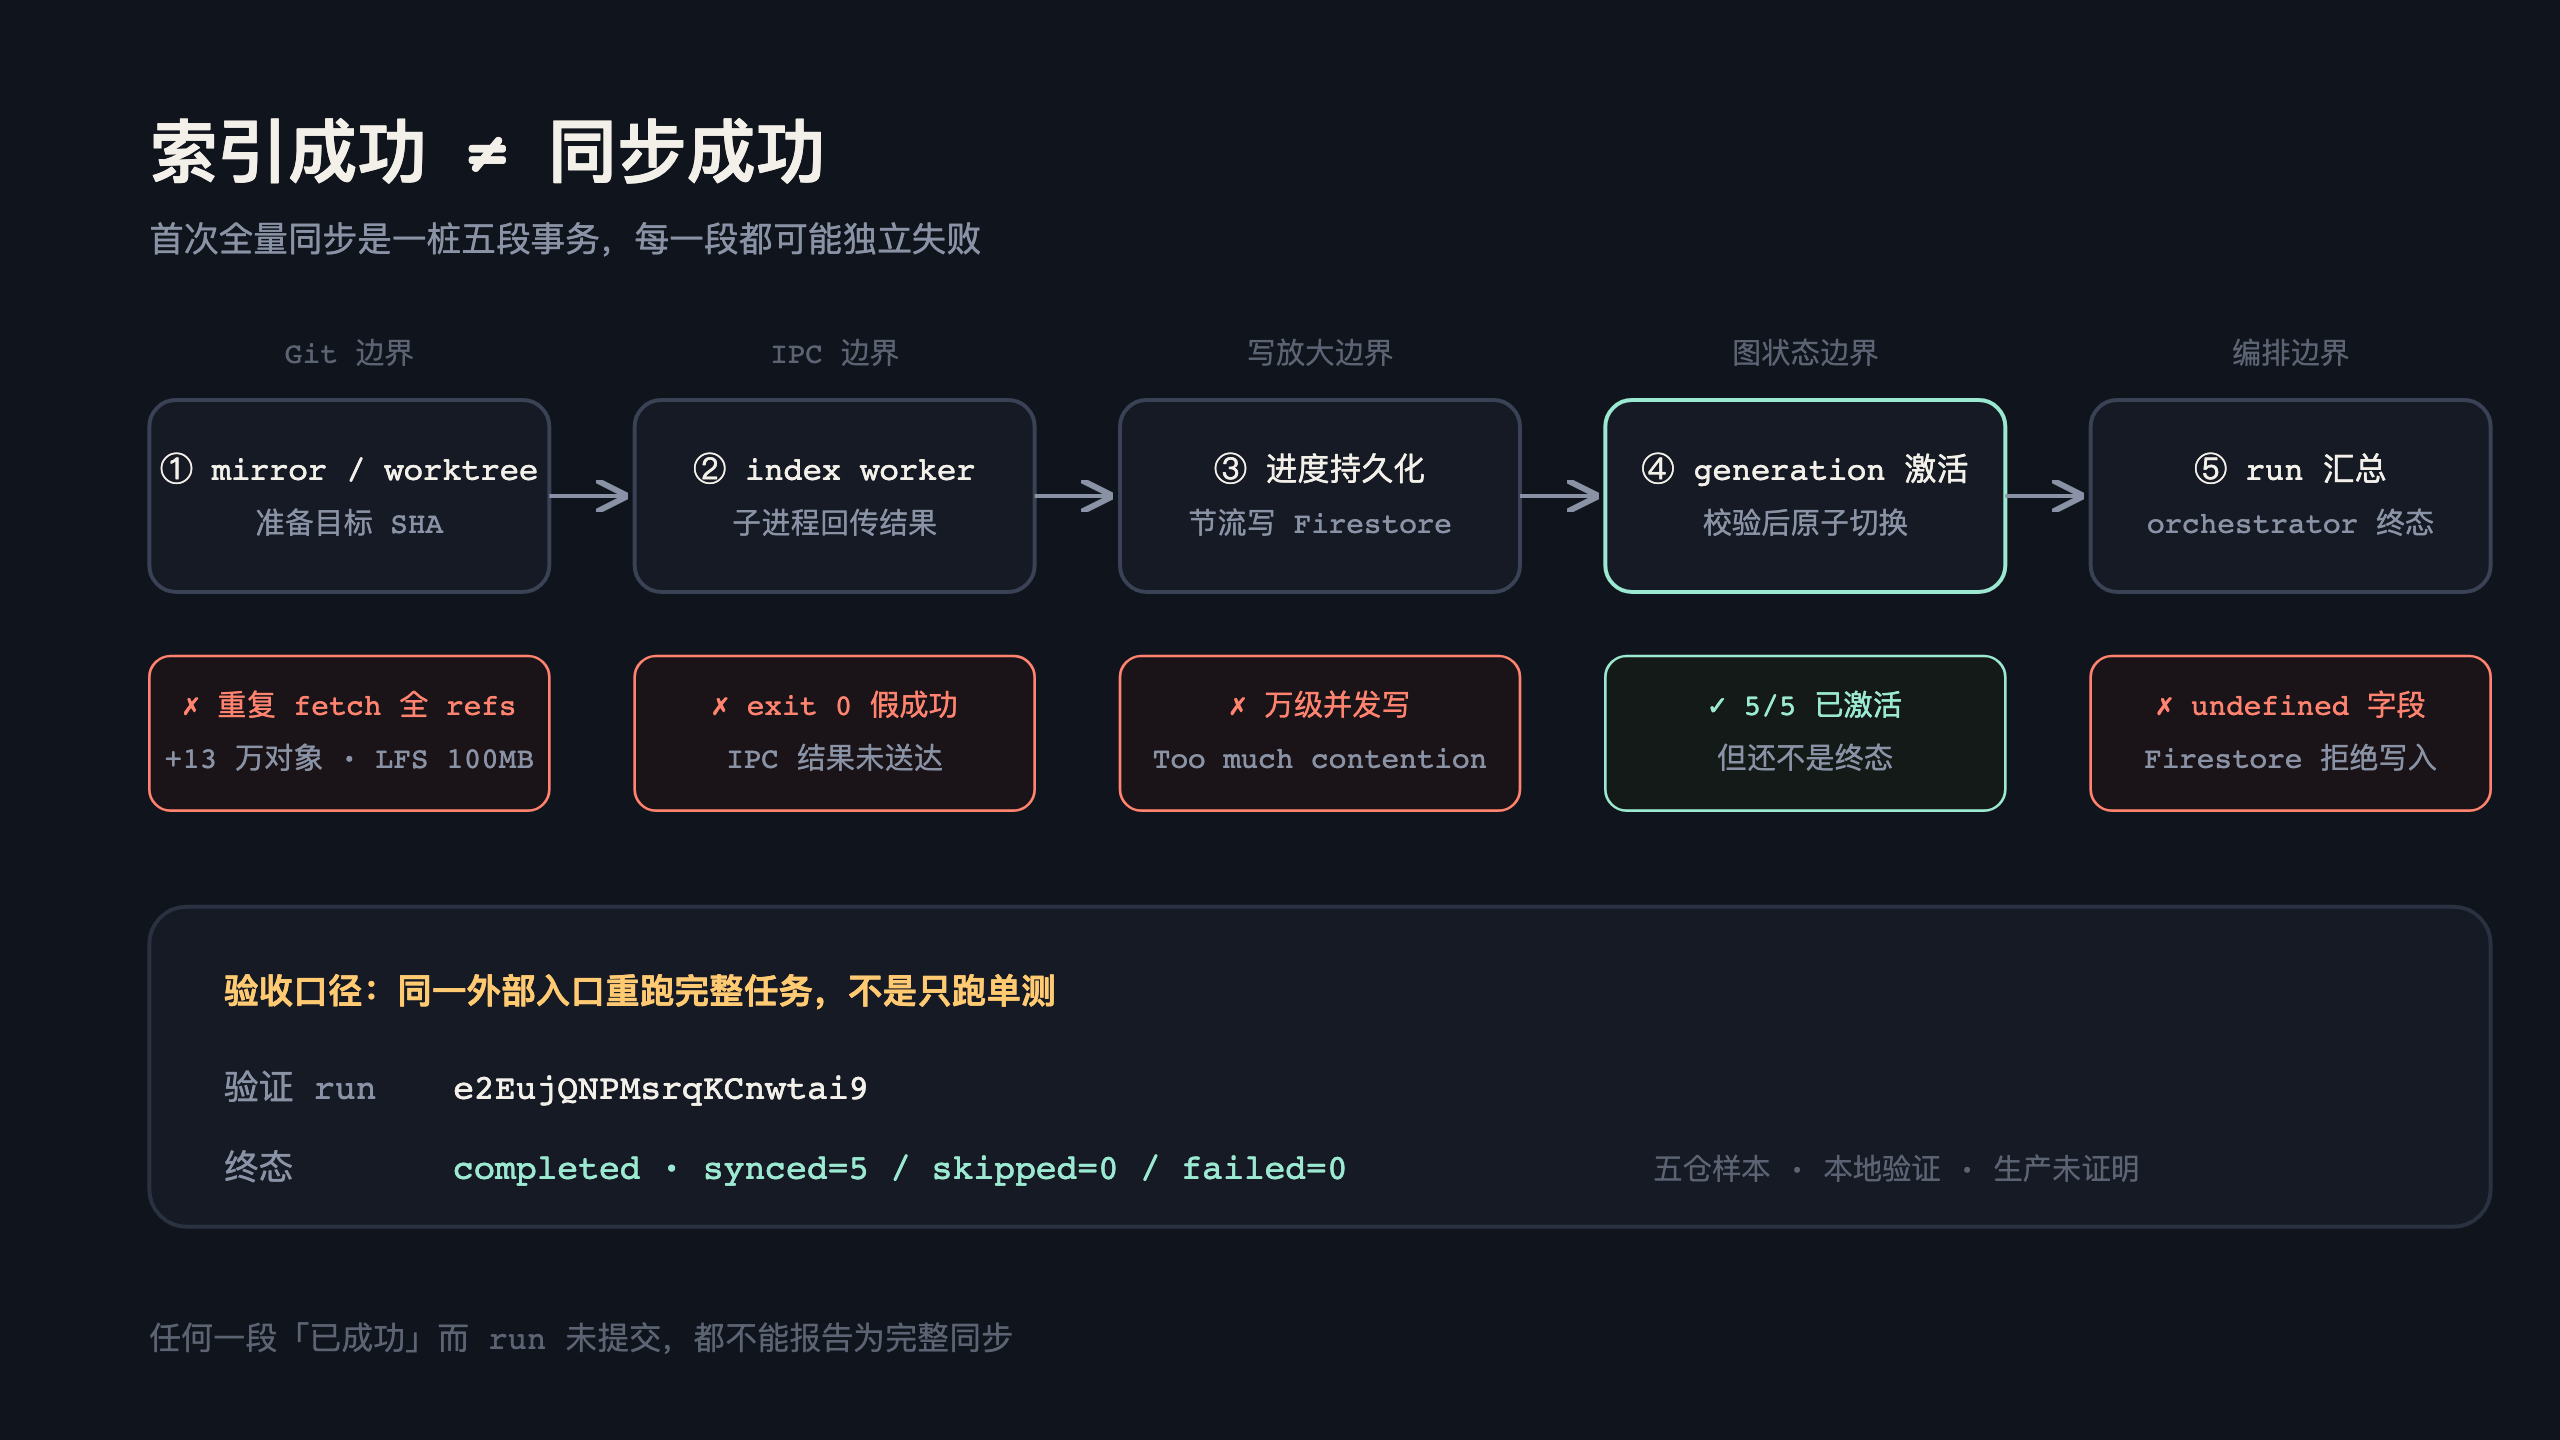
复现方式很朴素:起本地开发服务,通过管理 API 对五个真实仓库强制触发同步,然后盯着真实日志一段一段修。为什么非要真实仓库?因为首次同步是整条链路压力最大的一次——之前没有任何状态可以依赖,所有边界都要完整走一遍,小型 fixture 根本压不出这些问题。这里先立个规矩,后面会反复用到:首次同步不是一次调用,是一桩跨越五个边界的事务。任何一段「已成功」但任务没拿到终态,都不算完。
第一只地鼠:exit 0 的伪成功
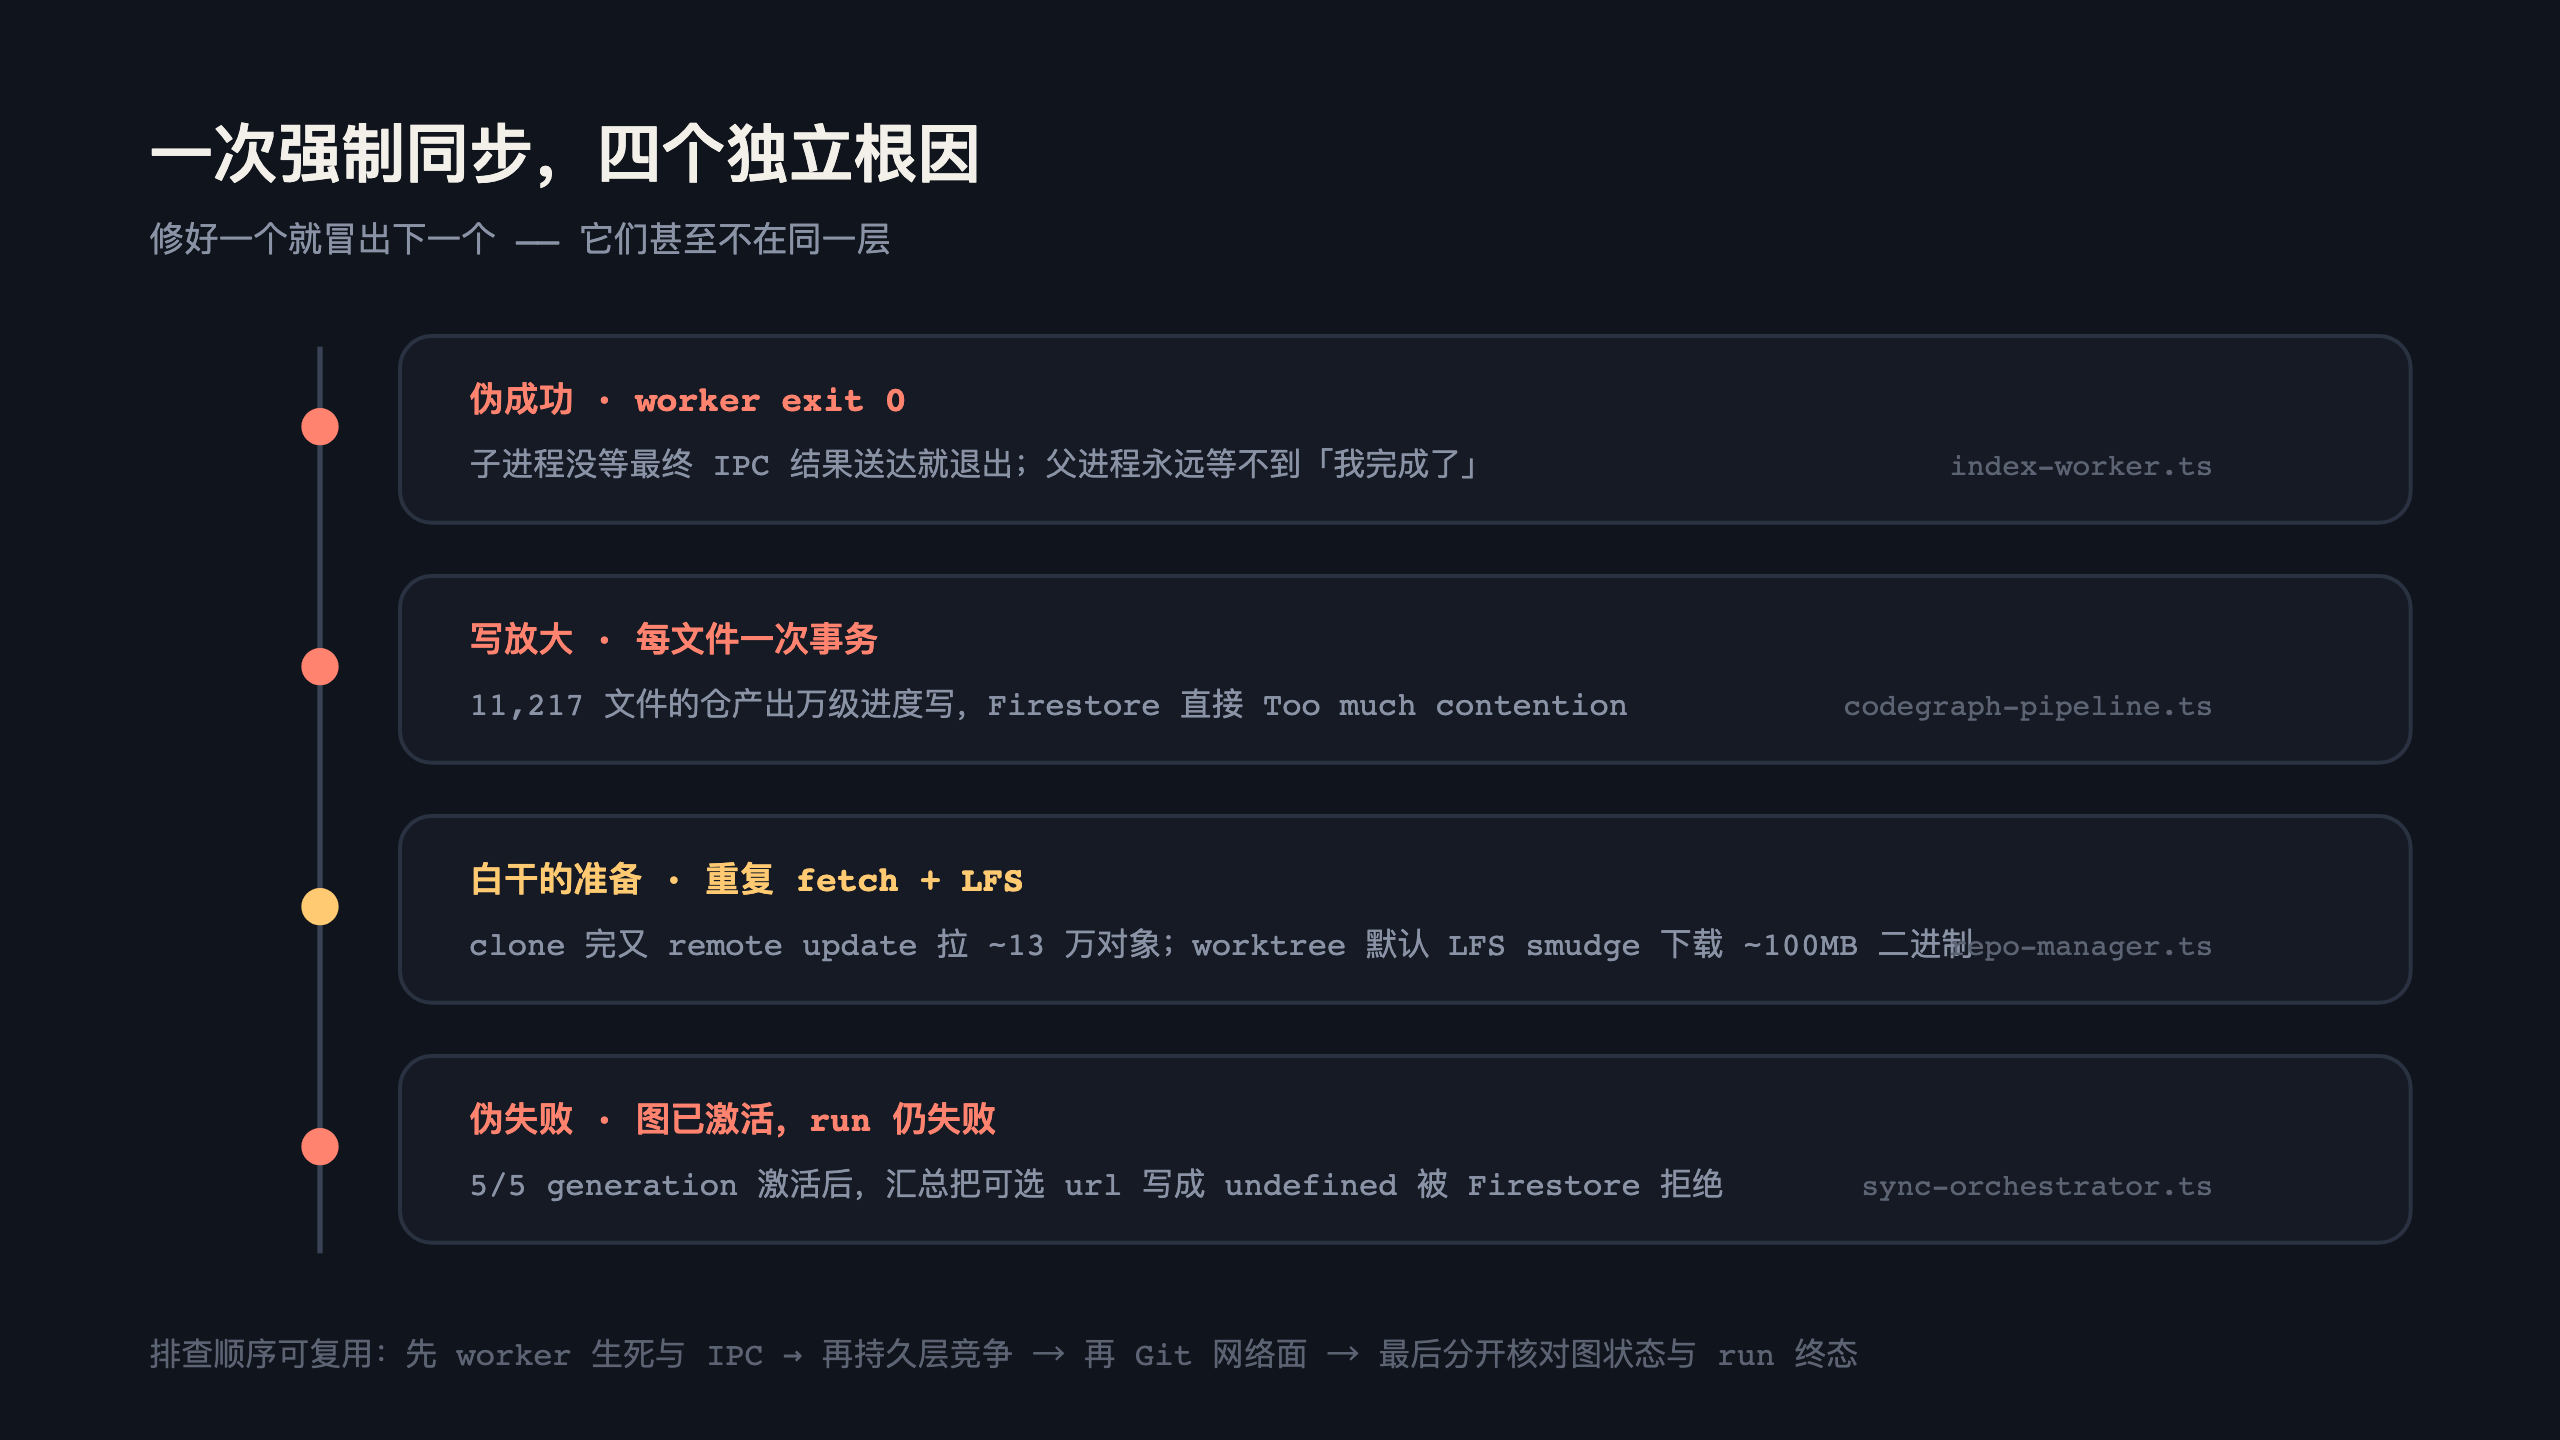
第一个坑很隐蔽。worker 进程退出码是 0,日志里也没报错,但父进程就是永远等不到结果,任务卡死不结。查下来是子进程没等最终那条 IPC 结果消息送达就退出了——Node 的子进程通道里,「我算完了」和「你收到了」是两回事。消息发进管道不代表对端消费完,进程一退,缓冲区里那句「我成功了」就跟着进了下水道。
修法是让 worker 在退出前确认最终结果已经可靠送达。这事的教训值得单独说:对子进程任务,退出码和结果送达是两个独立的成功条件。只看 exit code 0,你会把一个丢了战报的信使当成凯旋的将军。
修完之后第一个仓库跑通了:11,217 个文件、442,922 条引用,generation B 顺利激活。当时我以为战斗结束了,事实证明我只是通过了五关里的第一关。
第二只地鼠:把 Firestore 打成热点
第二个仓库开始变慢,然后日志里飘出 Too much contention。Firestore 的写竞争不是玄学,查代码发现进度上报的实现是「每解析一个文件写一次事务」——对一个上万文件的仓库,这就是万级并发事务怼同一个进度文档。进度条是细腻了,持久层先阵亡了,而且拖慢的是排在后面的所有仓库。
修法是把进度上报改成按阶段、完成事件和时间窗节流,再串行持久化。代价是 UI 不再逐文件强一致,但说实话那本来就是幻觉:用户看进度是想确认「跑到哪一阶段、卡没卡死」,不是想欣赏文件名刷屏。这里有个反直觉的换算:高频进度不等于高可观测性,当持久层本身受限时,过细的进度写入会把「观测」变成「故障源」。节流后的快照丢了一些瞬间精度,换来的是进度系统自己能活下去。
第三只地鼠:白拉 13 万对象和 100MB 二进制
第三个坑不报错,它只是贵。准备阶段的日志显示,首次 mirror clone 之后代码又做了一次 remote update,把所有 refs 重新抓了一遍——日志里多下载了约 13 万个对象,干等好几分钟。然后 worktree checkout 默认开着 Git LFS smudge,moego-mobile 一个仓库就卡在约 100MB 的二进制下载上,还随时可能因为 LFS 权限问题整个挂掉。
问题是 CodeGraph 只索引源码:它不需要全 refs(分析的是目标分支的一个 SHA),更不需要 LFS 大对象(图里没有二进制的位置)。改成只拉目标分支、首次构建不重复 fetch、同步 worktree 禁用 LFS smudge 之后,clone 24 秒就进 checkout。
这类浪费最阴险的地方在于它不报警。每个选择单独看都有道理——「refs 拉全一点总没坏处」「LFS 开着工作树更完整」——但合起来就是给首次同步平白加了数倍的时间和一整个失败面。索引工作树应该只获取索引所需的数据,「拿全一点保险」在同步系统里是成本直觉最差的一句话。
第四只地鼠:图激活了,run 还是失败
最讽刺的留在最后。五个仓库的 generation 全部激活成功,按理该开香槟了——结果 run 汇总写 Firestore 时被拒。原因是汇总对象里一个可选的 url 字段带着 undefined 序列化进去,Firestore 对这种非法值直接拒绝整个写入。于是出现魔幻一幕:图是好的,任务是失败的。
这是四个坑里最贵的一个教训,因为它证明了「部分完成」和「整体成功」可以是完全相反的判断。如果验收看 generation 状态,这是全绿;看 run 终态,这是挂的。两个都是真话,但只有一个是用户和下游系统关心的。修法很小——缺失的可选字段直接省略,不序列化 undefined——但它揭示的问题不小:generation 激活、单仓结果、orchestrator 的 run 终态是三本独立的账,谁也别想替谁签字。
把「完成」定义成一桩事务
四个坑修完,我把首次同步明确写成一条不可拆分的成功链:准备 mirror 和目标 SHA 的 detached worktree → 子 worker 完成索引并可靠回传最终结果 → 进度按节流持久化 → inactive generation 校验并激活 → run 汇总落库拿到终态。链条上任何一环断掉,都不算完整同步——哪怕前面四环都成功。
这套模型真正防的是两种对称的幻觉。一种是伪成功:exit 0、generation 激活、进度 100%,单独看每个信号都像成功,凑不齐整条链就不是。另一种是伪失败:图已经可用但 run 显示失败,如果运维只按 run 状态机械重试,就会白白重建一份本来完好的索引。所以运维面板必须把图状态和任务状态并排展示——「索引成功但 UI 永远显示失败」和「重试覆盖可用快照」是两个会轮流值班的故障。
不这样做的代价也很具体:上游以为同步好了、下游检索永远拿不到新图,两边拿着各自的「真话」互相甩锅;或者更糟,自动化系统按 run 状态无限重试,把一次汇总字段的 bug 放大成对全部仓库的反复重建。事务边界的意义就在于,它把「哪一段出问题」和「整体算不算成功」解耦开——段可以各自重试,终态只有一个权威。
被我否掉的方案也值得记账,因为它们的卖点都真实存在过:逐文件写 Firestore,UI 精度最高,但写放大直接打死持久层;clone 后更新全部 refs,实现最简单,但首次索引没人需要这份完整;保留 LFS smudge,工作树最全,但图索引用不上二进制还多一个网络失败面;只修第一个 IPC 竞态就收工,改动最小,但后面三只地鼠会证明你修的不是「同步失败」,只是「第一个报错」。
「分段签收」是一种通用思想
后来我把这次的模型抽象了一下,发现它其实就是分布式系统里最朴素的那个道理:每个边界交接都需要确认语义。Git 那边的工作交接给子进程时,要问「结果回传了吗」而不只是「进程退了吗」;子进程的工作交接给持久层时,要问「写进去了吗」而不只是「调过写接口吗」;图构建的工作交接给编排层时,要问「run 拿到终态了吗」而不只是「generation 激活了吗」。
这个思想在很多地方都见过:消息队列里 ACK 和消费完成是两回事,两阶段提交里 prepare 和 commit 是两回事,TCP 里 sent 和 acknowledged 是两回事。同步流水线的特别之处在于,这些边界藏在一次看起来很本地的调用里——没有网络 RPC 提醒你「这里有个交接」,于是每个边界都默认继承了「应该没问题」的假设。故障定位最贵的一步往往不是修,而是意识到哪个边界一直在裸奔。
写代码时有个简单的自检方法:把链路上每一次「交给下一段」的动作列出来,逐个问「如果这段完成了但下一段没收到,系统会显示什么」。答不上来的交接,就是下一个事故现场。
顺带一个排障纪律也救了场:失败的 mirror 和 worktree 不要在排查中途删掉,移进 recovery 目录留作现场。中途中断的 clone 是最容易让人手痒想「删了重来」的东西,但它既是你复现问题的唯一道具,也可能是下个仓库唯一能复用的半成品。排障时保留现场,和写代码时保留收据,是同一种美德。
验收方式比修复本身更讲究
修这种长链路故障,验收只有一个诚实做法:从同一个外部入口重新触发完整任务,而不是跑完单测收工。最终的验证 run e2EujQNPMsrqKCnwtai9 以 completed 落库,synced=5 / skipped=0 / failed=0,五仓 generation 全部激活,pnpm check 和定向单测 7/7 通过。
但按惯例要泼冷水:这是本地五仓样本,不是生产证明。要把「本地跑通」升级成「生产可信」,至少还差四类验证:对 worker crash、IPC 丢包、Firestore 失败和磁盘满做故障注入,确认旧 active 始终保持可用;在真实多 Pod 环境验证全局 writer ownership,而不是只靠单进程队列;扩大仓库样本记录索引体积、耗时、峰值 RSS 和 Firestore 写量;给 temporary session 补 TTL、磁盘配额和重启后的 orphan 扫描。甚至全量测试并行跑时 worker 那个 5 秒超时也会抖——资源竞争这门课,生产环境还没开始给我上。把这些边界写进结论,不是谦虚,是防止下一个读到「5/5 成功」的人以为系统已经毕业了。
回头看,这次排查顺序本身可以复用:先确认 worker 死活和最终结果有没有发出,再看持久层有没有写竞争,然后查 Git 网络面和 LFS 这种隐藏成本,最后把图状态和 run 终态分开核对。别上来就把锅扣给索引器——这次的四个根因里它只占了半个。
还有一个更泛用的判断也成型了:长链路任务里,「阶段状态」和「任务终态」永远要分开建模、分开观测。阶段状态回答「进展到哪了」,终态回答「整体算不算数」,把两者塞进同一个字段的系统,早晚会在某个边界上同时产生假捷报和假丧报。
同步系统的终态不是一个布尔值,是一串需要逐段签收的边界。做基础设施久了会发现,「完成」从来不是默认值,是要被一段一段证明出来的。