先交代背景。我们内部有个知识源平台,把飞书、Slack、GitHub、Intercom 这些内容源接进统一检索,供内部问答产品用。每接一个新来源,表面上就是写个 connector、配个 token,实际上它要穿过一条从「配置对象」到「可执行 runtime」再到「真实连接」的长链。接 Intercom 的那两天,我接连过了三道门,每道门后面都蹲着一个「这也算问题?」级别的坑。
事后复盘,这次接入最有价值的产出不是 connector 本身,而是把一个模糊概念拆明白了:一个数据源「上线」不是二元状态,是「能创建」「能运行」「能连接」三层各自独立的通关记录。每层有自己的门卫,混着验收就会互相假装对方已经检查过了。
故事的起点很典型:用户在管理界面成功创建了 Intercom source,UI 显示一切正常,结果第一次同步立刻报 UNSUPPORTED_SOURCE_TYPE。创建成功、运行必败——这个组合本身就是诊断书上第一个症状。
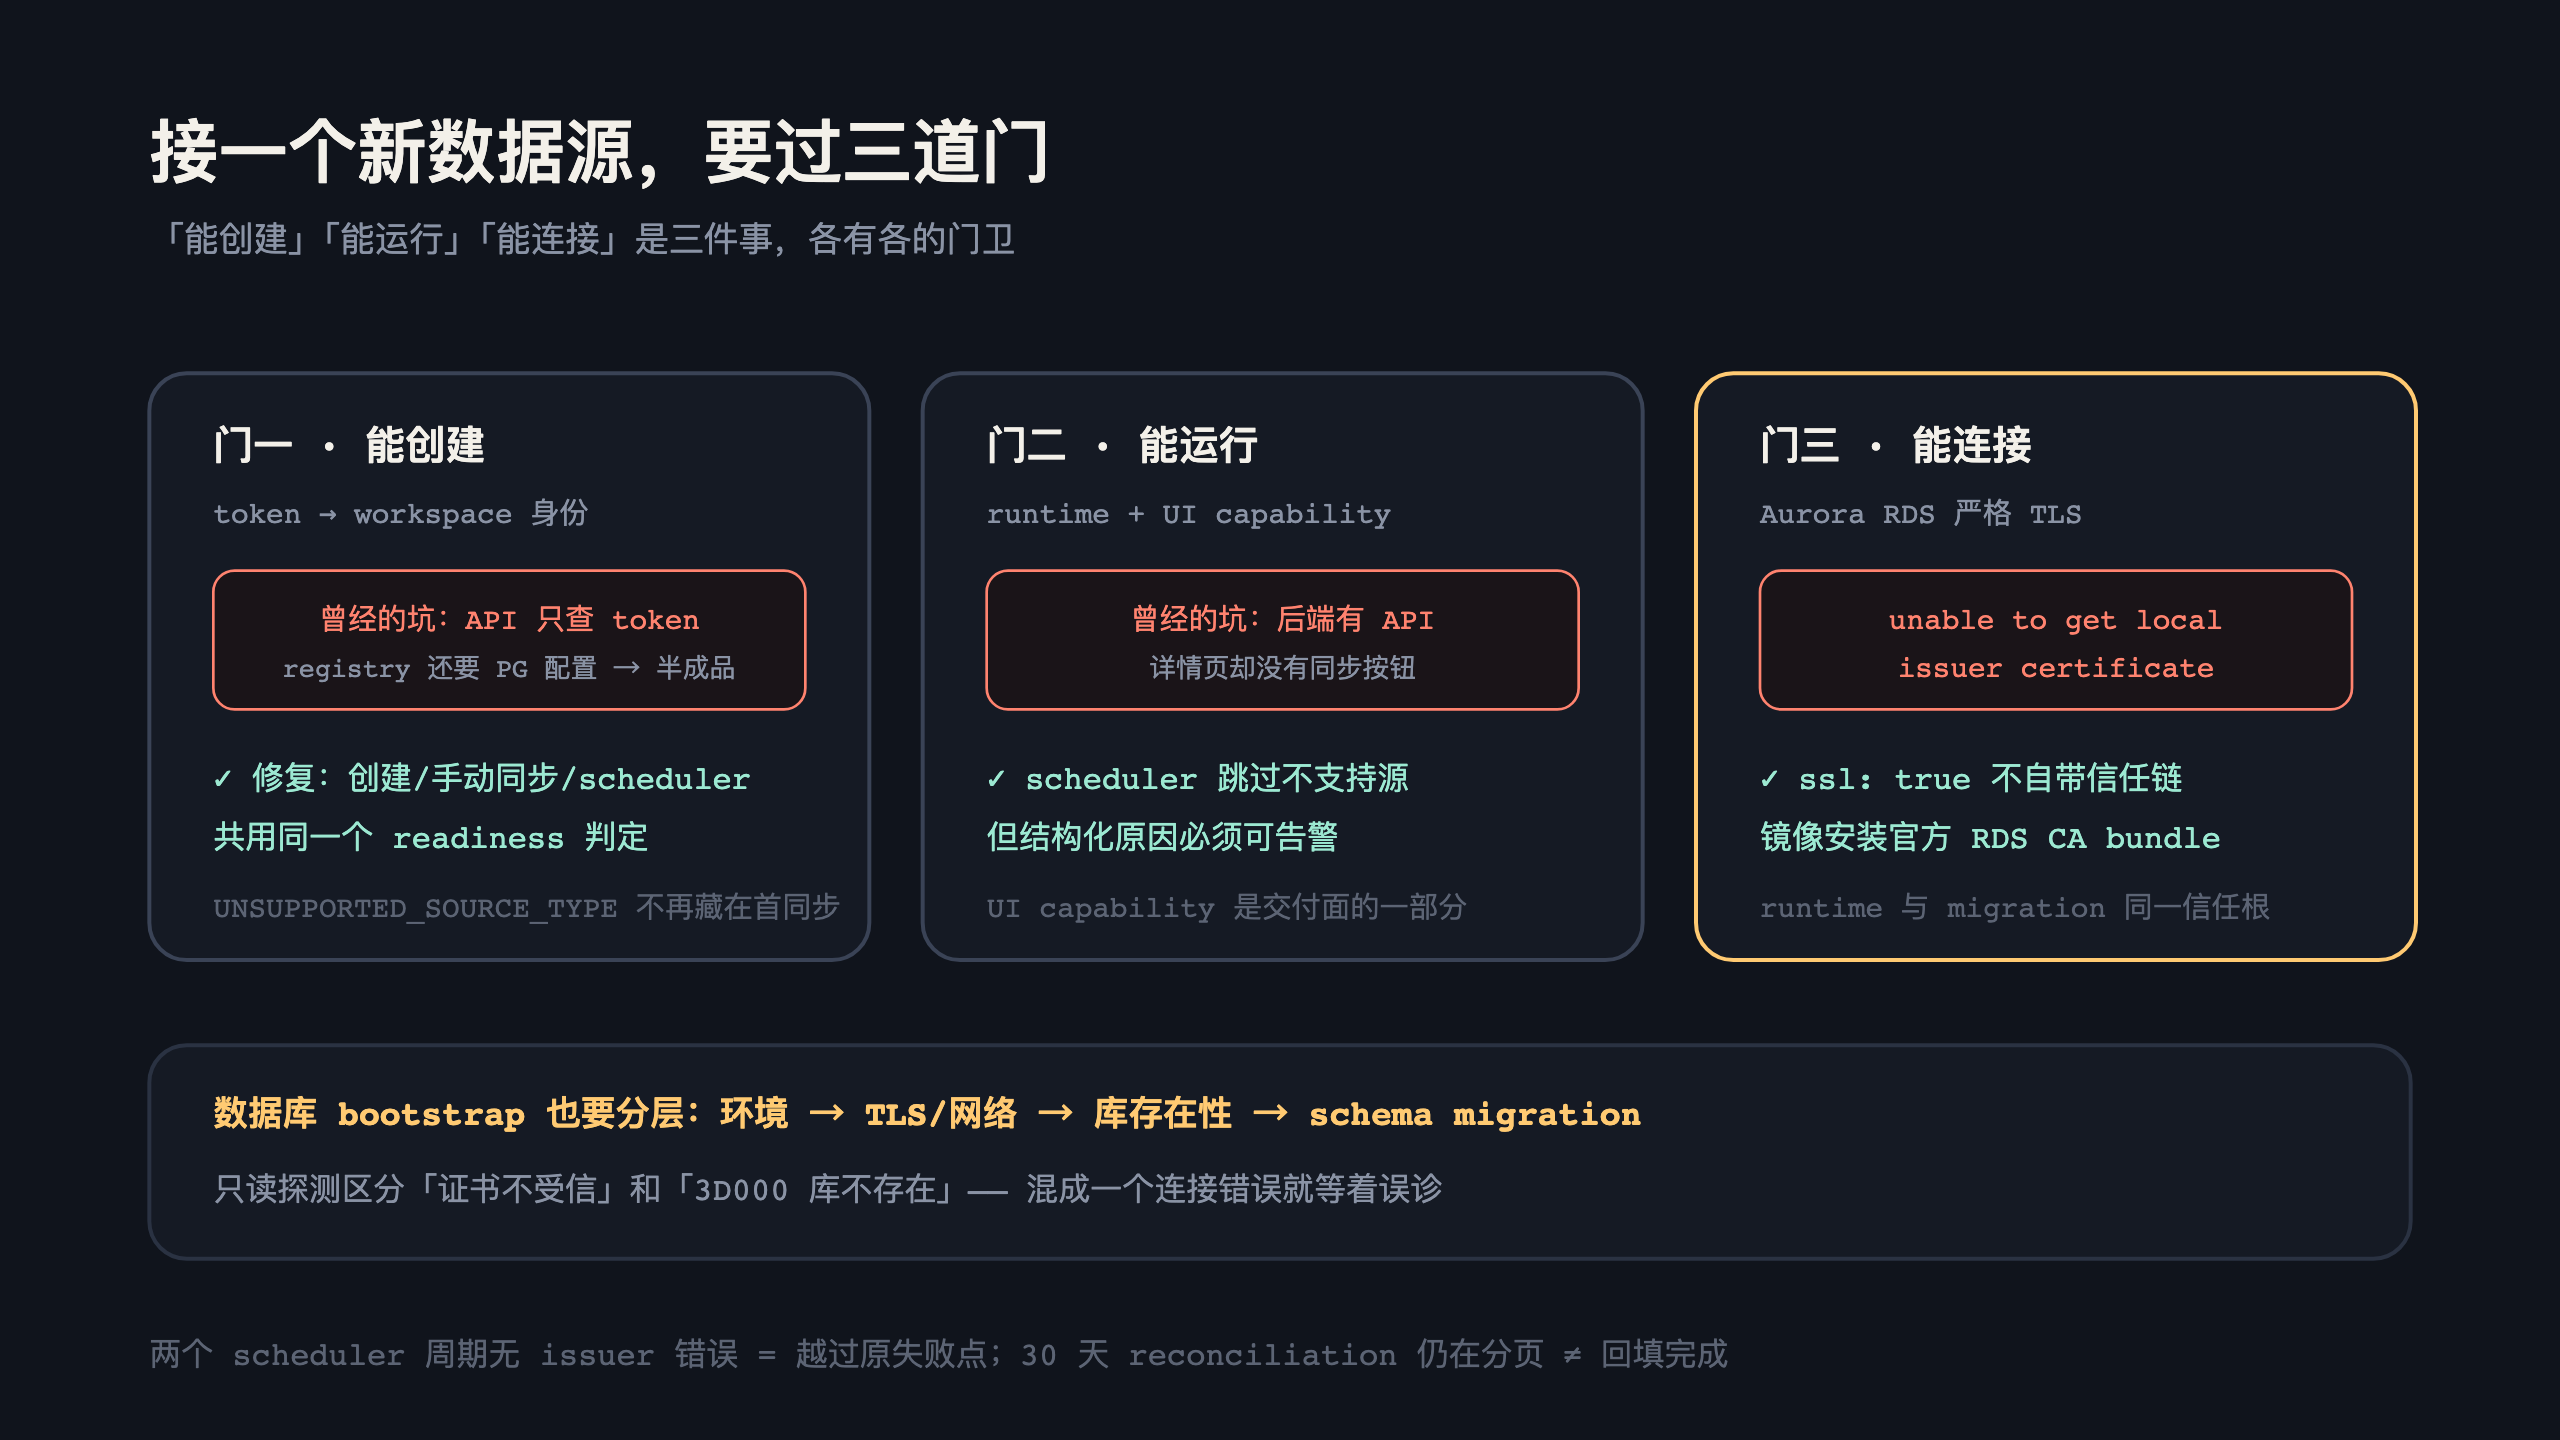
门一:能创建 ≠ 能运行
查代码发现「是否支持这种 source」这个判断在系统里有两份各自维护的实现:Admin API 创建时只检查 Intercom token 有没有配,pipeline registry 执行时却要求 token 和 PostgreSQL 配置同时完整。两边条件一对不齐,系统就能持久化一个「创建成功但执行器根本不存在」的半成品 source。用户的体感是「我明明配好了,它说我没配」,开发查代码的体感是「两边都没错,合在一起错了」——每个局部都守规矩,整体照样出事故,这类「条件漂移」是多入口系统里的经典病灶。
修复思路是把 runtime readiness 变成唯一事实源:创建和手动同步在 pipeline 未注册时直接返回明确的 readiness 错误,把「可预判的配置错误」从首次同步的运行故障,提前成创建时的明确拒绝。为什么不等到首次同步再报?因为那样会持久化一条明知跑不起来的配置,给用户错误的成功反馈,还让一条本可以一句话说清的问题变成一次带 run 记录的假故障——排障的人还得去翻执行日志才能发现它胎死腹中。
scheduler 侧的处理也有讲究:对当前实例不支持的已有 source 要跳过,让其他 source 正常跑——一条坏配置不该拖垮整个轮询周期;但跳过必须带结构化原因和可告警信号,因为一个静默跳过的 source 就是一条永远没人发现的死配置。skip 只有在原因可观测时才算可靠降级,否则就是体面的吞错。
顺手还抓了个交付面的问题:后端手动同步 API 早就有了,但 Admin UI 的 source-type capability 没注册 Intercom,详情页上根本没有按钮。后端能力存在不等于用户有入口,UI 的 action registry 也是能力交付的一部分,验收时得算进账里。这轮改完跑了 44 个定向测试,但老实说当时只是本地实现,部署证据是后话。
半成品 source 的隐性成本也得算一笔:它会占住一个配置名额、产生失败 run 记录、消耗用户的信任额度,最后还得有人去清理。创建时一句「当前部署不支持 Intercom,缺 PostgreSQL 配置」就能拦下的事,非要拖到首次同步变成一条带着 stack trace 的运行故障,这不是宽容,是把成本转嫁给未来。能力判定成为 API、scheduler、UI 三方共享的契约之后,新增 source type 的验收清单也顺势多了一条硬规则:runtime、capability、readiness 测试三件套一起交,少一件都算没接完。
门一点五:身份是服务端解析的,不是客户端填的
readiness 之前其实还有半道门容易漏:token 对应的 workspace/application 身份必须由服务端解析,客户端传进来的值只作显示用,或者直接拒绝不一致的输入。这听起来是常识,但它是整个「能创建」判定的上游——如果客户端能随便声明自己是谁,readiness 检查的就是一个伪造的前提。接入凭证的第一课:凭证是服务端去验的,不是客户端去说的。
门二:bootstrap 要分层,别一锅炖
readiness 过了,接着启动数据库。这一步最容易犯的错是把「连不上」当成一种病。实际上 Intercom 状态库的启动是四个独立阶段:环境有没有真的加载、TLS/网络通不通、目标数据库存在不存在、schema migration 跑没跑过。每个阶段有自己的失败签名,混成一个「connection failed」去查,就是给自己找不痛快。
实操上我坚持用只读探测先把病因分层:连接上去先发只读查询,TLS 证书错误和 PostgreSQL 的 3D000(数据库不存在)是两种完全不同的病,前者要补信任链,后者要建库——两者的处方、负责人、回滚方式都不一样。确认是库不存在后由人授权创建,再跑版本化 Prisma migration,最后回查核心表和 schema——「migration 命令成功」不等于「目标库对了」,回查这一步是防「迁移到了一个错误的库里还自鸣得意」。分层听起来麻烦,但它把「下一步该找谁」变成了查表题:TLS 归平台和镜像,建库归 DBA 或责任人,schema 归 migration 版本,谁的孩子谁抱走。
还有个排障纪律救过我一次:诊断必须从应用真实启动入口跑。在随手开的 shell 里测连接,cwd 不对、环境变量没加载,会得出「配置缺失」的假阴性结论——你在错误的手术室里宣布病人死亡。当时就有人差点在诊断 shell 里误判配置没生效,回到真实启动入口一看,环境好端端加载着,真正的病在更下游。
门三:ssl: true 不等于有信任链
数据库有了,testing 环境 scheduler 开始报 unable to get local issuer certificate。早期有人猜是 Intercom API 或者 token 的问题,甚至有人提过先把 TLS 校验关了。但失败时序救了我:错误出现在 discovery 之前,连跟 Intercom API 无关的同步 outbox 也一起挂——业务调用还没出门,车就已经翻在车库了,这病在传输层,不在业务层。
根因一句话就能说完,但坑了不少人:INTERCOM_PG_SSL_MODE=require 被翻译成 node-postgres 的 ssl: true,开启了服务端证书验证,却没有人往容器里放 Amazon RDS 的 CA 证书。require 只表达「我要 TLS」,它不会替你把云厂商的信任链注入镜像。加密和身份验证是两件事,ssl: true 管了前者,后者没人管。
这个错误的迷惑性还在于报错文本:unable to get local issuer certificate 直译是「本地拿不到签发者证书」,听着像客户端自己的毛病,实际上它的意思是「我收到了服务端证书,但本地信任库里没有能验它的 CA」——证书链验到一半断了。Aurora 的证书由 AWS 自己的 CA 体系签发,标准系统 CA bundle 里没有这一支,容器里不补装就一直断在同一个地方。
修复没有走任何捷径:镜像构建时装 AWS 官方 global RDS CA bundle,runtime 的 pg 连接用 rejectUnauthorized: true 加显式 ca,缺了 CA 文件就明确失败、不静默降级;Prisma migration 的连接串用 sslmode=verify-full 加 sslrootcert 指向同一个 bundle——两条连接链共享同一信任根,只修一条另一条照样摔,这是这次修复里最不值得省的钱。定向测试也把「CA 文件缺失」和「strict 配置」列成了硬性用例,防止哪天镜像瘦身顺手把证书也减掉了。
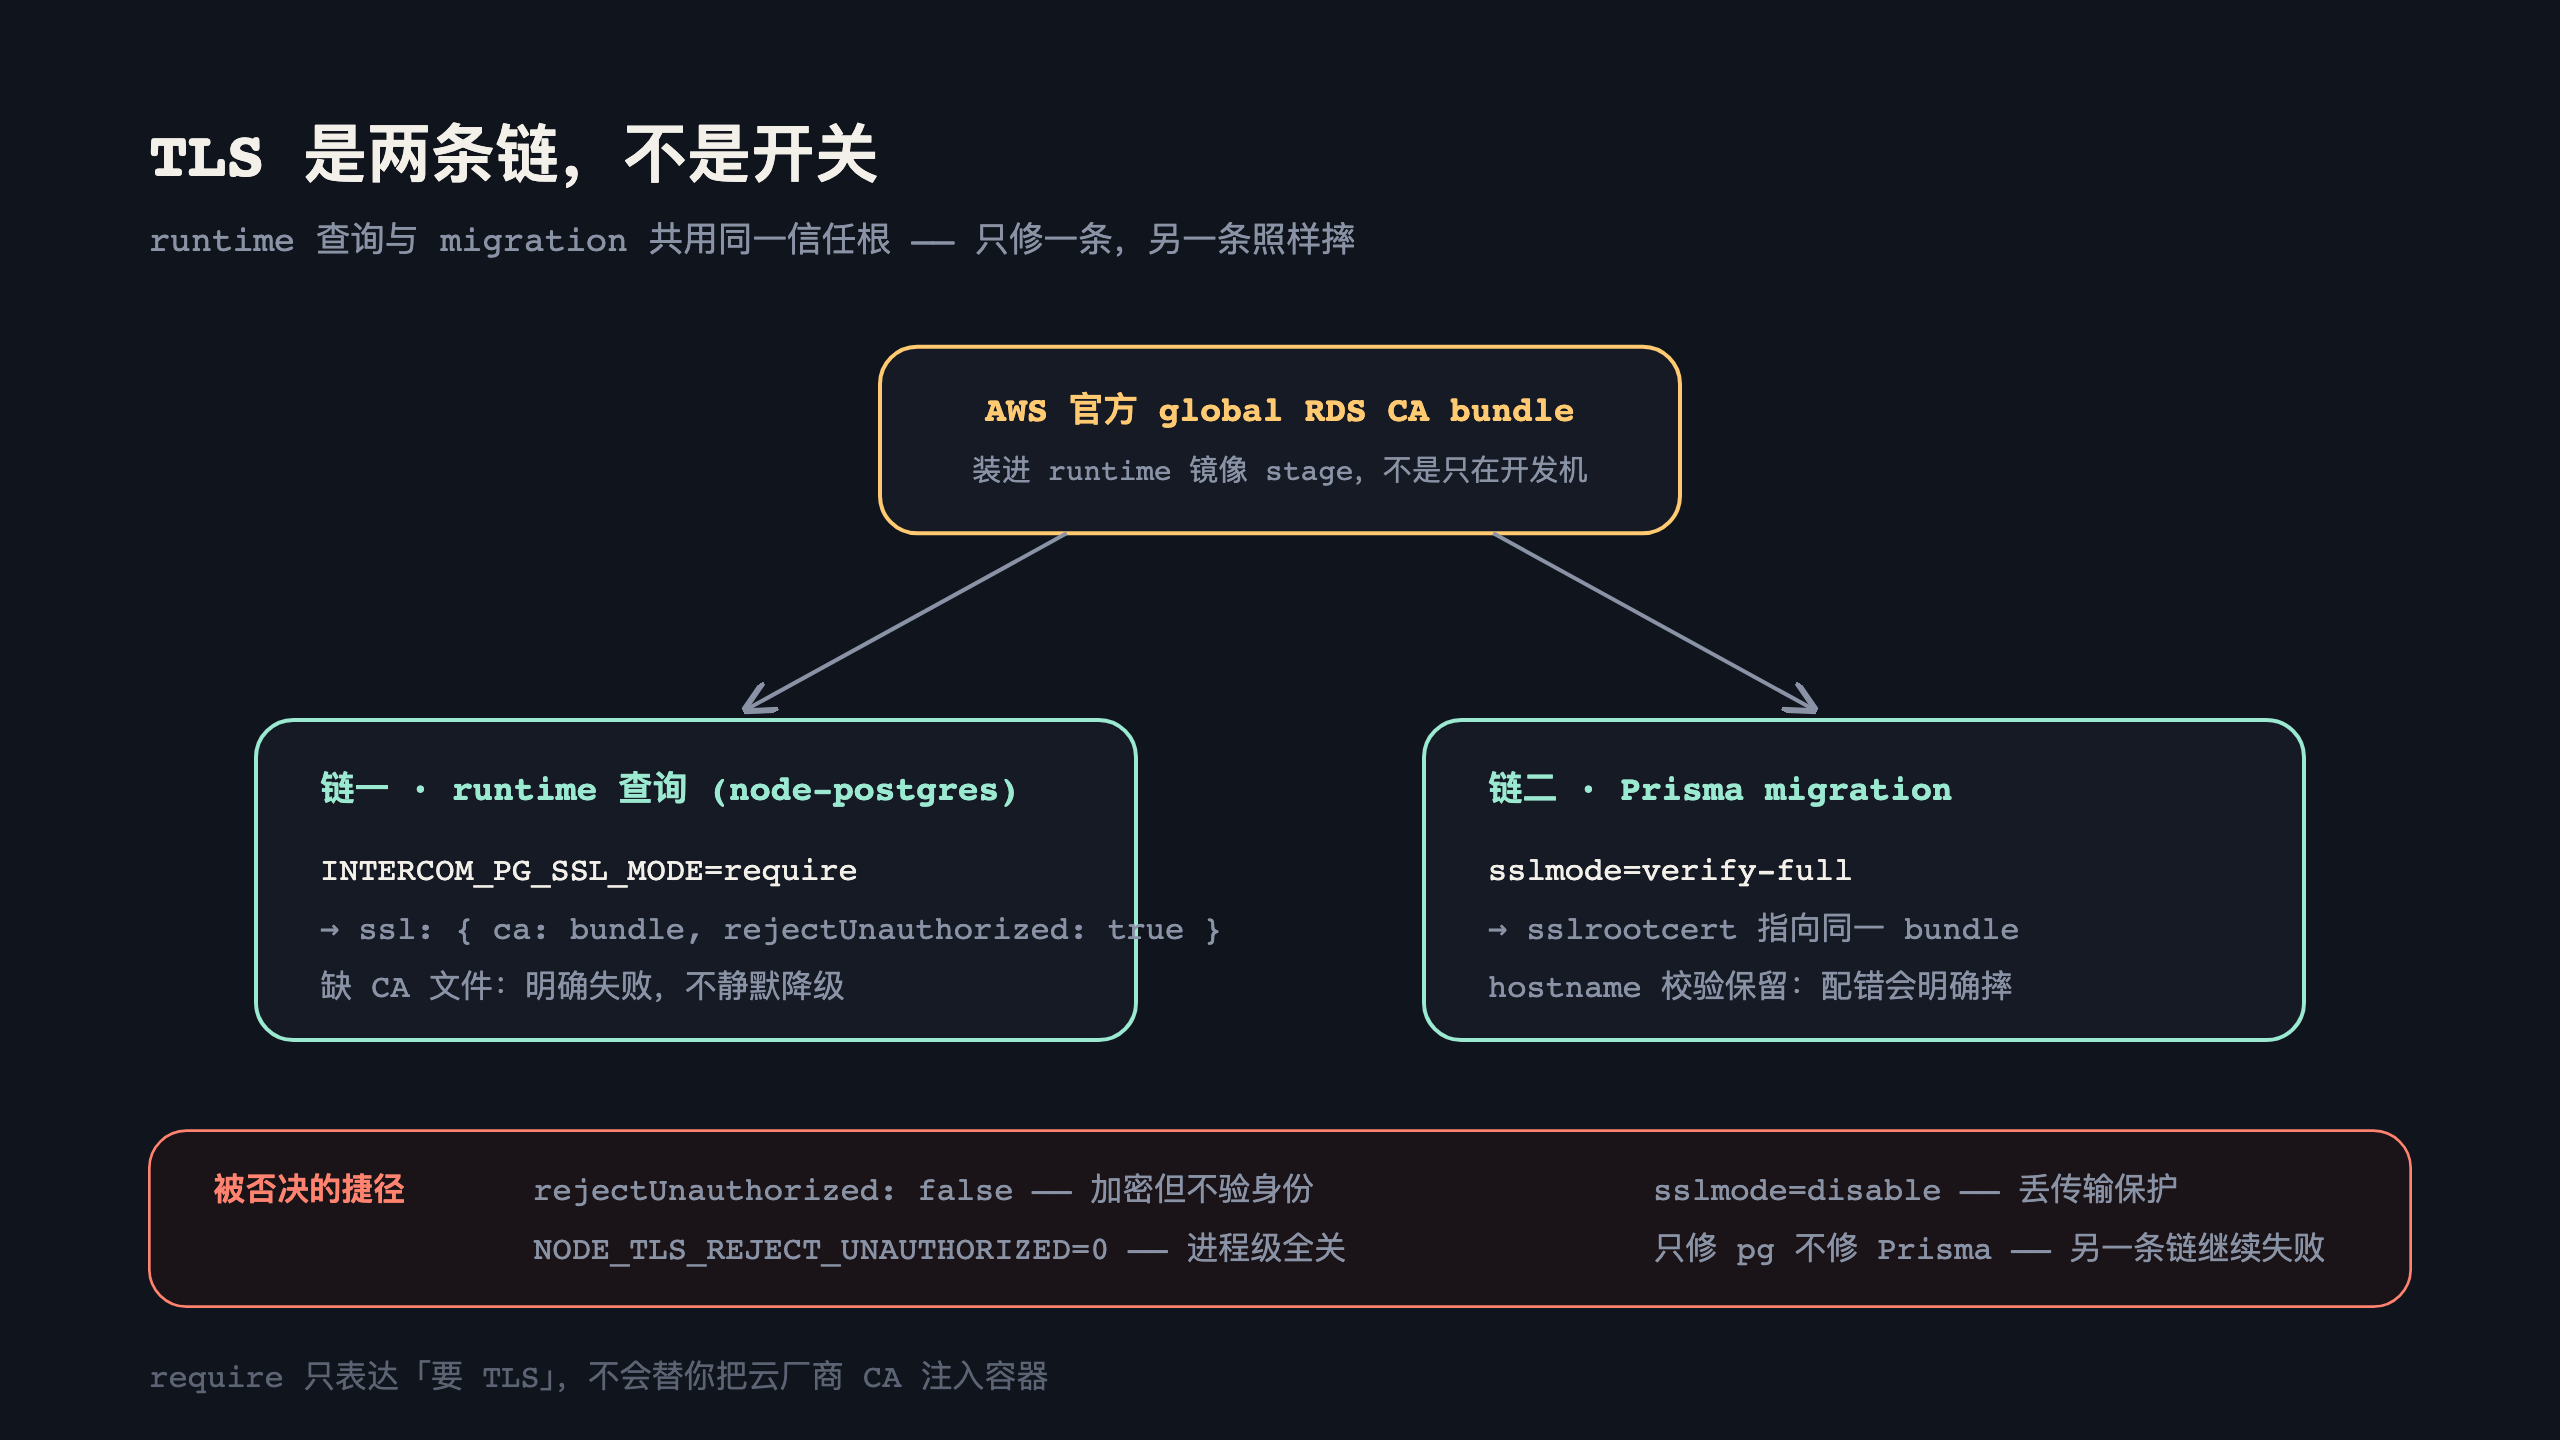
被否决的捷径值得列出来示众:rejectUnauthorized: false,加密了但不验证服务端身份,等于给中间人发请柬——你连的可能是个会背错密码的陌生人;NODE_TLS_REJECT_UNAUTHORIZED=0,进程级关闭所有 TLS 验证,为了修一个数据源把整个 Node 进程的证书校验全拆了,故障域大到离谱;长期 sslmode=disable,传输保护和身份校验一起丢,只能作为获授权的短期诊断手段——事实上 bootstrap 当天确实临时关过一次 TLS 定位问题,但那是用户明确授权的一次性操作,当天就被严格 CA 方案取代,不能升格为默认。最后还有「只修 runtime 不修 migration」和「只在开发机装 CA」两个半吊子方案:前者让查询通了但部署时 migration 继续失败,后者让本地通了但 CI/EKS 镜像里依然裸奔。
为什么值得为严格模式付这个价?verify-full 不只验证书链还验 hostname,配置指错库、DNS 被劫持、证书被替换,都会明确失败而不是悄悄连到错误的终点。闭一只眼换来的可用性,本质是拿「连到谁都行」换「连得通」,这笔账在安全语境下永远亏。
验证要爬楼梯,别一步到位
TLS 修复的验证梯度是这次最规范的部分,值得单独强调因为它直接决定结论能写多满:先跑配置层测试(strict 配置、CA 文件缺失、URL 生成),再对真实 Aurora 做无降级的只读查询——不是 mock,是真连接;然后 20 个定向测试、pnpm check、1225 个测试和生产构建,最后 CI 镜像构建、EKS testing rollout、观察新 Pod 连续两个 scheduler 周期不再出现 issuer 错误、source 进入 discovery。每一级台阶回答一个不同的问题:配置测试证明代码意图对,真实查询证明信任链通,rollout 证明 CA 文件真的进了 runtime 镜像而不是只躺在 builder 里,scheduler 周期证明原故障点没有复发。
但终点要诚实标注:会话结束时 30 天 reconciliation 还在分页跑。「越过原失败点」只证明证书故障消失、同步已启动,不证明历史数据回填完成,更不证明 production 就绪——那边的镜像、hostname、CA 文件当时一个都没验。把「阶段性证据」写成「最终结果」,是这类修复报告里最常见的浮夸,我当时特意在结论里写死了边界。
遗留的功课也记着:AWS 的 CA bundle 会更新,镜像里那份文件得有供应链校验和轮换演练;scheduler skip 的告警阈值和恢复入口要持续核验;两个无错误周期能否定「原故障还在」,但不能证明证书轮换、网络抖动这些场景的稳定性。同步流水线本身的观测也要分段——discovery、transform/index、outbox、reconciliation 各是各的阶段,不能用「进入 discovery」替代「最终完成」。这些没做之前,结论只能停在「testing 已越过 TLS 启动故障」。
回头看,三道门背后是同一个模型:把「对象存在」「执行能力」「连接可用」拆开验收,每层的失败都留在当层定位。这个模型不只适用于 Intercom——之后接 Help Center、内部知识库或者任何新数据源,验收清单都可以直接套:配置对象和执行能力共享同一 readiness 判定;scheduler 对不支持源跳过但原因可告警;连接按环境→TLS→存在性→schema 分层探测;所有「先跑通再说」的降级都必须标注一次性授权和继任方案。
创建时该拒就拒,scheduler 该跳就跳但要留证据,TLS 该严就严两条链一起严。上线这个词太模糊了,以后我只会说:它过到第几道门了。