先交代一下多跳检索在做什么。我们的 RAG 不只搜一遍:hop-0 先取回初始证据,再从统一的 references metadata 发现下一跳目标路由到不同 connector,由一个充分性 judge 判断「证据够不够、要不要追一问」,追出来的 follow-up query 再拿回新候选,最后所有候选融合、rerank、过 context budget,变成 Answer 能引用的 sources。链条拉得越长,每一步「证据还在不在」就越是个问题。
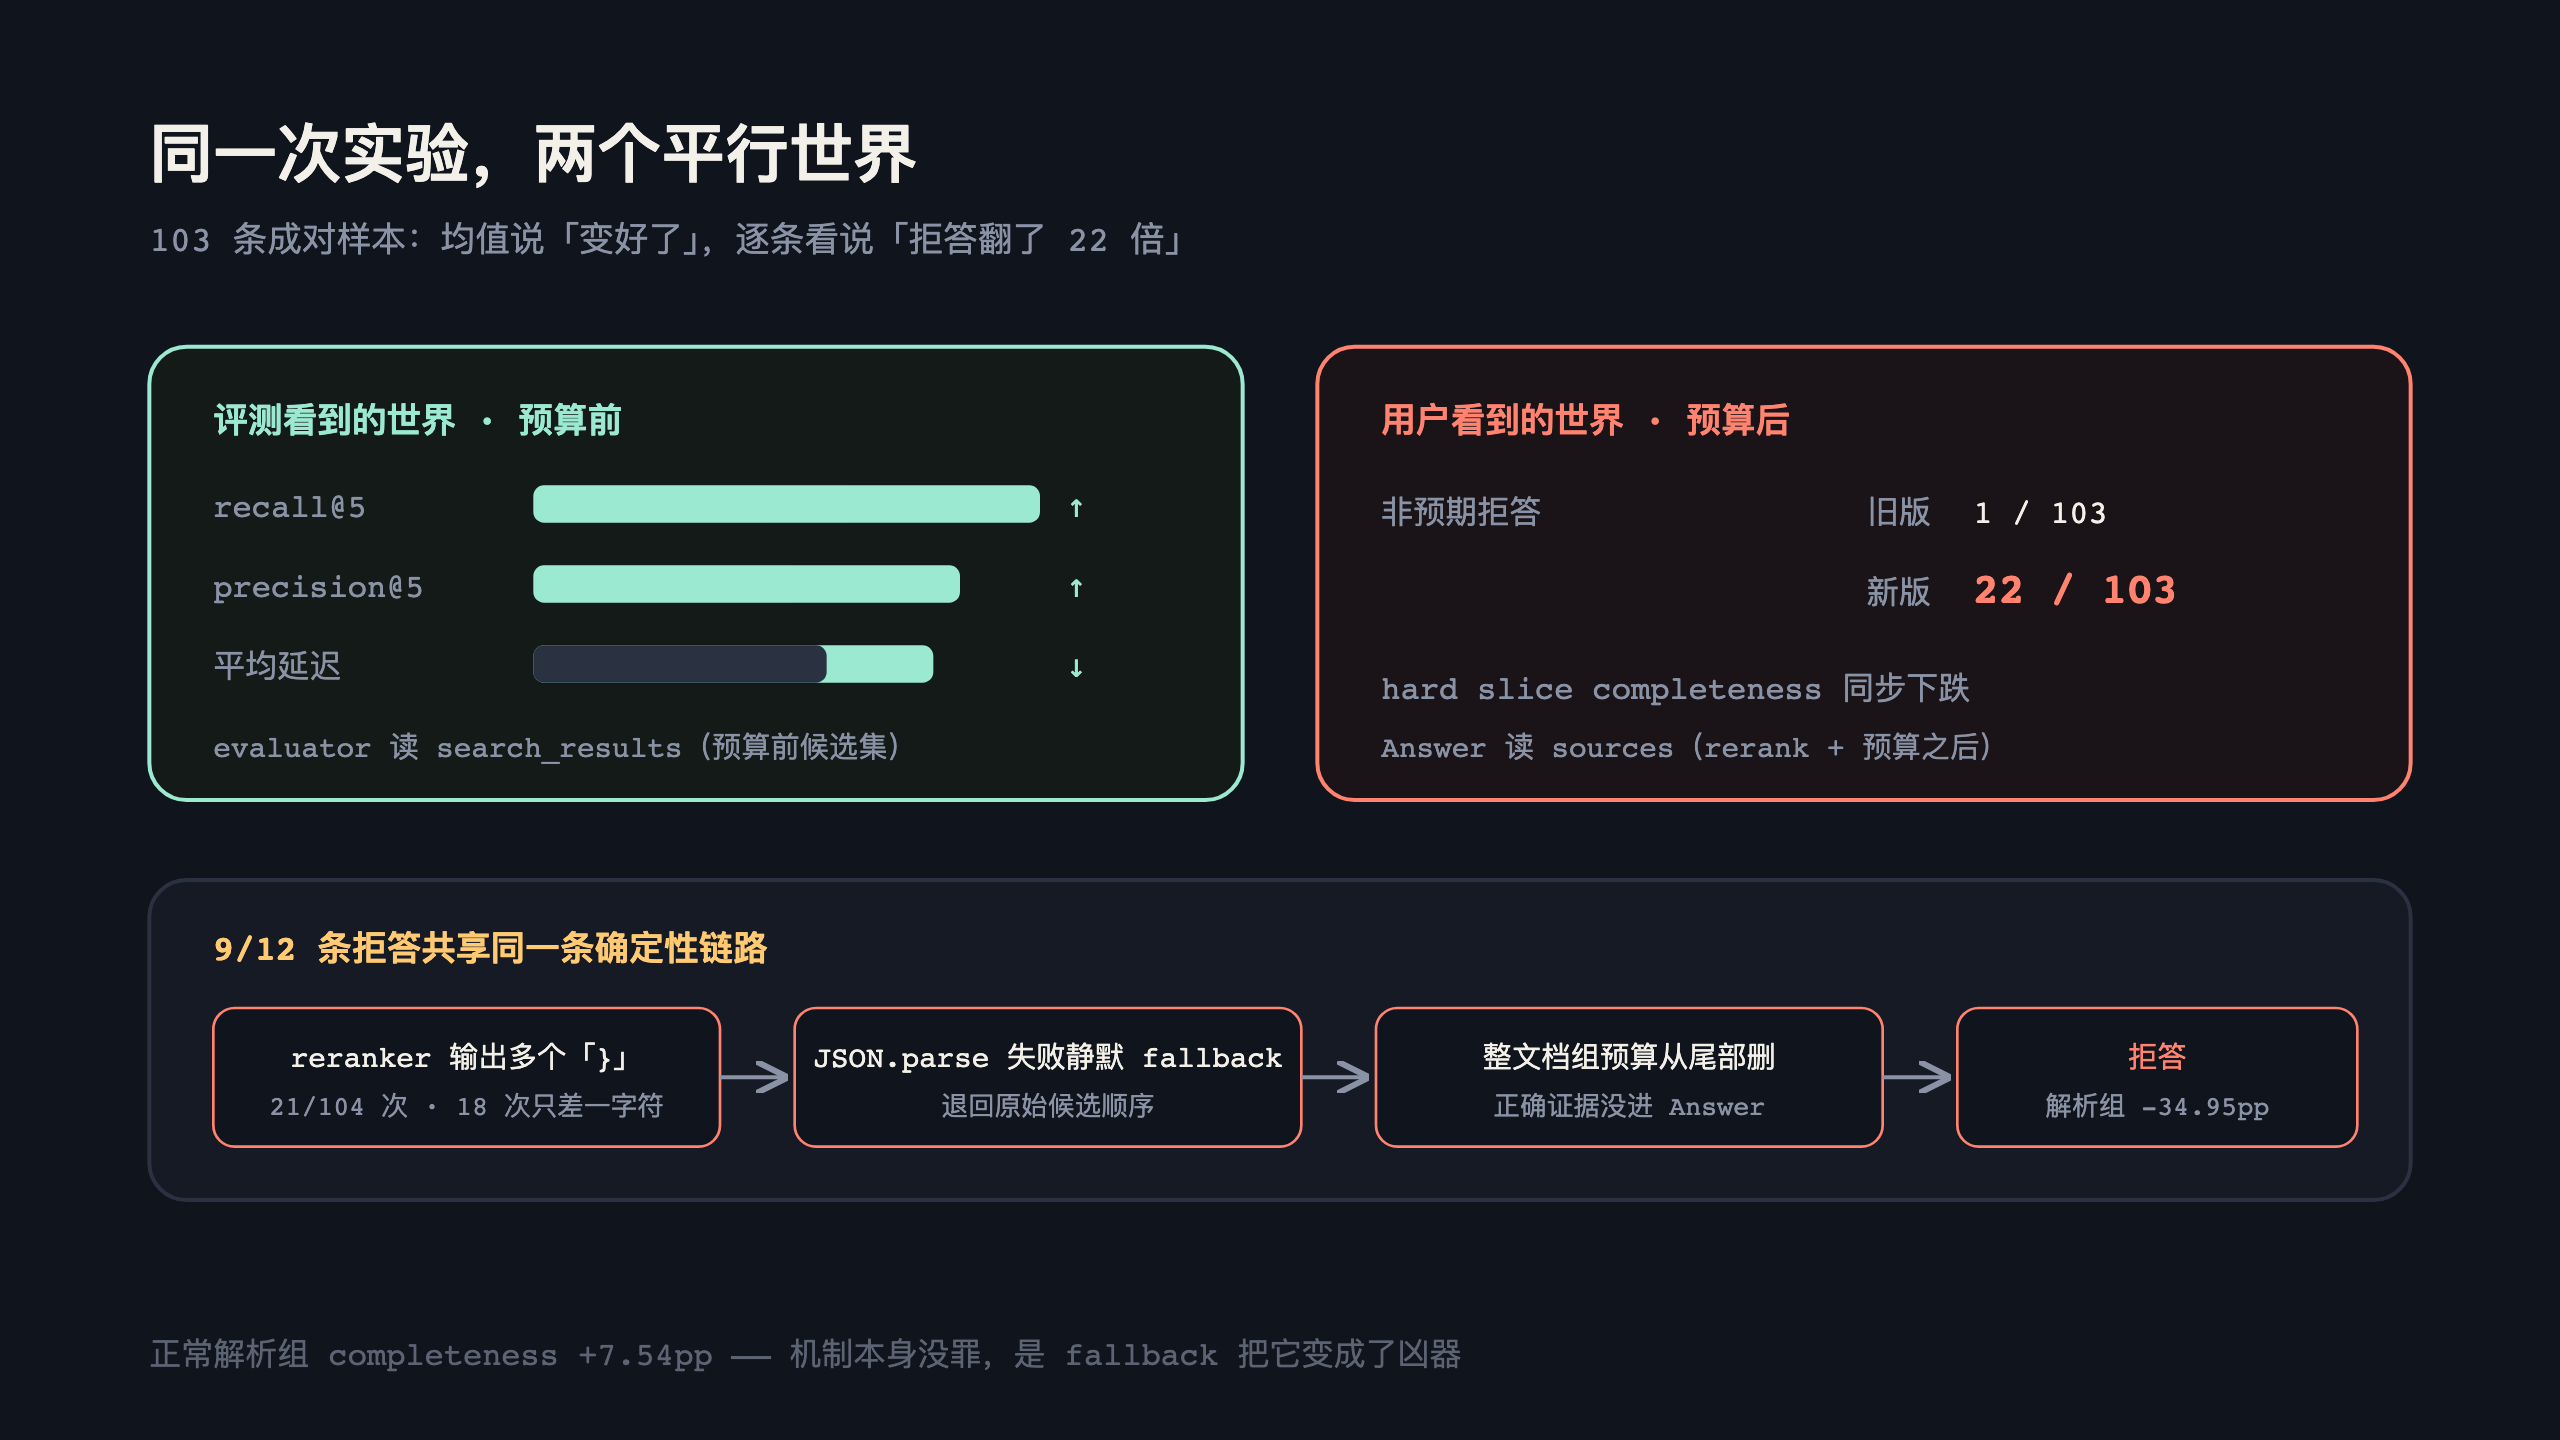
事故发生在一次很窝火的实验评审上。新 Hop 链路和老链路做对照,两个 experiment 用同一个 dataset、同样 103 条历史快照做成对比较。聚合指标一片大好:recall@5 涨、precision@5 涨、平均延迟还降了。按理说这该是个开香槟的评审会,直到有人把「正常产品问题的非预期拒答」拉出来:旧版 1/103,新版 22/103。
指标在涨,答案在拒。这两个事实同时为真,说明它们看的根本不是同一个世界。
两个平行世界:预算前和预算后
查 trace 后第一层的解释很简单,简单到让人脸红:retrieval evaluator 读的是预算前的 search_results,而 Answer 吃的是预算后的 sources。中间隔着 rerank 和 context budget 两道工序。评测说「证据召回得更好了」,回答侧说「我压根没见到那份证据」——都对,只是说的不是同一批。
这个分工本身没有错:评测想衡量「检索链路本身的召回能力」,用预算前的集合有道理;产品要的是「答案里有没有证据」,只能用预算后的集合。错的是没有人意识到这是两个不同的承诺,一份实验报告把两种口径混着念,读起来就成了「全面提升」。改进的检索把更多好证据送进了预算前,然后预算后把它们一批批杀掉——前半场扩建,后半场拆楼。
这就是均值最阴险的地方。它给你看的是海选阶段的进步,淘汰赛的伤亡被平均掉了。22/103 的拒答分布在长尾里,recall 的均值根本托不住这种断崖式失败。
凶案现场:一个多出来的「}」
把 12 条正常问题的拒答逐条刨开,9 条共享同一条确定性链路,链路第一环小得可笑:reranker 的输出多了一个尾 }。严格 JSON.parse 一遇到就失败,失败后代码走了一条「静默 fallback」——直接沿用原始候选顺序。然后 context budget 按「完整文档组」从尾部淘汰,原本排名靠前、被 fallback 送回尾部的正确证据就这么被删了,Answer 两手空空,只能拒答。
数字很难看:新实验里 104 次 reranker 调用,21 次解析失败,失败率 20.2%;其中 18 次只是输出里多了一个字符。解析失败那组的 hard slice completeness 比旧版平均掉了 34.95 个百分点,而正常解析组反而提升了 7.54 个百分点——机制本身没罪,是 fallback 把它变成了凶器。同一个 reranker,输出合法时是增益,输出多一个 } 时就变成了证据杀手。
也要诚实标注证据强度:这组数字是明确的关联,不是随机对照的因果证明——但失败格式、fallback 代码路径和证据丢失轨迹三条线互相印证,可信度足够指导修复方向。
还有个小细节特别阴:重试机制会让第二次的错误结果覆盖第一次的正确结果——第一次解析明明成功了,重试逻辑又把那份合法输出换成了新的坏输出。好心办坏事,办得还很安静。
剩下的拒答分类也值得交代:12 条里 9 条走上面这条链路,2 条解析完全正常但死于整文档组预算——多部分问题的次级证据被整组删除,主文档倒是完完整整。也就是说拒答不是一个病,至少是两个,共用的只是「预算后证据丢失」这个症状。分类的意义在于药方不同:前者要修 parser 和 fallback,后者要改预算策略,混在一起治就是白治。
另一个病灶:并发顺序成了排名信号
拒答之外,这次评审还逼着我们回头补了融合层的课。多跳检索的 adaptive judge 会生成多条 follow-up query,每条拿回一组 semantic candidates。原实现把结果直接追加,下游配额直接 slice——这意味着什么?异步任务的完成顺序变成了隐式排名。哪个 query 先返回,它的候选就排前面;同一 chunk 被多条 query 共同命中这种最强共识信号,直接扔进了下水道。
修法是把排序挪到裁配额之前:semantic candidates 按 follow-up query 分组,组内按 rawScore 排名,同 hop 内去重保留更高分,跨组做 RRF(k=60),被更多独立 query 命中且组内排名高的 chunk 拿到更高 rrfScore;graph/reference 候选按 rawScore × decayFactor 排序,保留 hop 衰减语义——直接命中的证据天然压过二手引用;两类候选各自排序完才裁各自的配额,最后进统一的 LLM rerank。改完 699 项测试全过,但那只是「排序不再看并发运气」,效果归因还得等下一轮实验。
这里要澄清一个简历上都容易写错的点:这个 RRF 解决的是「多条 follow-up query 的候选列表怎么融合」,不是 BM25 和向量召回的 hybrid fusion——那层融合根本不在这里发生。关键词撞车,层级完全不同,写进文档或简历前最好想清楚自己说的到底是哪一层。
为什么用 RRF 而不是别的?被否掉的方案各有死法:直接追加,并发顺序就是排名;先 slice 再排序,高相关候选可能在排序前就被裁了;只比各 query 的 raw score,不同 query 的绝对分数根本不可比——这条 query 的 0.8 和那条的 0.8 不是一个 0.8。RRF 只看名次不看分值,顺带把「多条 query 共同命中」的共识累积了进去,是这层融合最对症的药。它治不了的是另一个病:不同 channel、不同 datastore 的分数归一化,跨源可比性还得另想办法。
概念:证据存活率是个一等公民指标
这次复盘真正沉淀下来的概念是 evidence survival:从 hop-0 召回,经 references 扩展、充分性判断、候选融合、rerank,到 context budget,一路走到最终 sources 和 citation——相关证据必须活着穿过每一道门,检索执行成功和预算前指标改善都不算终点。
按这个标准,那次实验里的每一环都是一次潜在的「证据谋杀现场」:reranker 解析失败是凶器,静默 fallback 是帮凶——它把输入缺失伪装成了「模型排出来的顺序」;整文档组预算也有责任,它保证了主文档的语义完整,却保证不了多部分问题的次级证据——另外 2 条拒答就是解析正常、但次级证据被整组删除的。多部分问题要的是「每个子目标至少留一份证据」,整组淘汰做不到这一点。
修复方案当时全部停在 proposed,写清楚是因为「诊断出来」和「修好了」是两回事:reranker 换结构化顶层对象加 schema 校验,解析失败至少重试一次、绝不静默沿用原顺序;预算从「完整文档组淘汰」改成跨组最小配额或 round-robin;评测侧新增 evidence-survival 指标,显式报告预算前高相关证据有多少活到了 sources;多部分问题按子目标做最小覆盖检查。fallback 从此是业务路径,要有自己的成功率、重试次数和影响指标,不许再当内部细节藏着。
这里有个更根本的契约问题值得单独说:评测和回答必须消费同一阶段的证据。retrieval evaluator 看 search_results、answer evaluator 看 sources,两边指标各自成立却对不上账,green 的检索指标就完全可能陪着一场产品灾难。要么统一到同一阶段,要么显式报告存活差异——search_results → sources → citations 每一跳的存活率都该是可查的数,证据身份还得在 chunk、hydrate、去重、citation 之间保持稳定,否则「活没活下来」本身就测不准。同理,解析失败、重试、fallback 的 lineage 必须进 trace 和 eval,一个候选是「模型排的名」还是「fallback 留下的默认顺序」,对下游的含义完全不同。
怎么验证这种事不再发生
评审方法本身也被这次事故升级了。成对样本比均值重要——同 dataset、同快照、能逐条对比的那种,我们这次就是把 baseline 和 Hop 每一条的 retrieval、answer、latency、hard slice 并排摆开,断崖在哪一眼就能看见;拒答率和 hard slice 必须和 recall/precision 摆在一起看,一个管「有没有变好」,一个管「有没有更糟」;每条可疑 case 都要能把 search_results → reranker output → 预算后 sources → 最终 answer 串成一条链,断在哪一环一目了然。
诊断顺序也沉淀成了一套 SOP:先确认两个实验的可比性(同 dataset、同样本、能配对),再分清 evaluator 和 answer 各吃哪一阶段的证据,然后把可疑拒答逐条做 trace 级归因——是检索没召回、解析失败、fallback 改了顺序、预算删了证据、还是回答策略本身保守。每一环有自己的嫌疑名单,轮到谁查谁,不让「感觉像检索问题」这种直觉带路。这次就是顺着这条路才摸到了那个多出来的 }——它小得在日志里几乎隐形,却是九条拒答的第一推动力。
顺带一个诚实的注脚:旧实验显示成本 $0,那不能解读成成本优势——没有定价数据的零只是「没算」,不是「便宜」。证据链要求每个数字都有出处,成本也一样。
链条上还有几个该记的边界
多跳扩展本身的设计约束也在这场评审里被重新确认了一遍,顺手记下来:慢 connector 要有自己的 deadline,一个约 30 秒的外部调用不能拖垮整条链;单 connector 失败要隔离,不能把别人的灾难变成自己的拒答;充分性 judge 也要被组件级评测——「继续还是停止」「follow-up 问什么」都是独立决策点,只看最终答案永远调不准它。末跳还硬要生成 follow-up 的,烧的是 judge 成本,留下的是 trace 噪音,深度和候选上限得前置短路。
还有一个容易混淆的边界:检索执行预算、候选上限、最终上下文 token budget 是三个不同的控制面。当时还顺手修过一个相关问题——reranker 输入被字符级截断、漏评项默认给中间分,等于让 reranker 在不完整的证据上做看似完整的判断,后来改成读完整语义块、漏评 fail closed 并可观测。这些和证据存活是同一个家族的病:每一道工序都要么明说好结果,要么明说是坏结果,不许模糊。
回头看,多跳检索的所有优雅设计——references 统一表达跨源边、充分性 judge 控制扩展、RRF 融合多路候选——都只在「证据能活到答案里」的前提下才有意义。检索系统的及格线不在「召回了多少」,在「答案吃到证据了吗」。召回是海选,存活才是决赛,我们那次就是把海选成绩单当成了冠军奖杯。