做 CodeGraph 的 PR 影响分析时,我遇到过一个很经典的「看起来是 A,实际是 B」的故障。用户跑 analyze_impact 分析 PR #6681,结果里挂着两条警告:分析用的是 active graph 而不是 PR head,mapping_confidence=low、analysis_complete=false。第一时间的直觉反应几乎所有人都会一样:索引旧了,图没跟上代码,结果不可信。
这个直觉是错的,而证明它错的过程,比结论本身值钱得多——它直接催生了一套新的 PR 查询契约:所有 PR 先追平目标分支基线,追不上就明说 unavailable,绝不用旧图装 ready。
一个被冤枉的「旧图」
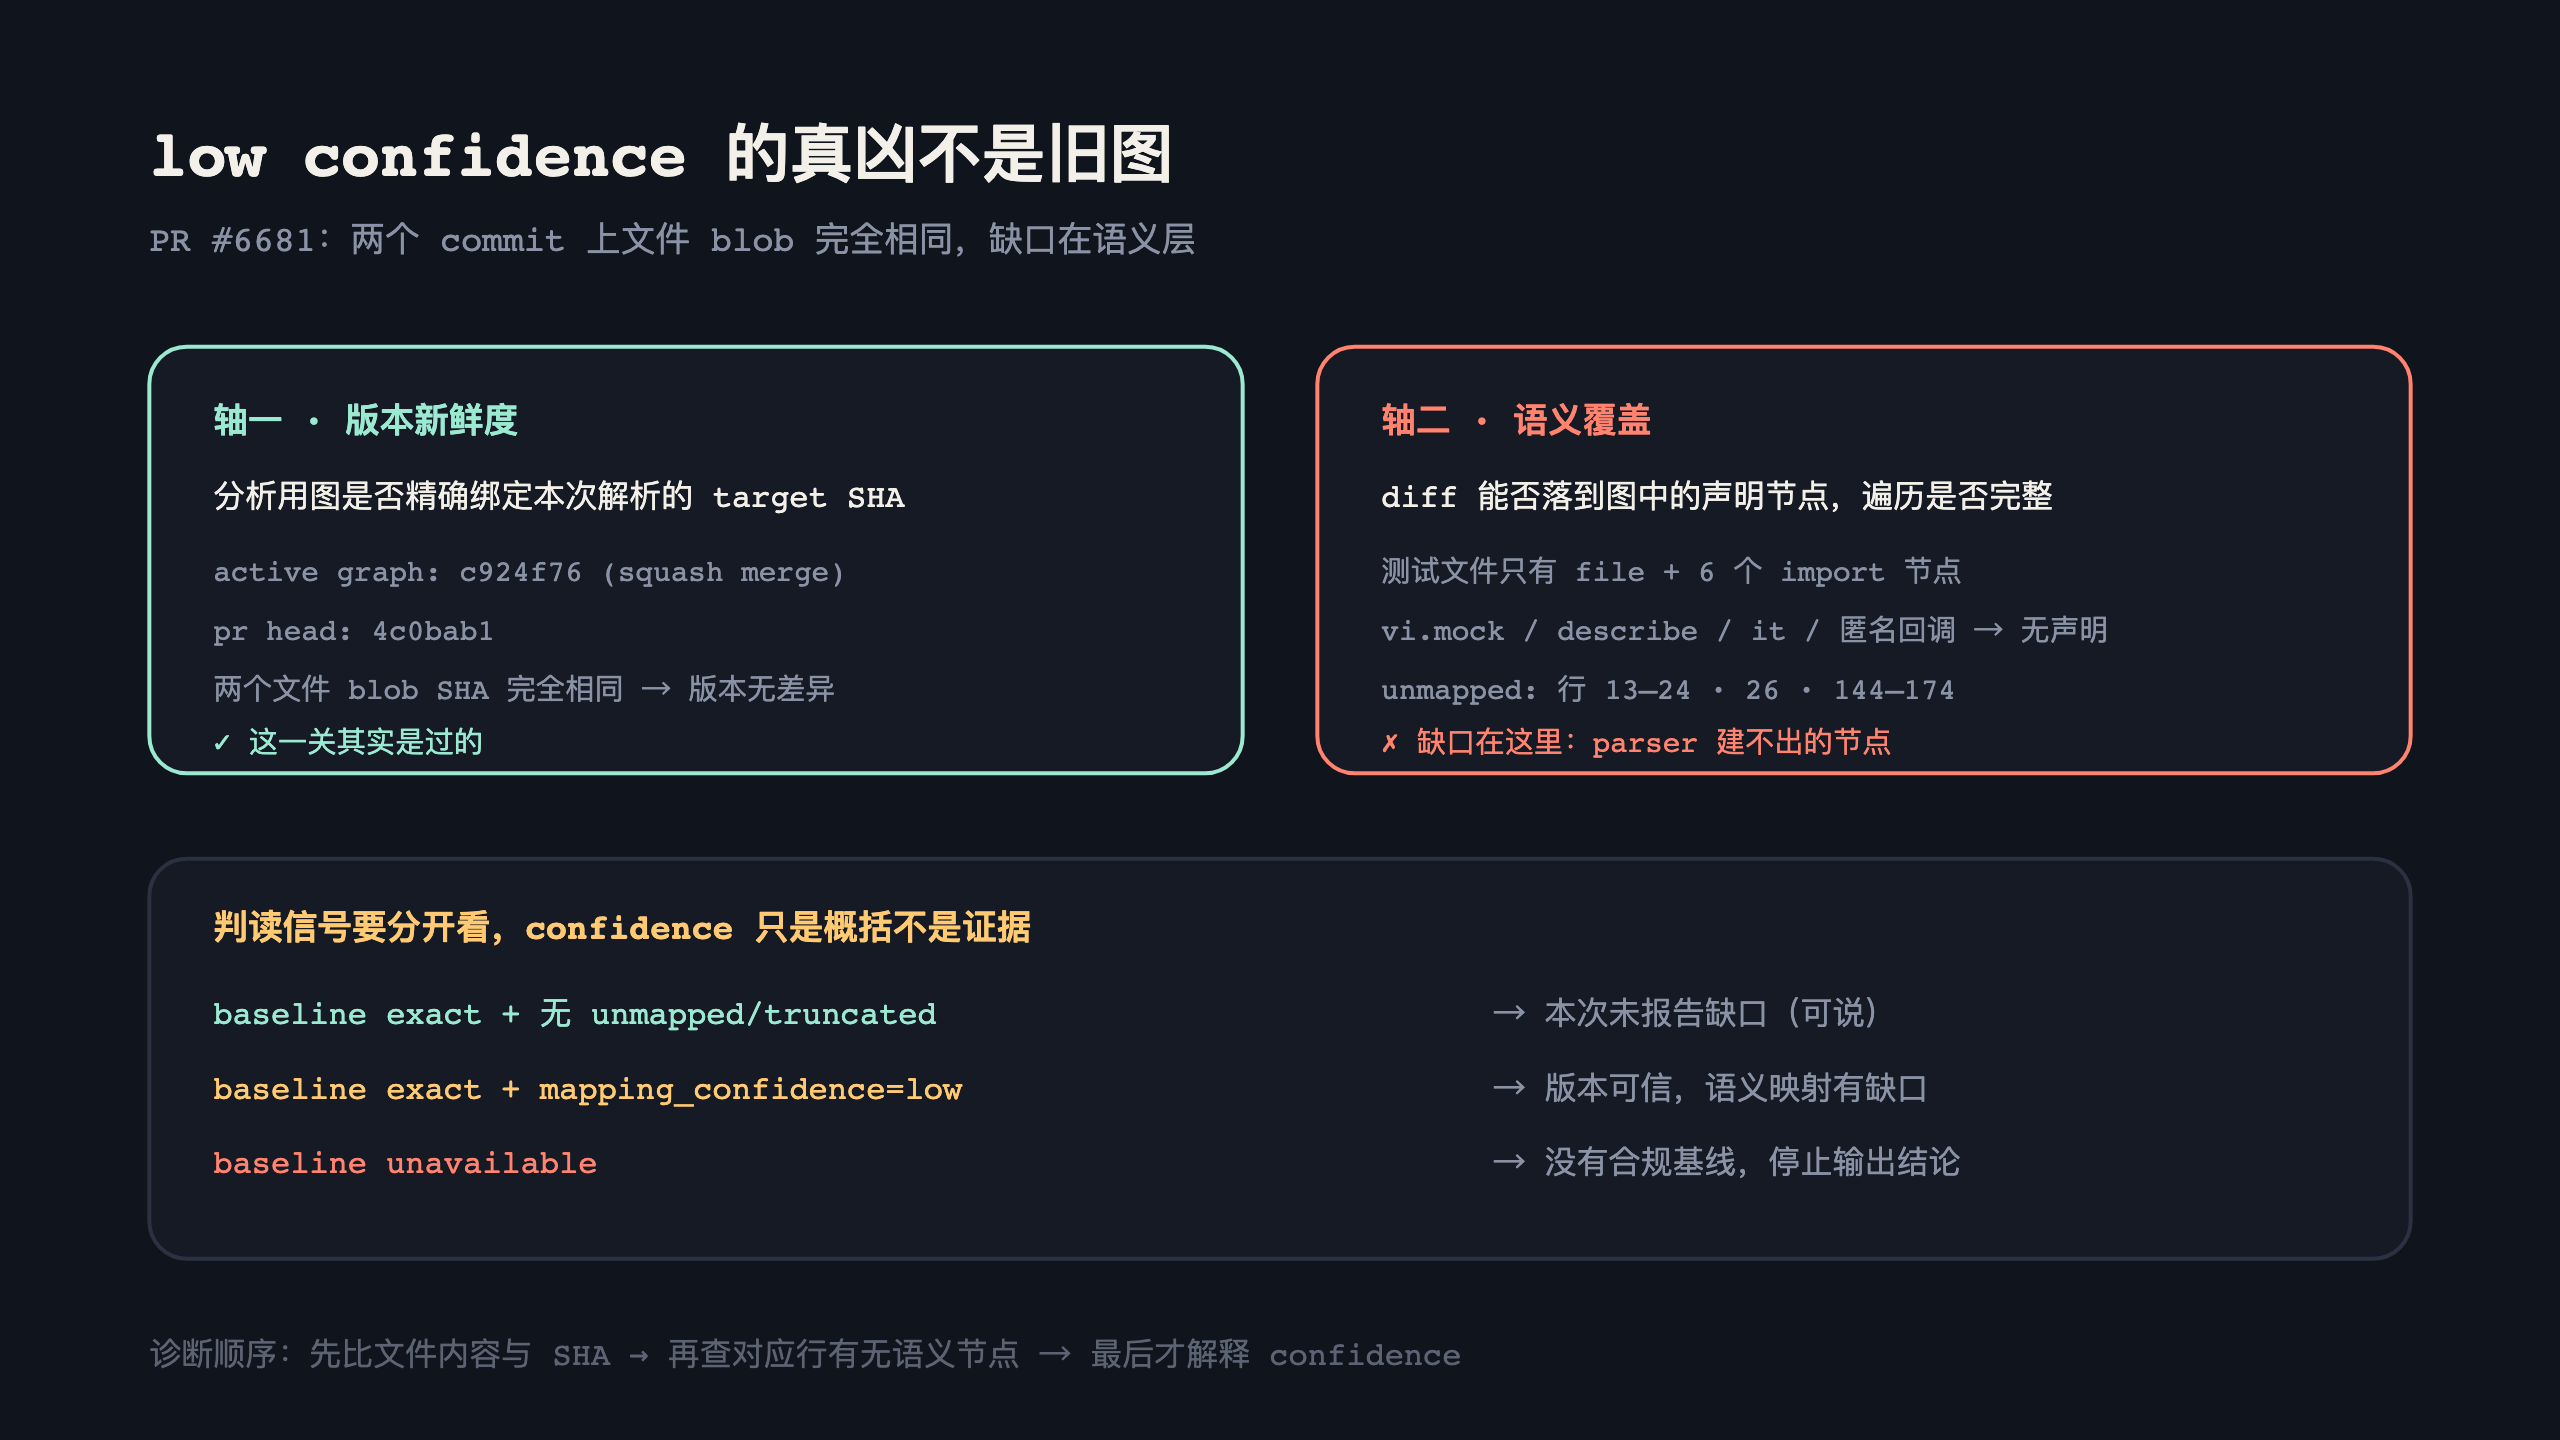
怀疑索引过期,第一反应当然是去对版本。PR 的 head 是 4c0bab1,分析用的 active graph 停在 c924f76——两个 SHA 不一样,看起来实锤了。但等一下,c924f76 是这个 PR squash merge 之后的提交,而 PR #6681 改动的两个文件在这两个 commit 上的 blob SHA 完全相同。也就是说,虽然「图的 SHA」和「PR 的 SHA」对不上,但「图里的代码内容」和「PR 要分析的代码内容」一个字节都不差。版本差异是形式上的,不是实质的。
那 low confidence 哪来的?把 diff 往图上映射的时候发现,三段变更——测试文件的第 13–24 行、26 行、144–174 行——找不到对应的语义节点。原因很朴素:CodeGraph 的 parser 会给函数、方法、组件这类声明建节点,但这个测试文件里只有 file 节点和六个 import 节点,vi.mock、describe、it 和匿名回调压根没长成声明。diff 落在了一片「图上没有器官」的区域,映射器只能举手投降。
所以真凶是语义覆盖缺口,不是版本陈旧。这两个故障长得像双胞胎,药方却完全不同:前者要补 parser 或披露映射缺口,后者要刷新索引。搞混了,你就会拿着「重建索引」的钥匙去开「parser 不支持 Vitest DSL」的门——重建一百次,图里照样没有 describe 节点。
两条轴,各判各的
这次排查逼着我把影响分析的可靠性拆成两条独立的轴:
版本新鲜度——分析用的图是否精确绑定到本次解析出来的目标分支 SHA。这条轴关心的是「图里的代码是不是那段代码」。
语义覆盖——diff 能不能映射到图中的声明节点、遍历有没有被截断、边的方向对不对。这条轴关心的是「图能不能表达你要问的东西」。
混在一起判读的代价很大。把 parser 缺口读成索引过期,会触发一堆没用的重建;反过来把真过期读成「反正 confidence 一直低」,就会让陈旧结果以 ready 的姿态流出去。confidence 这种汇总分数只能告诉你「有缺口」,永远不能告诉你「缺口在哪条轴上」——判读必须看明细:unmapped_changes 逐条列、truncated、omitted_nodes、关系方向分开查。
顺便记几个容易踩的判读陷阱:active_sha != pr_head_sha 不等于索引过期,squash/merge 之后这是正常的分支语义,要比的是目标 SHA 和文件内容;entrypoints=[] 不等于「没有用户影响」,只等于入口识别器没命中;truncated=true 时列出来的影响面是有界子集,写报告时不能装成完整结论。
实操上我给自己留了一套判读顺序,这次就是靠它翻的案:先记录 writer 执行时解析的目标 SHA 和同步后的 active_sha,对不上就先停;再看 analysis_basis 和 pr_graph_sha,确认 open PR 是不是真的用了 head 临时图;然后逐条过 unmapped_changes,区分是新增符号没节点、语言不支持还是解析失败;接着查 truncated 和 omitted_nodes,有截断就不宣称完整;最后对高风险链路用 PR diff、blob SHA、源码搜索或目标测试交叉验证——图是证据源之一,不是唯一证人。共同依赖、同名符号、file 级别的边被误读成调用链,是这个系统里最有迷惑性的假阳性。
收紧契约:所有 PR 先追平,追不上就 unavailable
旧策略还有两个漏洞趁这个机会一起收。一是只在 merged PR 上查询时刷新 active——open PR 的 temporary graph 可能建在旧基线上,等于给新代码做尸检却用了旧尸体;二是刷新失败后允许拿旧图做 best-effort——这就是把「陈旧」包装成「ready」的合法通道。
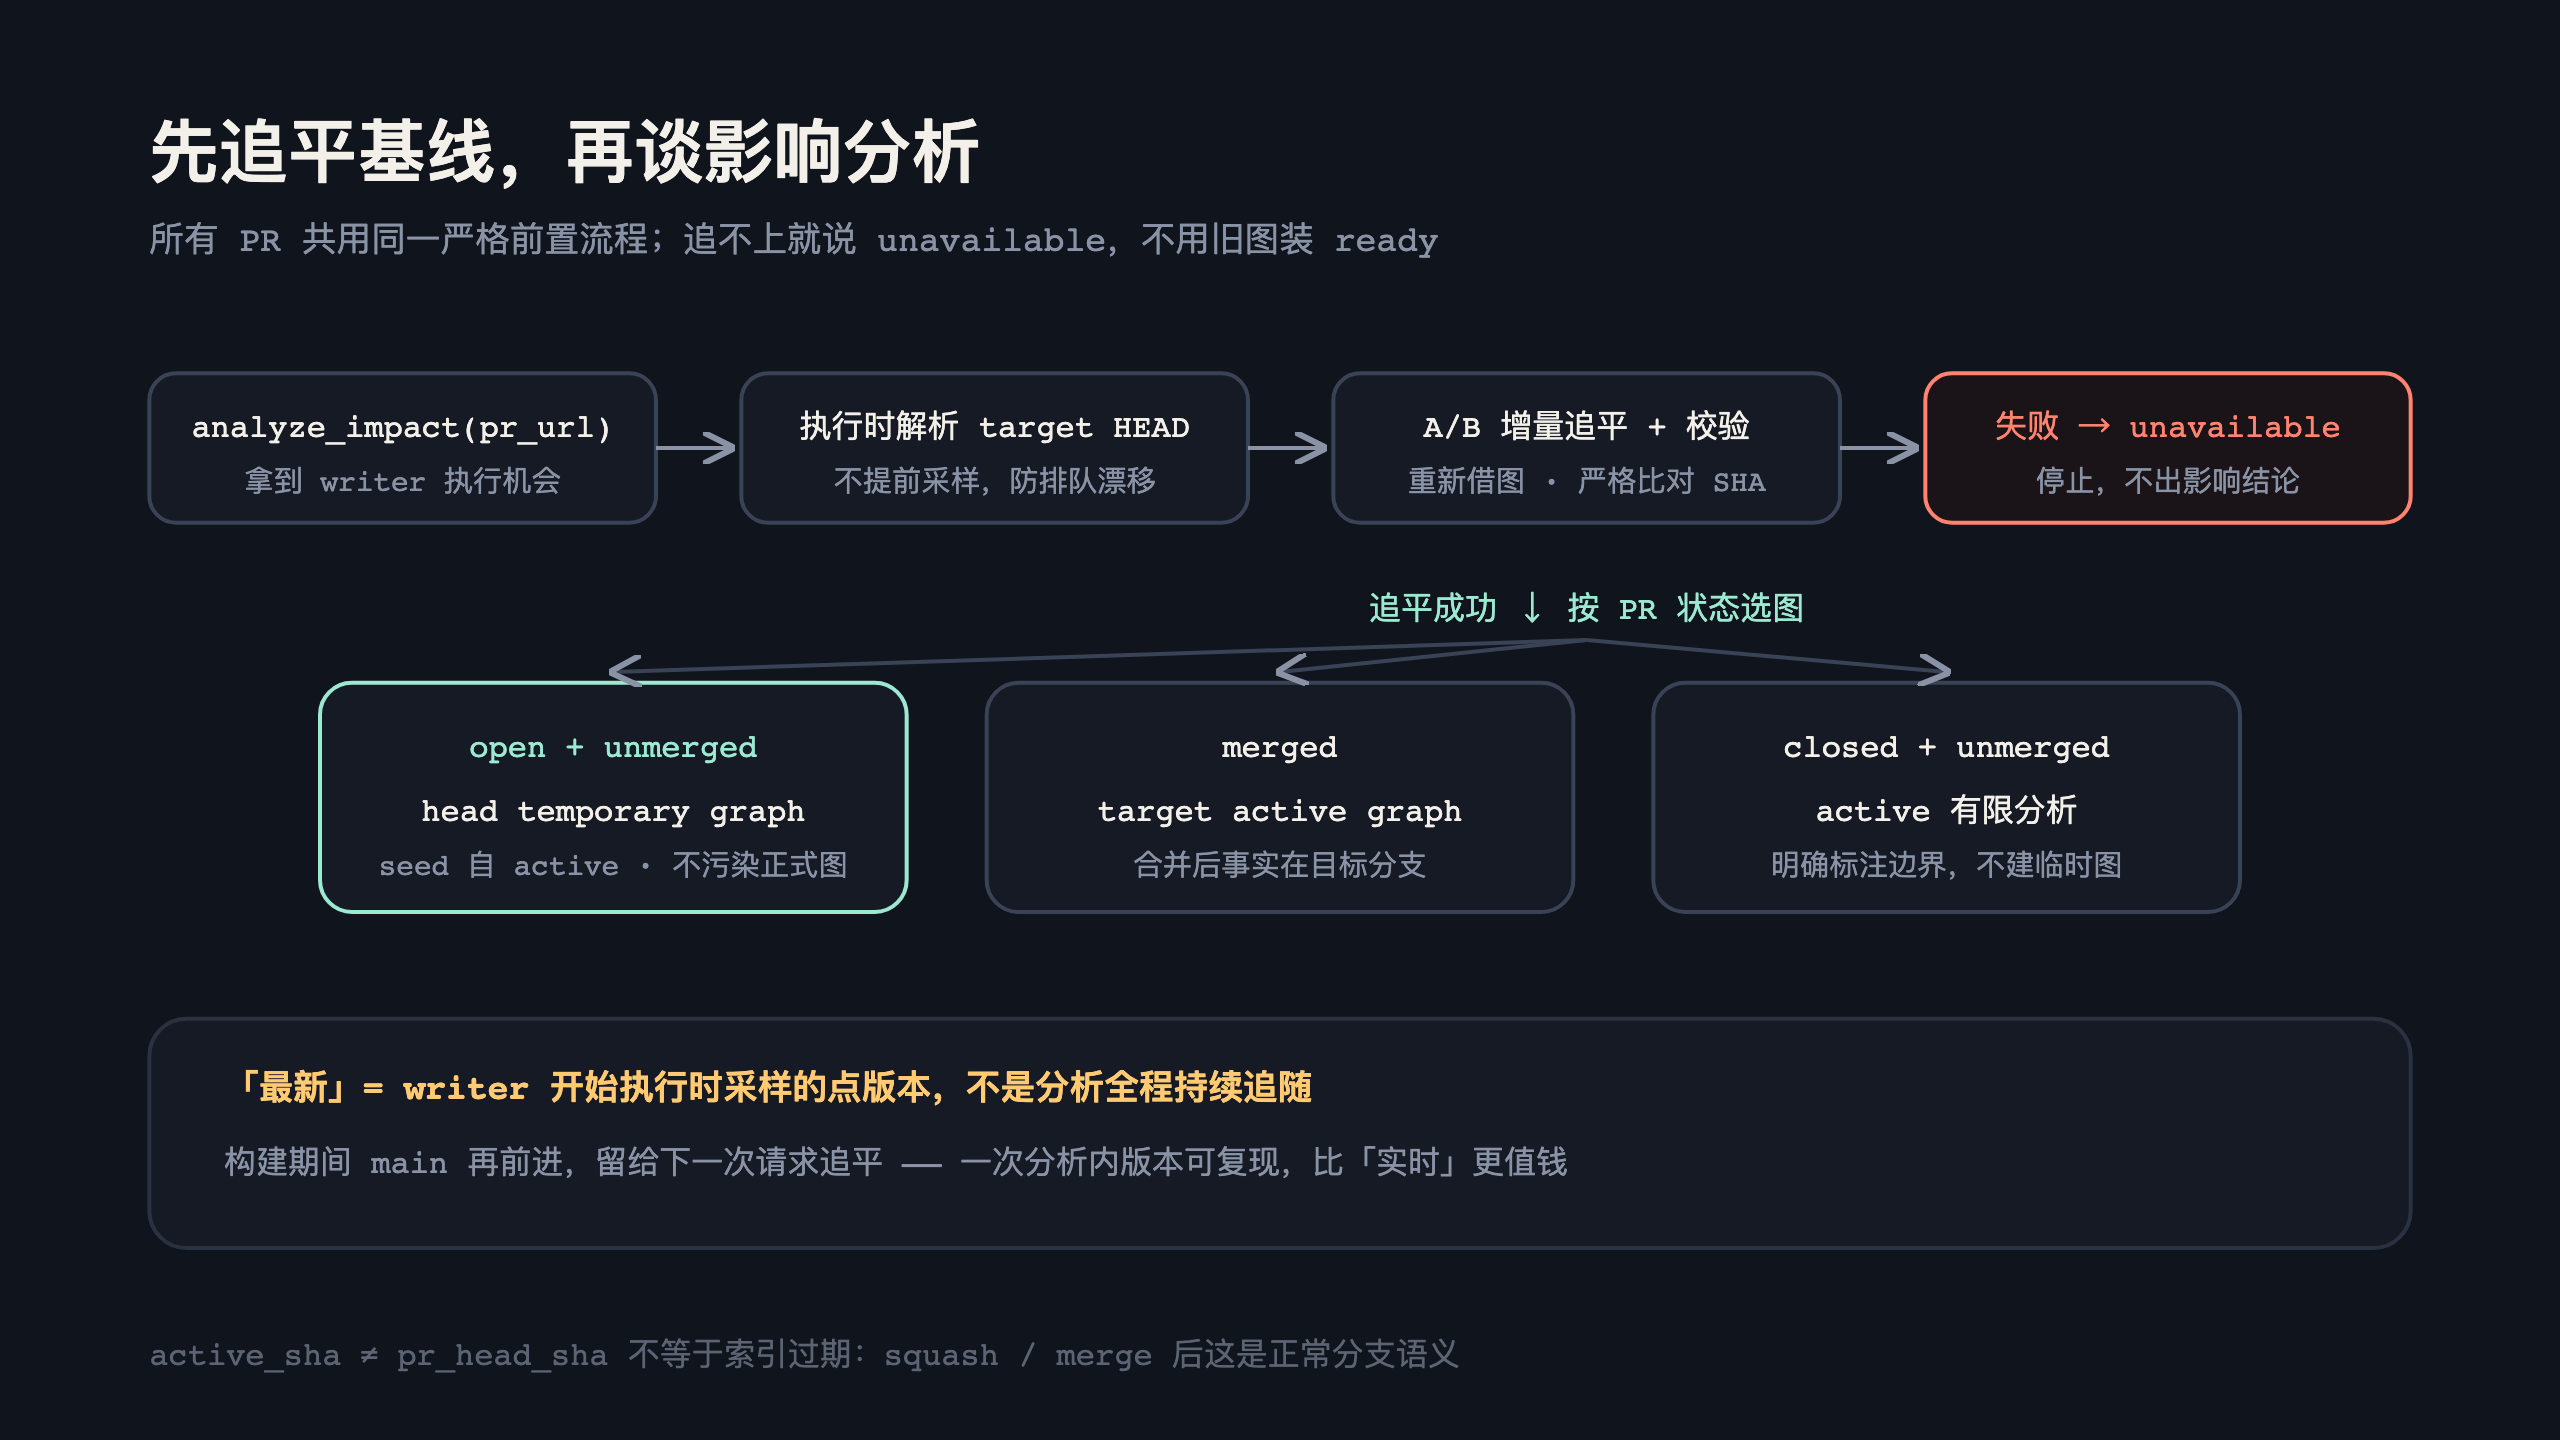
收紧后的契约对所有 PR 一视同仁:先拿到全局 writer queue 的执行机会,在执行那一刻解析目标分支当前 HEAD,active SHA 不同就做正式 A/B 增量同步,然后重新借用图实例、严格校验 SHA 对得上。追平成功才按 PR 状态选图:open 未合并且 head 与 active 不同,构建或复用以 source/repo/head_sha 为身份的 temporary graph;merged PR 直接用已追平的目标分支 active graph;closed 未合并只允许明确标注边界的有限分析。
任何一个环节失败,返回 status=unavailable,停止输出影响结论。
temporary graph 的设计值得展开两句,因为它是「open PR 分析」这个需求的正解,而正解是筛掉三个看起来更省事的方案之后剩下的。原始实现是把 PR diff 映射回 main 的 active 图——快是快,但 PR 新增的函数、路由、调用边在 main 图上根本不存在,映射器只能对「已存在声明的修改」发言,对「PR 引入了什么新东西」集体失声,rename 和迁移也容易漏报。第二个方案是把 pr_index_mode 暴露给调用方自己选,被否了:索引策略是服务端内部实现,泄漏给调用者只会换来误用和甩锅——最终改成服务端按 pr_url 和 PR 状态自动走状态机。第三个方案是借正式 A/B slot 直接索引 PR head,这会污染 main 的 active 还跟正常同步抢写锁,也不行。
剩下的路就是给 PR 建隔离的临时图:从 active .codegraph 复制一份 seed,在独立 detached worktree 对不可变的 head_sha 做增量同步,以 source/repo/head_sha 为缓存身份,同一个 head 重复查询直接复用,PR 有新 push 后 head 变化自然产出新缓存。它跟正式 generation 共用单 writer queue——写图这件事全局串行,资源竞争收敛到一个可控边界——但不进 control store、不切换 active_sha。真实测试里 PR 新增的符号只出现在临时图上,active generation 和 SHA 纹丝不动。隔离的代价是首次构建要进请求延迟,以及临时图需要自己的 TTL 和磁盘治理,这是后面要还的债。
为什么是 fail-closed 而不是 best-effort
这是整个设计里争议最大、也最值得辩护的决定。best-effort 的卖点很直白:可用性高,基线追不上也给个近似答案。但对证据型分析来说,这个卖点恰恰是毒药——调用方拿到一份看着像模像样的影响列表,没法分辨它是「当前基线上的真结论」还是「旧图上的乐观估计」。一个被误读的近似答案,比一个明确的拒绝危险得多。unavailable 至少把「没有合规基线」和「基线合规但语义有缺口」清清楚楚分开了。
与之配套的是点版本一致性:「最新」的定义是 writer 开始执行时采样的目标分支 HEAD,不是分析全程持续追随 main。为什么不追随?因为那样结果不可复现——构建中途 main 又动了,你的分析就变成两个版本的缝合怪。固定一次采样,一次分析内版本稳定、可重放,分支后来的推进留给下一次请求再追平。看起来「不够实时」,实际上这才是能写进报告里的一致性。
还有个细节也容易忽略:目标 SHA 必须在拿到 writer 执行机会时解析,不能在任务入队前提前采样。排队期间分支可能继续前进,提前采样的 SHA 到执行时就已经过期了。「什么时候读版本号」和「读哪个版本号」是一致性设计的一体两面。
Webhook 是油门,不是刹车
这套「查询时追平」的设计背后还有个认识论问题:索引新鲜度到底靠什么保证?直觉答案是事件驱动——push webhook 到了就更新图。但本地开发环境根本收不到 webhook,线上又可能漏事件、乱序或者干脆配置错。PR #6681 那次就是活例:PR 合并之后 active graph 还停在合并前,如果只靠事件,查询就只能读旧基线干等定时任务。
所以最终的模型是把 webhook 降级成低延迟触发器,把一致性兜底放在查询路径上:每次 PR 查询都验证并追平目标分支,事件来了只是让追平的成本更低。这跟「事件管延迟、对账管最终一致」是同一个思想——触发器可以缺席,验证不能缺席。
入口过滤也得跟着收紧:GitHub push 只接受配置分支或 payload 里的 default branch,feature 分支、tag、分支删除事件在进 writer queue 之前直接丢弃。这条规则的教训很具体:不过滤的话,随便一个 feature push 都可能把错误的 SHA 激活成正式图——一致性不仅要防「不更新」,还要防「更新错」。过滤必须发生在昂贵任务入队之前,先索引再判断要不要,等于把炸弹拆开再决定接不接。
代价、验证和没修完的部分
fail-closed 不是免费的。所有 PR 查询都可能触发正式索引排队,首次 temporary 构建会进请求延迟——虽然索引在子进程跑、不阻塞主事件循环,但 writer queue 的容量、超时、取消和降载策略就此变成了 API SLO 的一部分,这部分当时还没有完整定义。临时图也需要 TTL、磁盘配额、跨进程同 head 去重和重启后的 orphan 扫描,进程一重启,磁盘上的临时目录就成了没人认领的孤儿。closed 但未合并的 PR 要不要建临时图,当时也只支持「active 有限分析」的边界,没有完整定义。
验证层面,新契约是有回归保护的:新增的测试明确约束「未合并 PR 刷新失败不得继续使用旧图」,CodeGraph/MCP 定向 18 项测试通过,全量 1,156/1,161 通过——剩下那几个失败是既有 logger 断言和并行下的 worker 超时,单独重跑相关业务测试都过。README 和工具描述也同步到了新契约,防止调用方继续期待旧行为。也就是说策略在本地成立,但生产网络故障和高并发写队列还没被真正打过。
最后留一个我至今存疑的悬案:同一个 PR #6681,早期的分析记录里那三段测试变更明确未映射,较晚的两次分析却显示 unmapped_changes: []、truncated: false、high confidence。版本精确性两个时间点都成立,差异只能来自 CodeGraph/parser 版本或工具 schema 的变化——但来源里没有解释。这件事提醒我:分析结果应该记录 parser/indexer 版本和 generation 元数据,否则同一 PR 跨时间的覆盖度差异根本没法归因。
回头看,这次改造的本质是给证据型系统立了一条行为准则:知道什么时候该说「我不知道」。影响分析这种产品,输出列表很性感,输出 unavailable 很扫兴,但只有后者配得上前者的可信度。一个天天给近似答案的系统,早晚会把「近似」当「准确」卖出去;一个肯明说自己没有合规基线的系统,它的 ready 才真正值钱。会认怂的系统,才配谈可靠。