先交代为什么要验证稳定性。get_document 是给 Agent 消费的工具,调用方会拿同一个 citation 反复取文档——缓存、去重、一致性校验、回归测试,全都建立在「同一引用应该返回同一内容」这个假设上。我做的事说起来很笨:对同一个 citation、用完全相同的参数连调两次 get_document,然后 diff 两次响应。
结果一上来就不平静:两次响应体积差了约 14KB。文档内容变了?检索服务抖了?还是缓存里躺着两份不一样的快照?
答案比三个猜想都无聊,也比三个猜想都有用:差异全部来自两类「本来就不该稳定」的字段。第一次响应里躺着一个 768 维的 summary_embedding,第二次没有——这一项就占了约 14KB;另外 20 个 GCS 图片签名 URL 每次请求都重新签发,签名、签发时间、过期参数全不一样,有效期 3600 秒。把这个可选向量剔掉、把签名参数规范化之后,两份 JSON 的 SHA-256 完全一致:11 个 chunk、正文长度 25239、pagination、references、其余 metadata 全部对得上。
虚惊一场,但这堂课上了一门手艺。
响应字段的三个阶层
这次验证沉淀下来的模型很简单:API 返回值不是均质的,字段分三个阶层。我们做一致性比较时默认把整个响应当成一个平面,但平面上的字段各有各的「该不该稳定」。搞清楚谁该稳定、谁的易变是合法的,是判断「两次返回是不是同一份东西」的前提。
第一层是内容身份:chunks、正文、content_len、pagination、references、稳定 metadata。这些字段变了,才配叫「文档变了」——它们是一致性判据应该覆盖的对象,也是下游做缓存键、去重和回归比对的合法依据。
第二层是检索内部字段:summary_embedding 这类向量。它是检索实现的中间产物,恰好被塞进了响应;服务端给不给、给几次,消费者管不着。它的易变性是合法的,拿它当内容判据就是拿别人的草稿纸对答案。这层字段最气人的地方是长得像内容——它确实是从文档算出来的,但它是给机器用的导数,不是给人看的正文。
第三层是传输临时凭据:签名 URL。它不是「资源的地址」,是「这次下载的通行证」——一小时有效期天然决定了它每次都不一样。把它放进字节级比较,等于质疑「为什么今天和昨天的登机牌不一样」。
分层时有个坑要单独提:规范化规则需要防止误删真正影响内容身份的参数。签名、日期、过期这些查询参数是凭据,但路径、object key、文档 ID 是身份——一刀切的「去掉所有 query 参数」会把身份和凭据一起扔进垃圾桶。白名单思维在这里比黑名单安全:先声明哪些字段参与内容身份,其余的才有资格被规范化。
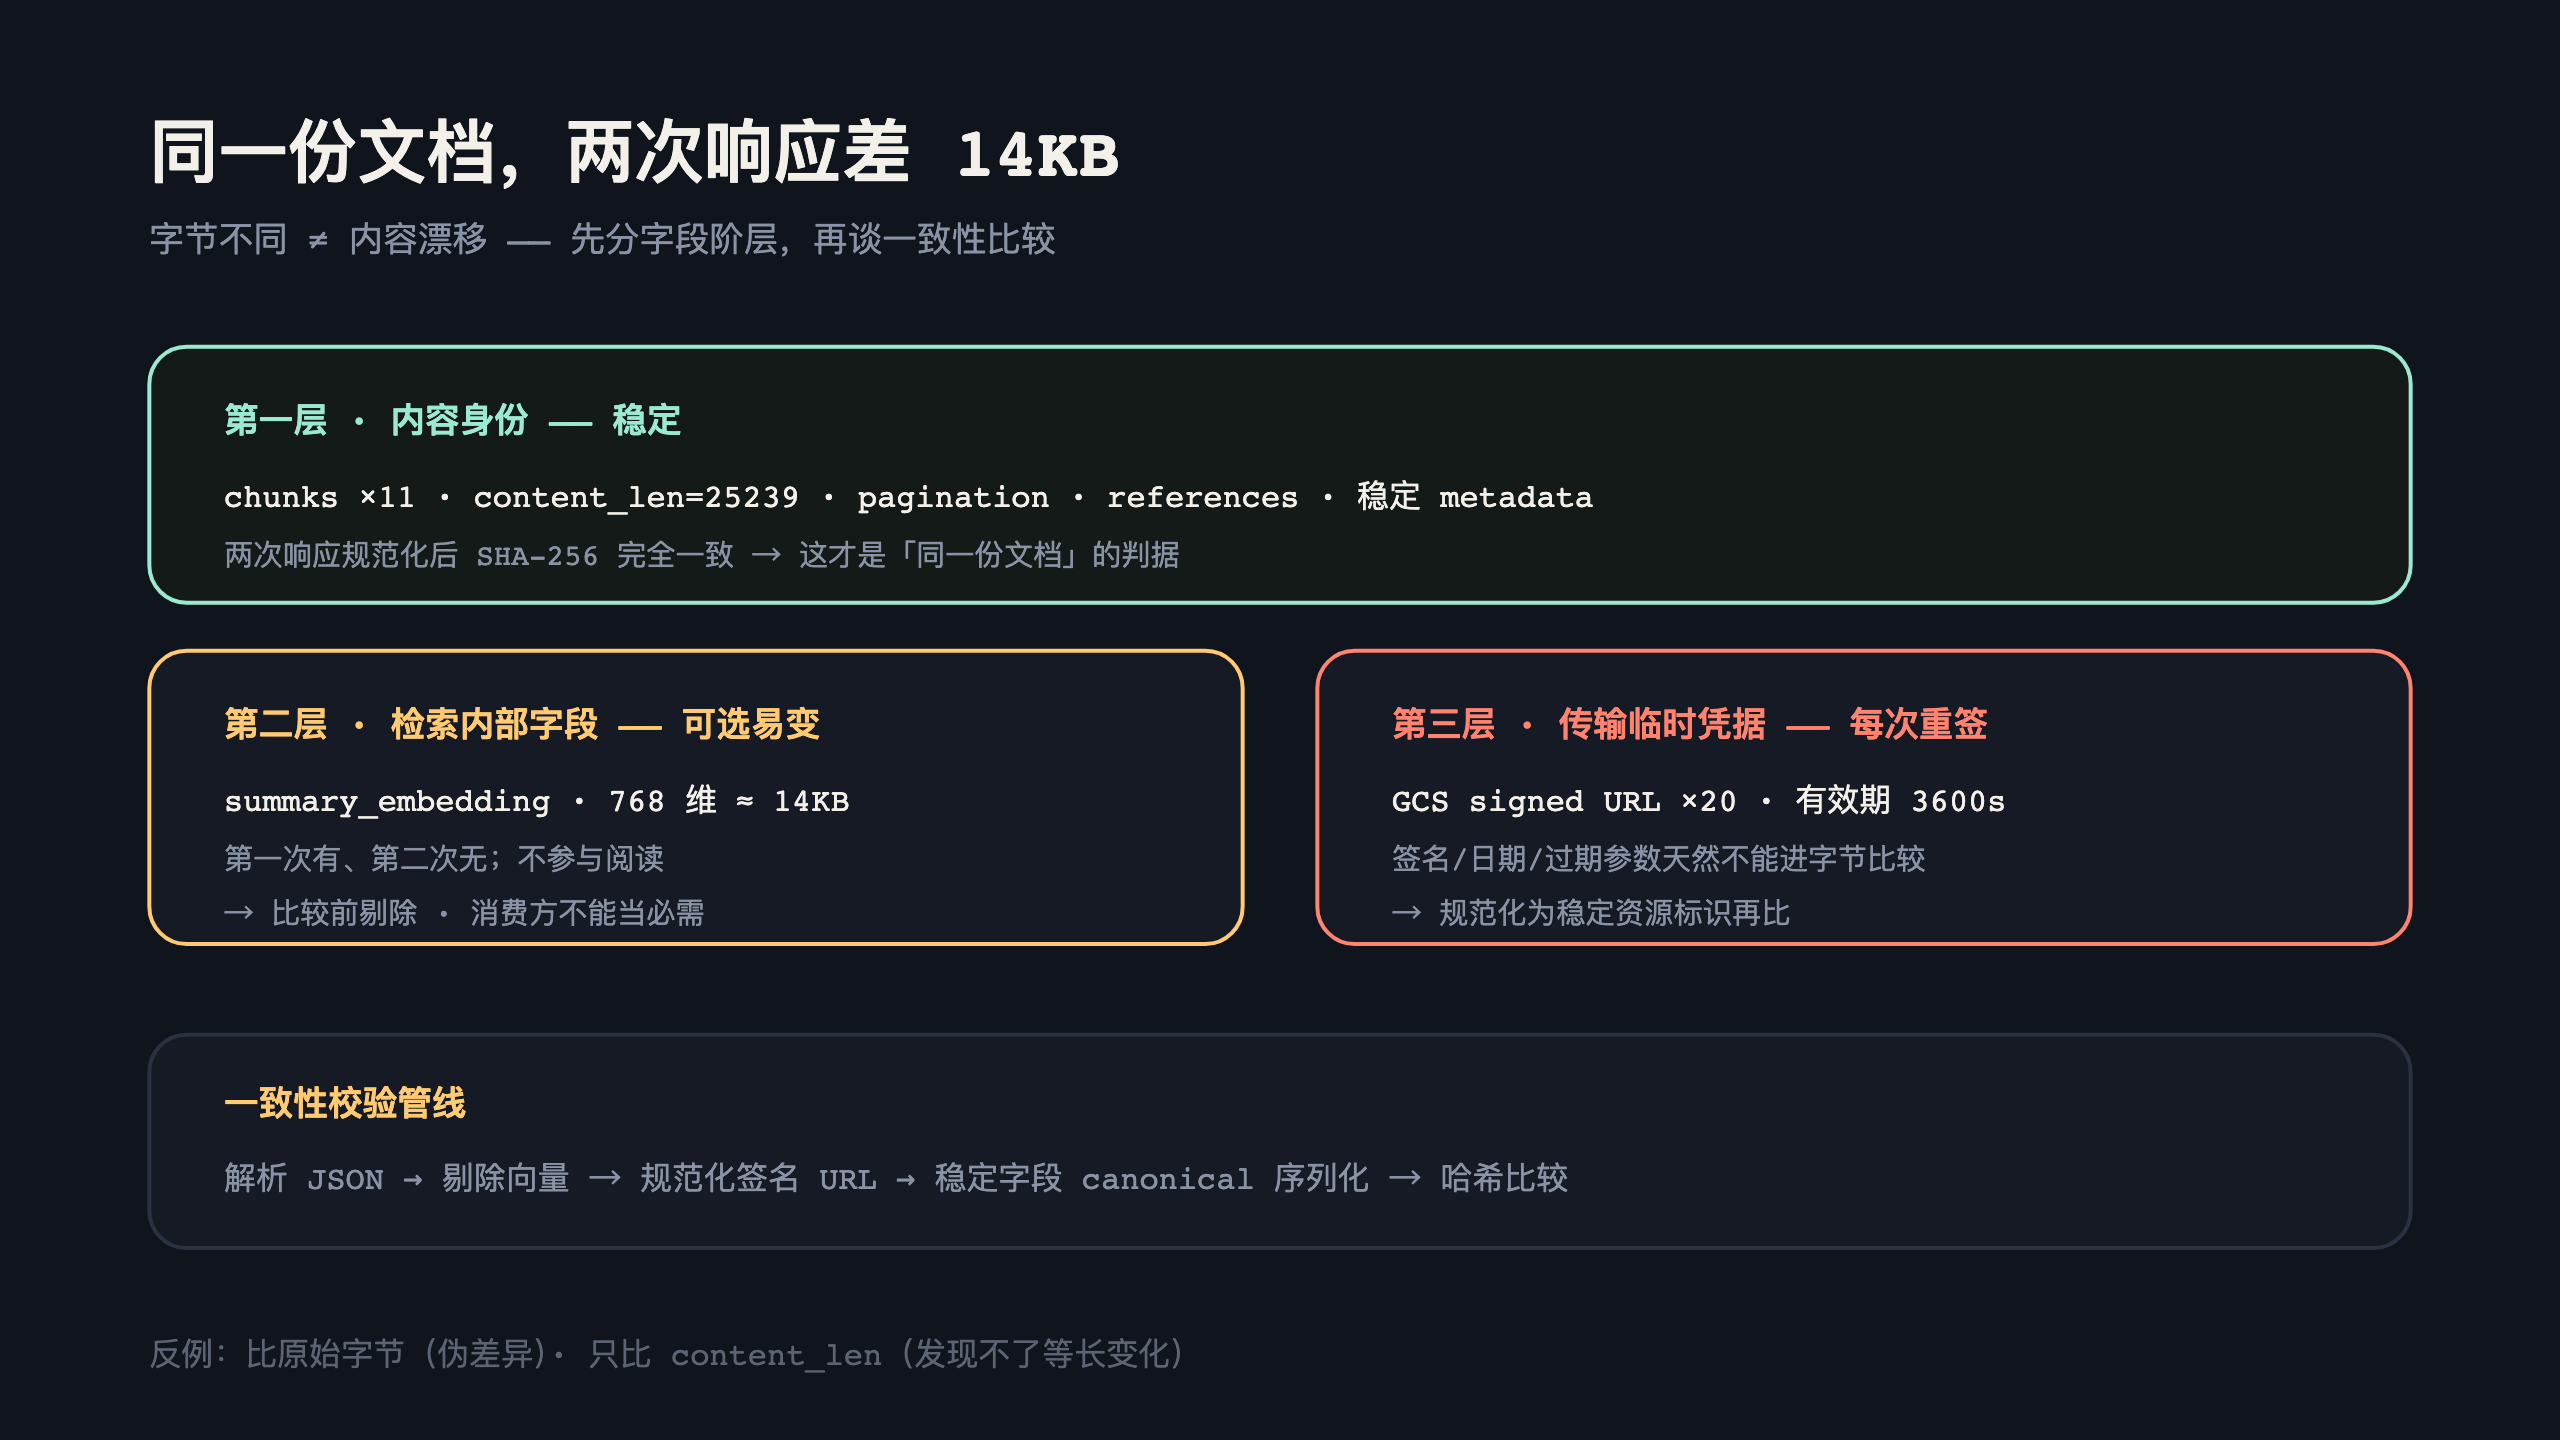
判据清晰了,比较管线就好写了:解析 JSON → 剔除 summary_embedding 之类的内部向量 → 对签名 URL 去掉签名/日期/过期参数(或替换成稳定资源标识)→ 稳定字段做 canonical 序列化 → 算哈希、比对 chunks 数量、分页和引用数。
被否掉的两种比法都有人用:比原始响应字节最简单,但可选向量和签名参数保证每次都给你「文档变了」的假警报;只比 content_len成本最低,但等长替换发现不了——内容是会被同样长度的内容换掉的。规范化后哈希是唯一既可靠又能发现真变化的路,代价是要维护一张字段的白名单/黑名单,这张表本身就是 API 契约的一部分。
这次验证的边界也得说清:它只证明了同一 citation 在内容层稳定,用的是同一节点、相同参数、紧挨着的两次调用。跨节点、缓存失效后、文档真实更新之后的行为都没验,summary_embedding 为什么非确定性出现也没找到服务端原因——它只是个被观测到的事实,不是被解释过的契约。哪天要写正式契约测试,这些就是剩下的作业。
三个顺手牵出来的教训
分层模型一立,几个推论就跟着来了,每个都是真实的消费陷阱。
其一,消费方不能把 summary_embedding 当必需字段。它这次的存在与否是非确定性的,服务端契约也没承诺过。把它写进解析逻辑的硬依赖,就是给未来的自己埋告警——字段缺席在可选语义里不是故障,把它当故障的系统才会故障。
其二,别把高维向量塞进模型上下文。768 维浮点数约 14KB,对检索有意义,对阅读没意义——模型读不懂那一串小数,却要为它们的每一次出现付 token 税。Agent 场景里这笔账更难看:工具结果一旦进上下文,后面每一轮调用都得原样再交一遍门票。Agent-facing 的响应默认就该裁掉这种字段,这不是洁癖,是经济学。
其三,签名 URL 不是资源标识。消费方把带签名的 URL 缓存下来当永久地址,一小时后就会收获一堆 403。永久引用要用稳定标识,临时签名只能活在最终下载的边界上——这句话后来直接催生了一个改造。
这三条合起来其实是一条:穿过模型边界的每个字段都要回答「你凭什么是你」。内容字段拿内容回答,内部字段拿「我是实现细节」回答,凭据拿「我过期了别怪我」回答——答不上来的字段,就是在等一次误用。
顺势改造:把临时凭据移出模型边界
既然签名 URL 是「穿过模型边界的临时凭据」,那它一开始就不该穿过模型边界。原链路是在响应阶段把私有 GCS 对象转成 V4 Signed URL,所以哪怕对象 key 很短,RSA 签名、服务账号 credential、日期、过期时间这一大家子参数也固定产出几百字符——被模型转抄、塞进 Markdown、跨系统传递,长就必然坏。
「长就必然坏」不是修辞。模型转抄时可能截断或改写参数;Markdown 渲染器、Slack、img 标签各自有解析脾气;外部 MCP 客户端和浏览器拿到的 URL 还不能要求带 Authorization 或自定义 header——这意味着凭证必须编码在 URL 本身里,连鉴权方案都被这个约束锁死了。所以问题的位置不在上传或对象命名层,而在「把资源地址当文本交给模型与渠道」的那个边界,光优化 object path 是省不下主要长度的。
改造方案是个无状态资源代理:数据库里落的是稳定的短 public_url,形如 /assets/<signature>/<object-path>;模型和消息链路看到的都是这个短句柄;公开 GET 路由收到请求后重算路径 HMAC,篡改 bucket 或路径直接 404,校验通过才 302 到一个十分钟的 GCS signed URL。bucket 保持私有,真正的签名 URL 只活在一次 redirect 响应里,服务不保存任何映射状态——签名即能力,HMAC 即吊销不了的门票,这是它的本质,后面会讲代价。
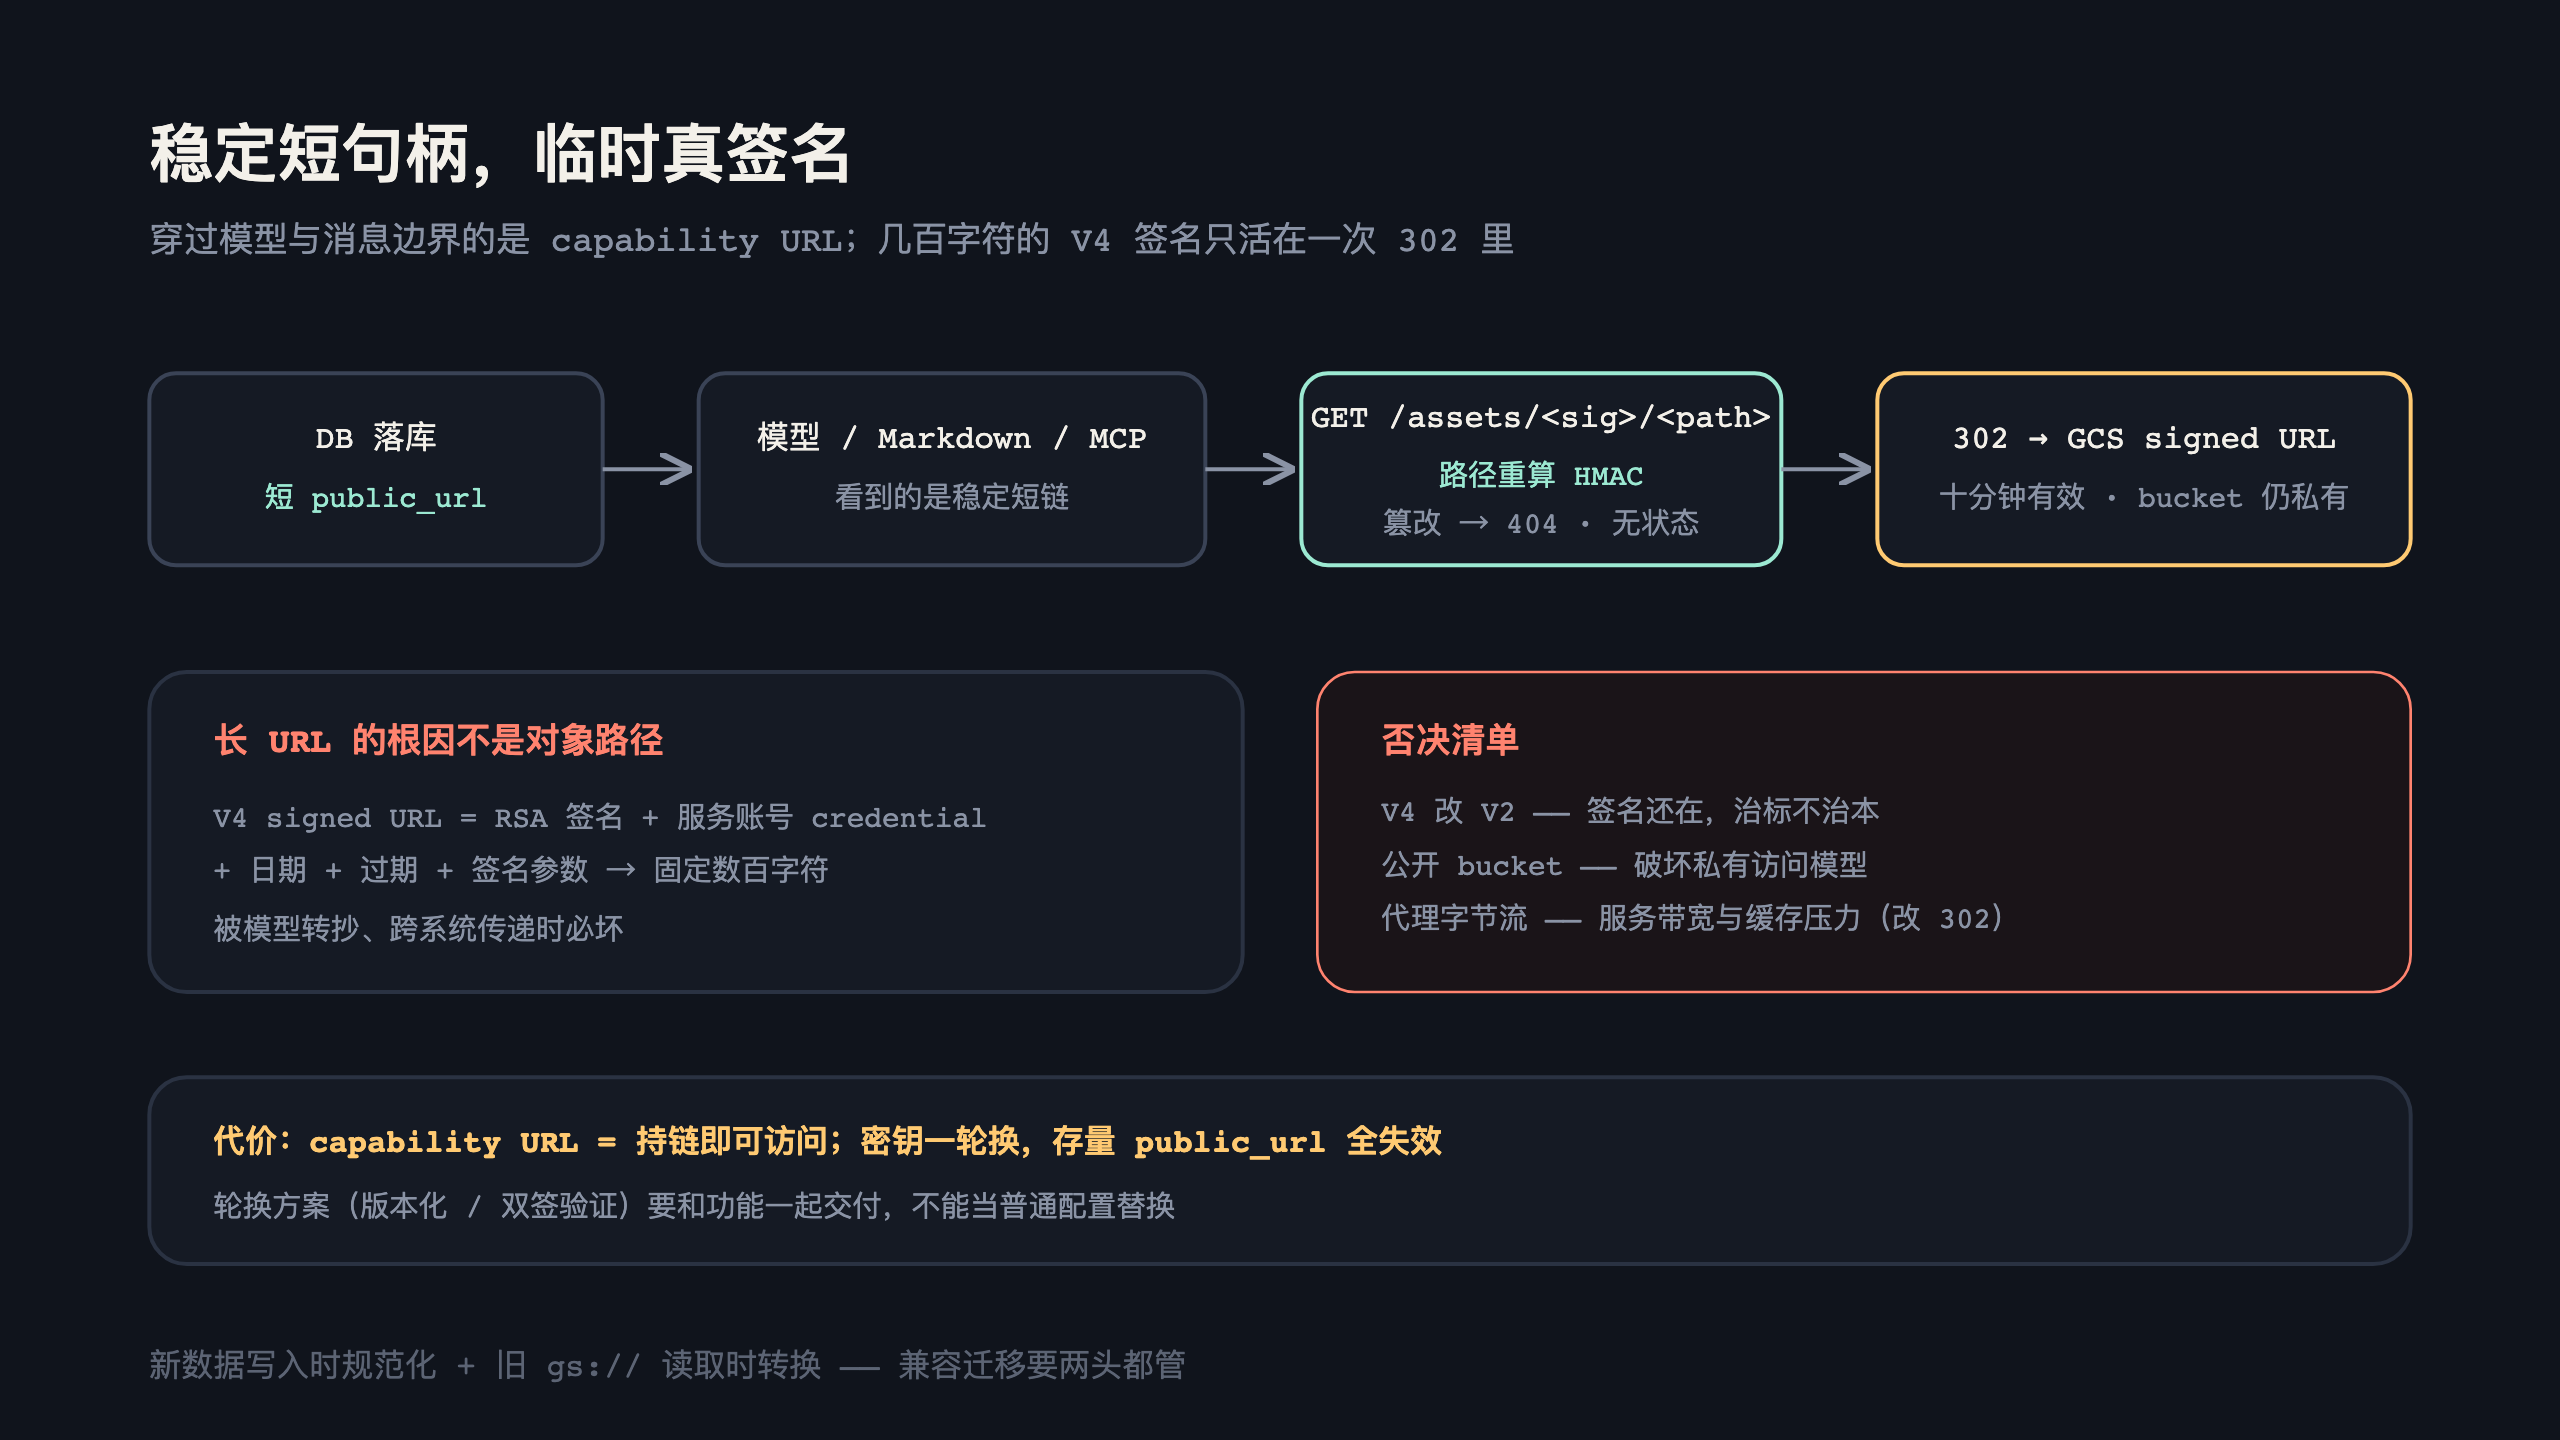
兼容迁移两头都得管:新同步的图片落库就写短 URL(写入时规范化),存量 gs:// 在 answer/search/get-document 返回前统一转换(读取时适配)——只改新数据的话,历史内容照样吐长链接。这个「写入时规范化 + 读取时适配」的双头策略其实是数据迁移的通用姿势:新数据按新契约落地,旧数据在出站的最后一刻换算,既不用停机刷历史库,也不用让消费方分辨新旧两种格式。
选无状态而不是有状态映射,账是这么算的:有状态方案要把「短 ID → 对象」的映射存进数据库或缓存,URL 能更短、还能单条吊销,但从此多了一张表的一致性、清理和容量要管。无状态 HMAC 把校验信息直接编码在 URL 里,服务零存储、水平扩展零协调——代价是放弃了单资源吊销。对一个内部知识检索的图片引用来说,这个交换是划算的,但它是有意识的交换,不是免费的。
被否决的备选也记一下,各有死因:V4 改 V2,签名和 credential 参数还在,治标不治本;公开 bucket,URL 最短但私有访问模型直接报废;服务代理字节流,对客户端隐藏 GCS 最彻底,但所有图片流量都过服务带宽,被 302 替代;有状态短 ID 映射,URL 能更短还支持单条吊销,但要引入数据库、缓存和清理状态——为了一个 URL 多养一张表,不值;只覆盖新数据,迁移最不完整。
它的代价也要写明白:capability URL 本质是 bearer 凭证,持链即可访问,所以路由不能再叠加任何依赖自定义 header 的鉴权——URL 泄露出去了,在密钥轮换之前谁拿着都能用,会话里也没设计单资源吊销。签名密钥复用现有配置,意味着轮换密钥会让所有存量 public_url 失效——密钥版本化或双签验证的轮换方案必须作为功能的一部分交付,不能当普通配置替换,否则第一次换密钥就是全站图片 404 的纪念日。
安全与观测是配套的:这个路由没有用户认证,安全性完全押在 HMAC 校验上,所以 302 成功率、签名校验失败率、GCS 临时签名错误率都得进监控——签名失败异常升高,要么是密钥漂了,要么是有人在试路径。当时实现、篡改拒绝、新旧数据转换都有测试覆盖,1124 个测试通过,commit ba1f04a 推了 main;CDN/浏览器缓存行为、重定向延迟和高并发下的签名配额这些生产指标,是后面要还的债。
收尾:字段分级是契约设计的基本功
回头看,这两个改动是同一门手艺的两面:get_document 的一致性验证教会我「哪些字段有权定义同一份文档」,GCS 代理回答的是「易变字段应该住在哪一层」。判据要建在稳定层上,凭据要留在传输层,内部字段要敢于不给——API 响应不是数据库 dump,每个字段穿过边界之前,都该问一句它属于哪个阶层。
这个模型对下游还有个实际馈赠:一致性校验、缓存键、回归测试从此都有了明确的字段清单,不用再跟「每次都不一样的字节」搏斗。而对服务端来说,字段分级是一堵自警墙——往响应里加新字段之前先想清楚它归哪层,归错层的字段早晚会变成别人判据里的噪音,或者别人缓存里的定时炸弹。
下次再看到「两次返回不一样」,先别急着报内容漂移——把响应拆成三个阶层过一遍筛子,看看那 14KB 里住的是谁。